Qwen-Image 2.1 im vollständigen Leitfaden: Bildgenerierung, Bearbeitung und transparente PNGs mit 7B – 100 Reddit-Beispiele
Am 20. September 2026 veröffentlichte das Qwen-Team das Bildmodell „Qwen-Image 2.1“. Seine wichtigste Eigenschaft: Text-zu-Bild-Generierung, Bearbeitung mit Referenzbildern, Kombination mehrerer Bilder, lokale Bearbeitung sowie Generierung und Bearbeitung mit transparentem Hintergrund (RGBA) sind in einem Modell vereint. Der Bildgenerator umfasst 7 Milliarden Parameter. Statt ausschließlich auf immer größere Modelle zu setzen, zielt Qwen auf eine handhabbare Größe und effiziente Verarbeitung auch in lokalen Umgebungen.
Kurz gesagt ist Qwen-Image 2.1 weniger ein Modell, das aus dem Nichts das perfekte Einzelbild erzeugt, sondern vor allem ein spannendes Produktionsmodell: Es verändert vorhandene Bilder nicht zu stark, kombiniert mehrere Materialien und passt gezielt einzelne Bereiche an. Auch auf Reddit konzentriert sich das Lob auf Bearbeitung, Charakterkonsistenz, Produkt-Compositing, Outpainting und transparente Assets. Gleichzeitig gibt es klare Berichte über Schwächen bei Händen, Gesichtern in der Ferne, Detailrauschen, abgesoffenen Schwarztönen, Restaurierung alter Fotos und Anime-Stilen.
Dieser Artikel ordnet alle Funktionen anhand offizieller Informationen ein und fasst nach Auswertung wichtiger Reddit-Threads die diskutierten Generierungs- und Bearbeitungstests als „100 Beispiele“ zusammen. Die 100 Punkte bedeuten nicht 100 unabhängige Beiträge, sondern zählen einzelne Bildthemen und Bearbeitungsschritte, die in mehreren beliebten Posts, Galerien und Workflows getestet wurden.
Was ist Qwen-Image 2.1?
Qwen-Image 2.1 ist ein integriertes Bildgenerierungs- und Bearbeitungsmodell der Qwen-Familie. Laut offizieller Beschreibung verwendet der Generierungsteil einen Single-Stream-DiT mit 32 Schichten und 7 Milliarden Parametern. Qwen3-VL 8B überführt Textanweisungen und Bedingungsbilder in eine gemeinsame Repräsentation; ein RGBA-VAE mit 64 Kanälen übernimmt 16-fache räumliche Kompression und native Transparenz.
Das Team nennt vier zentrale Verbesserungen:
- Klein und effizient: Mixed-Grain Attention und die Wiederverwendung des Prefix-KV-Cache verbessern das Verhältnis von Qualität zu Rechenaufwand.
- Einheitliche Generierung und Bearbeitung: Normale und transparente Bilder lassen sich mit demselben Modell generieren und bearbeiten.
- Vielseitige Bearbeitung: Bis zu zehn Referenzbilder, lokale Vorgaben per Maske oder Zeichnung sowie die Erhaltung der Identität von Personen und Produkten werden unterstützt.
- Textur und Ästhetik: Typografie, Porträtbeleuchtung und feine Texturen wurden verbessert.
Quellen: offizieller Qwen-Blog, offizielles GitHub, Diffusers-Dokumentation
Alle Funktionen im Überblick
1. Text-zu-Bild-Generierung
Das Modell unterstützt herkömmliches Text-to-Image. Neben kurzen Vorgaben kann es über Qwen3-VL auch lange natürlichsprachliche Anweisungen und komplexe Beschreibungen mit Komposition, Licht, Materialien, Vorder- und Hintergrund sowie Textelementen verarbeiten. Die offiziellen Beispiele verwenden grundsätzlich 40 Schritte; in der Community werden jedoch auch beschleunigende LoRAs mit 8 bis 16 Schritten und qualitätsorientierte Einstellungen mit 30 bis 40 Schritten getestet.
2. Bildbearbeitung
Eingabebild und Textanweisung können gemeinsam übergeben werden, um Farbe, Wetter, Hintergrund, Kleidung, Pose, Material, Beleuchtung oder Kamerawinkel zu verändern. Auf Reddit vertreten viele die Ansicht, dass die Bearbeitung stärker ist als reines T2I.
3. Bis zu zehn Referenzbilder
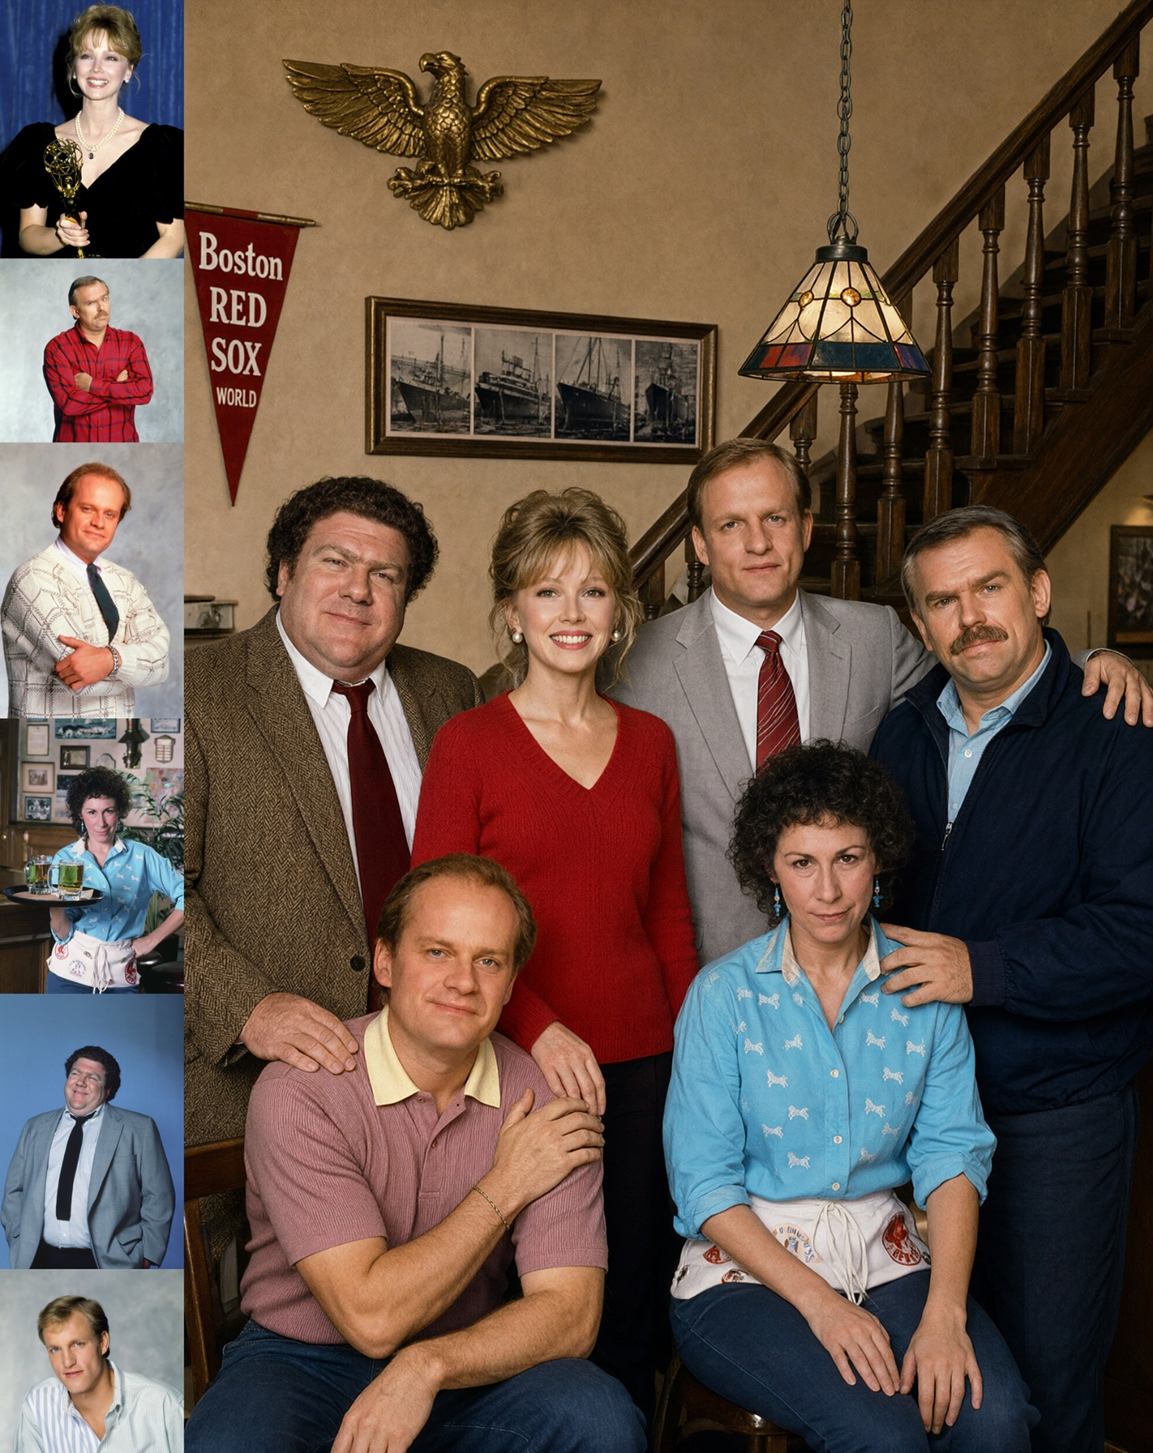
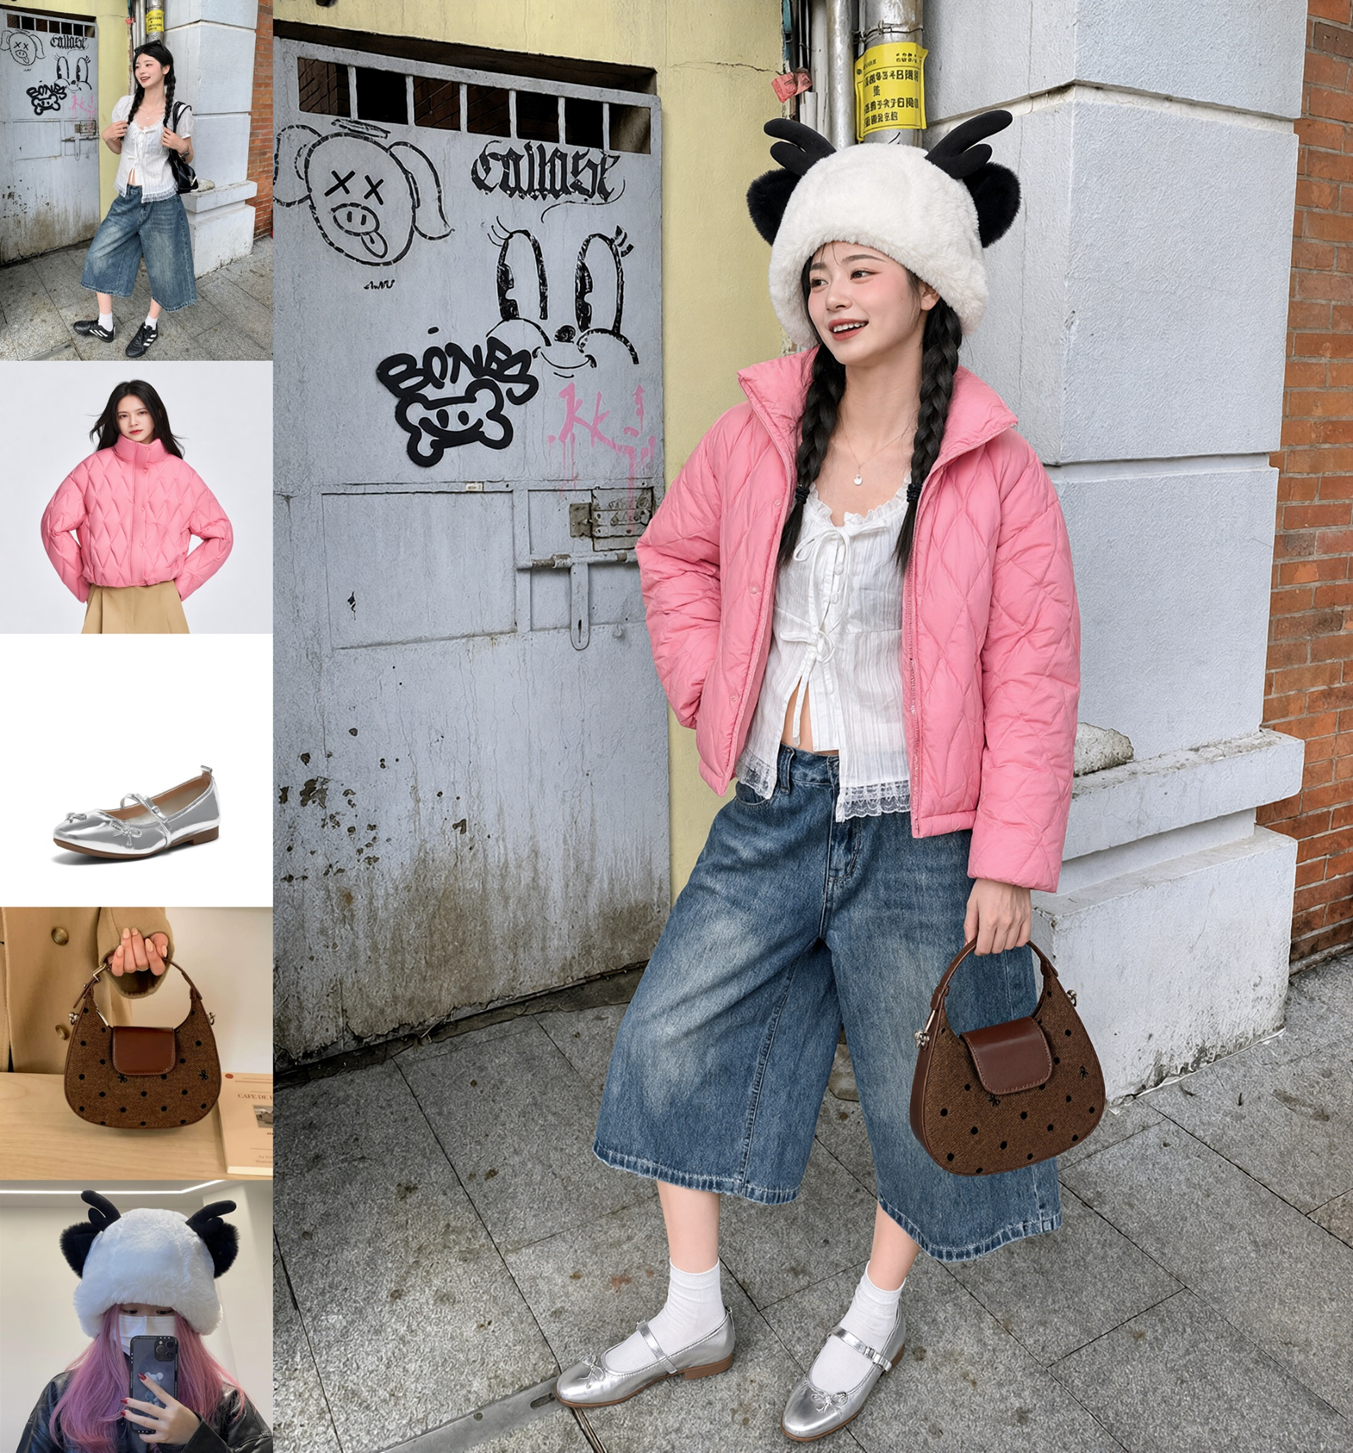
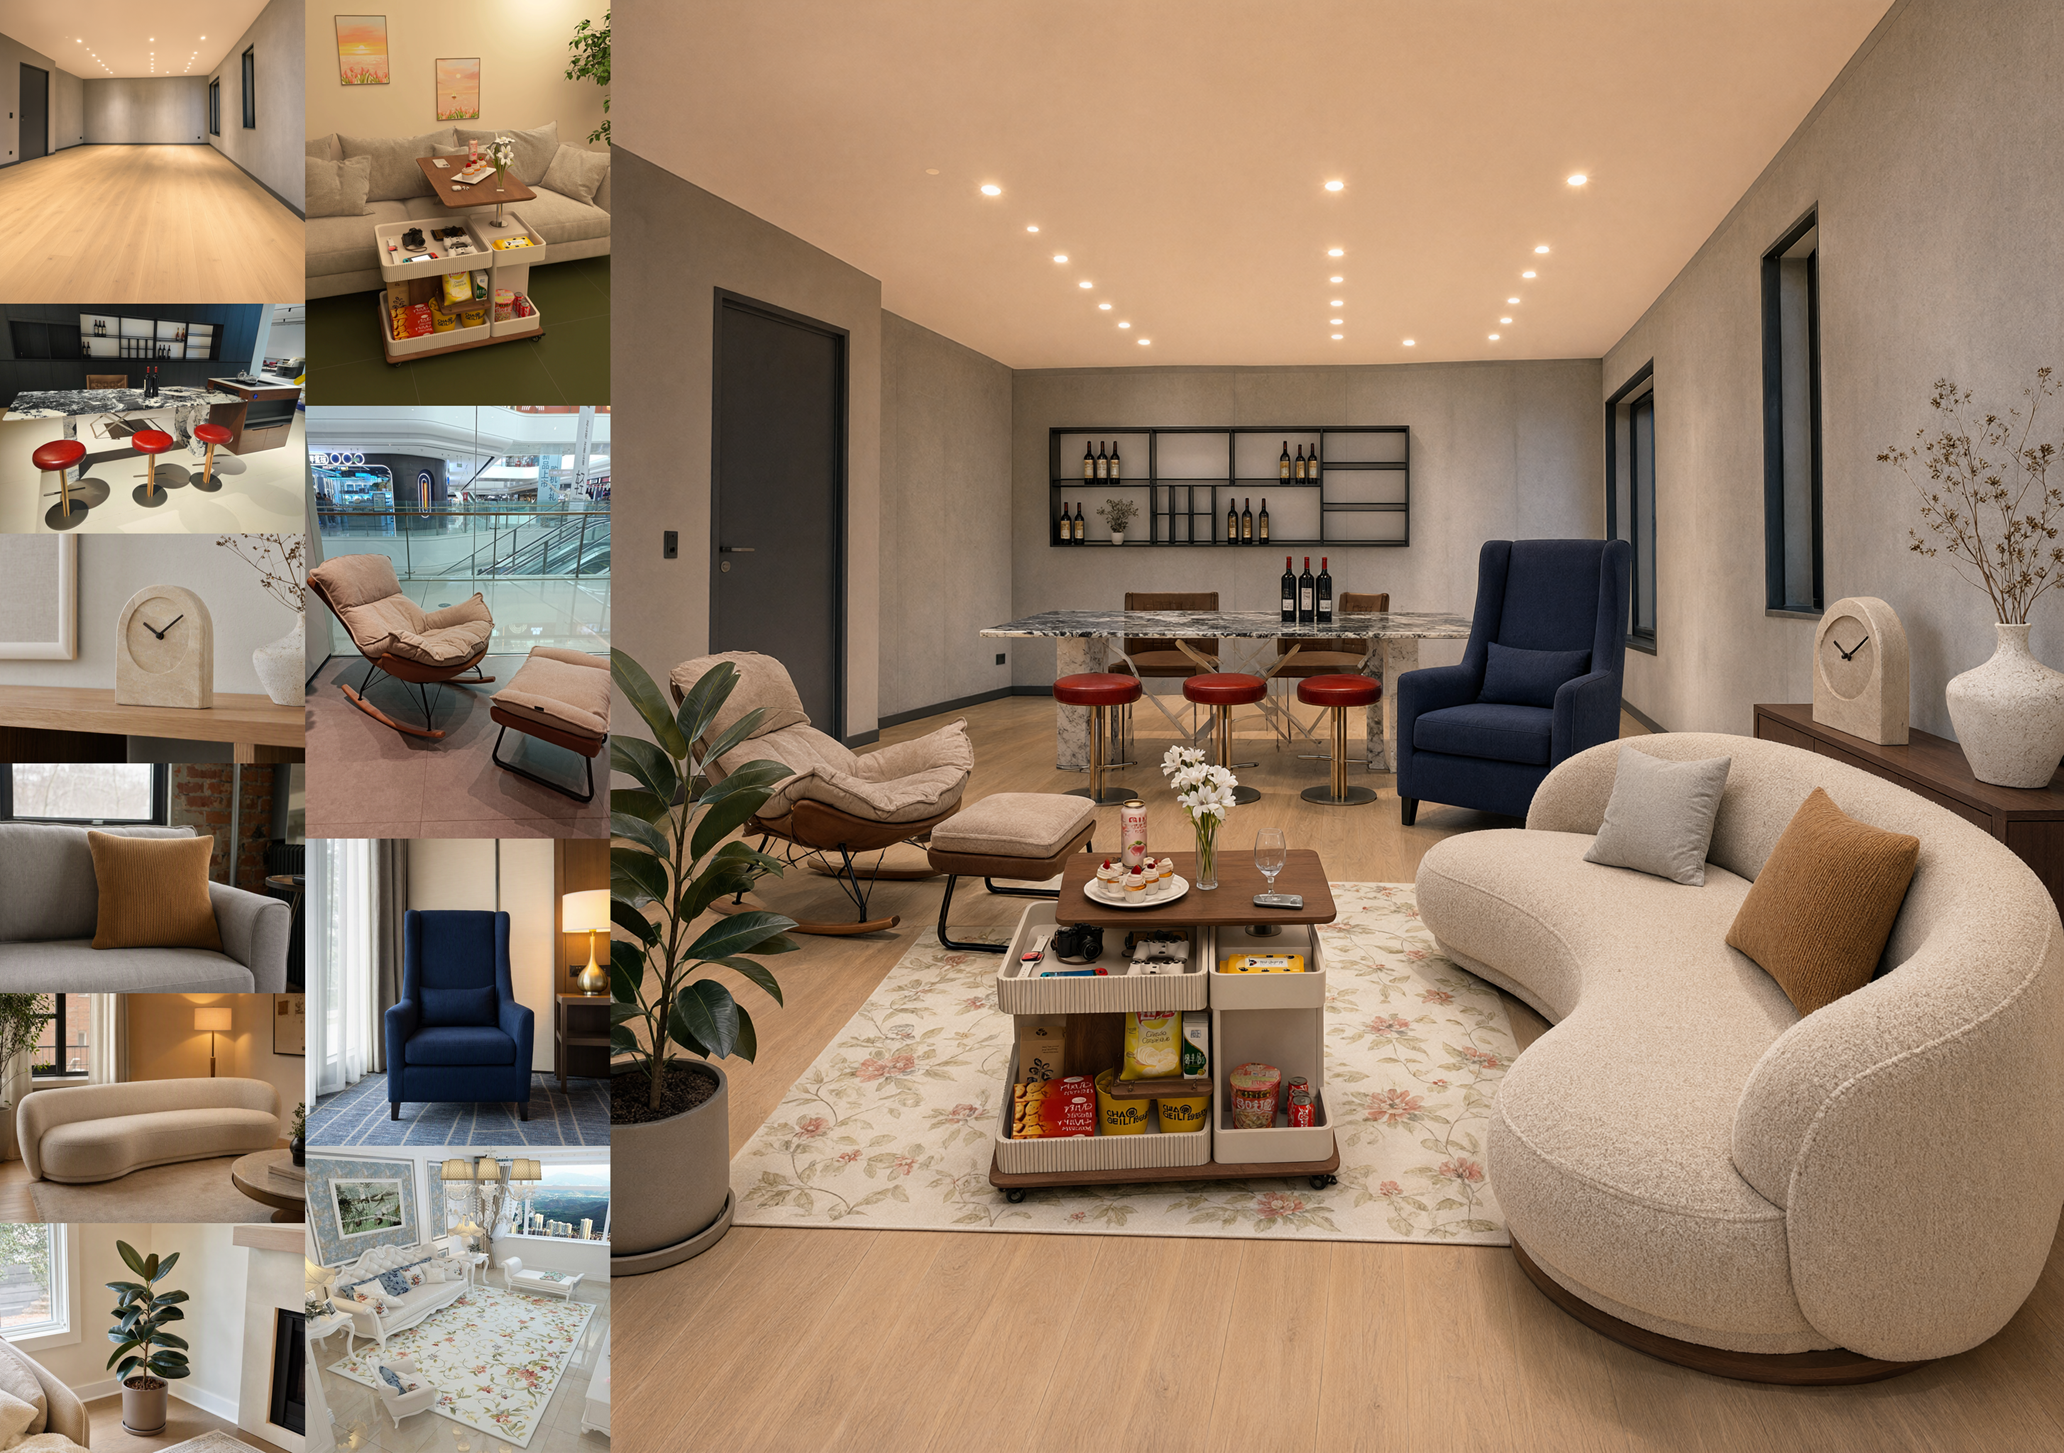
Personen, Kleidung, Schuhe, Taschen, Hüte, Möbel und Produkte können aus getrennten Bildern übernommen und in einer Szene zusammengeführt werden. Offizielle Beispiele zeigen ein Gruppenfoto aus sechs Gesichtern, virtuelles Anprobieren mit fünf Materialien und die Raumgestaltung mit zehn Möbelstücken. Community-Berichten zufolge nehmen mit der Zahl der Referenzen jedoch auch widersprüchliche Vorgaben und die Vermischung von Eigenschaften zu.
4. Natives RGBA und transparente Hintergründe
Statt lediglich Hintergründe nachträglich zu entfernen, kann das Modell Bilder mit Transparenzkanal direkt generieren. Das eignet sich zum Freistellen von Motiven aus Fotos, zur Bearbeitung transparenter Elemente und zum Erstellen von Assets mit mehreren transparenten Bestandteilen.
5. Lokale Bearbeitung und Maskenbearbeitung
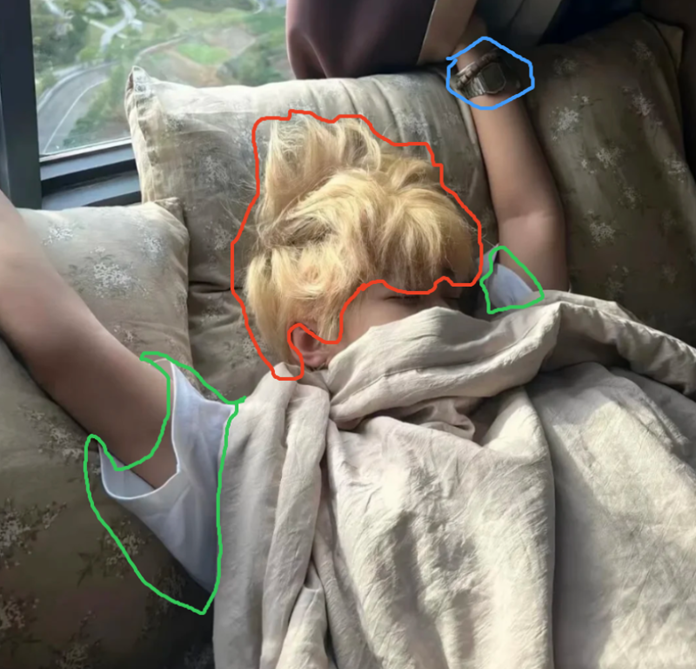
Änderungsbereiche lassen sich durch Kreise, eingefärbte Anmerkungen oder separate Masken festlegen. In ComfyUI wird etwa direkt auf ein Bild gemalt und mit Anweisungen wie „Ändere nur die Kleidung im roten Bereich“ gearbeitet. In Kombination mit LanPaint kann nicht nur die Farbe, sondern auch der Alphakanal selbst inpainted werden.
6. Outpainting
Die Leinwand lässt sich nach oben, unten, links oder rechts erweitern; freie Bereiche werden passend zum Kontext des Originalbilds ergänzt. Reddit-Berichte heben hervor, dass mehrere Richtungen gleichzeitig erweitert werden können und dies schneller als herkömmliche Spezial-Workflows sei.
7. Identitätserhalt
Im Mittelpunkt stehen Anwendungen, bei denen Gesicht, Kleidung und Pose einer Person oder Form und Markenelemente eines Produkts erhalten bleiben, während nur Hintergrund oder einzelne Attribute geändert werden. Besonders bei Charakterbögen und zusammenhängenden Einstellungen ist das Thema beliebt; bei extremen Blickwinkeln, starken Gesichtsausdrücken und langen Sequenzen sollte Drift jedoch geprüft werden.
8. Textdarstellung und Design
Unterstützt werden Bilder mit Postern, Verpackungen, Beschilderung und Typografie. Beliebt sind Workflows, bei denen Komposition, Informationshierarchie, Schriftgrößen und Weißraum zunächst mit einem externen LLM ausgearbeitet werden. Es gibt allerdings Berichte, dass englische Infografiken unerwartet chinesische Zeichen enthalten können.
9. Prompt-Rewriting
Das offizielle Repository enthält Prompt-Rewriter für T2I und I2I. Sie bauen kurze Anforderungen zu detaillierten Kompositionen aus und formulieren Bearbeitungsanweisungen so um, dass Bereiche außerhalb der gewünschten Änderung erhalten bleiben. Aus der Community kommt zudem die Rückmeldung, dass auf einzelne Einsatzzwecke zugeschnittene Vorlagen manchmal besser funktionieren als das Standard-Rewriting.
10. Beschleunigung, geringerer Speicherbedarf und Quantisierung
Unterstützt werden CPU-Offload in Diffusers, Prefix-KV-Cache in vLLM-Omni, CUDA Graph, FP8, Tensor Parallelism sowie Speicher-Offload und optimierte Kernel von SGLang. Für ComfyUI sind zudem Varianten mit BF16, INT8 ConvRot, GGUF und 4-Bit-Techniken erschienen. Nutzer berichten von ungefähr doppelter Geschwindigkeit mit einer 4-Step-LoRA und von Custom Nodes, die Prompt-Erweiterung mit 8 GB VRAM ermöglichen. Das Verhältnis von Geschwindigkeit zu Qualität sollte jedoch stets überprüft werden.
11. Unterstützte Umgebungen
Genannt werden die offizielle Implementierung, Hugging Face Diffusers, ComfyUI, vLLM-Omni, SGLang-Diffusion, LightX2V und ModelScope. Vorgestellt werden außerdem ROCm-Beispiele für AMD Radeon sowie Multi-Chip-Unterstützung über FlagOS.
12. Hinweise zur Lizenz
Die Modellgewichte sind veröffentlicht, stehen jedoch nicht unter Apache 2.0, sondern unter dem „Qwen Research License Agreement“. Die offizielle Lizenz hält fest, dass für kommerzielle Nutzung eine separate kommerzielle Lizenz erforderlich ist. Hinzu kommen Hinweis- und Informationspflichten bei Weiterverteilung sowie die Kennzeichnung „Built with Qwen“ oder „Improved using Qwen“ in der Dokumentation abgeleiteter KI-Modelle. Vor einem Einsatz im Unternehmen sollte unbedingt der Originaltext geprüft werden.
Quelle: offizielle Lizenz
50 Perspektiven aus offiziellen Beispielen
Hier werden 50 offizielle Qwen-Image-2.1-Beispiele des Qwen-Teams vorgestellt und mit den auf Reddit besonders diskutierten Themen verknüpft. Es geht nicht nur um einzelne schöne Bilder: Eingaben, Bearbeitungsergebnisse, Masken, Mehrfachreferenzen, Kameraänderungen und die Erstellung von Unterlagen zeigen, an welcher Stelle im Produktionsprozess das Modell nützlich sein kann.
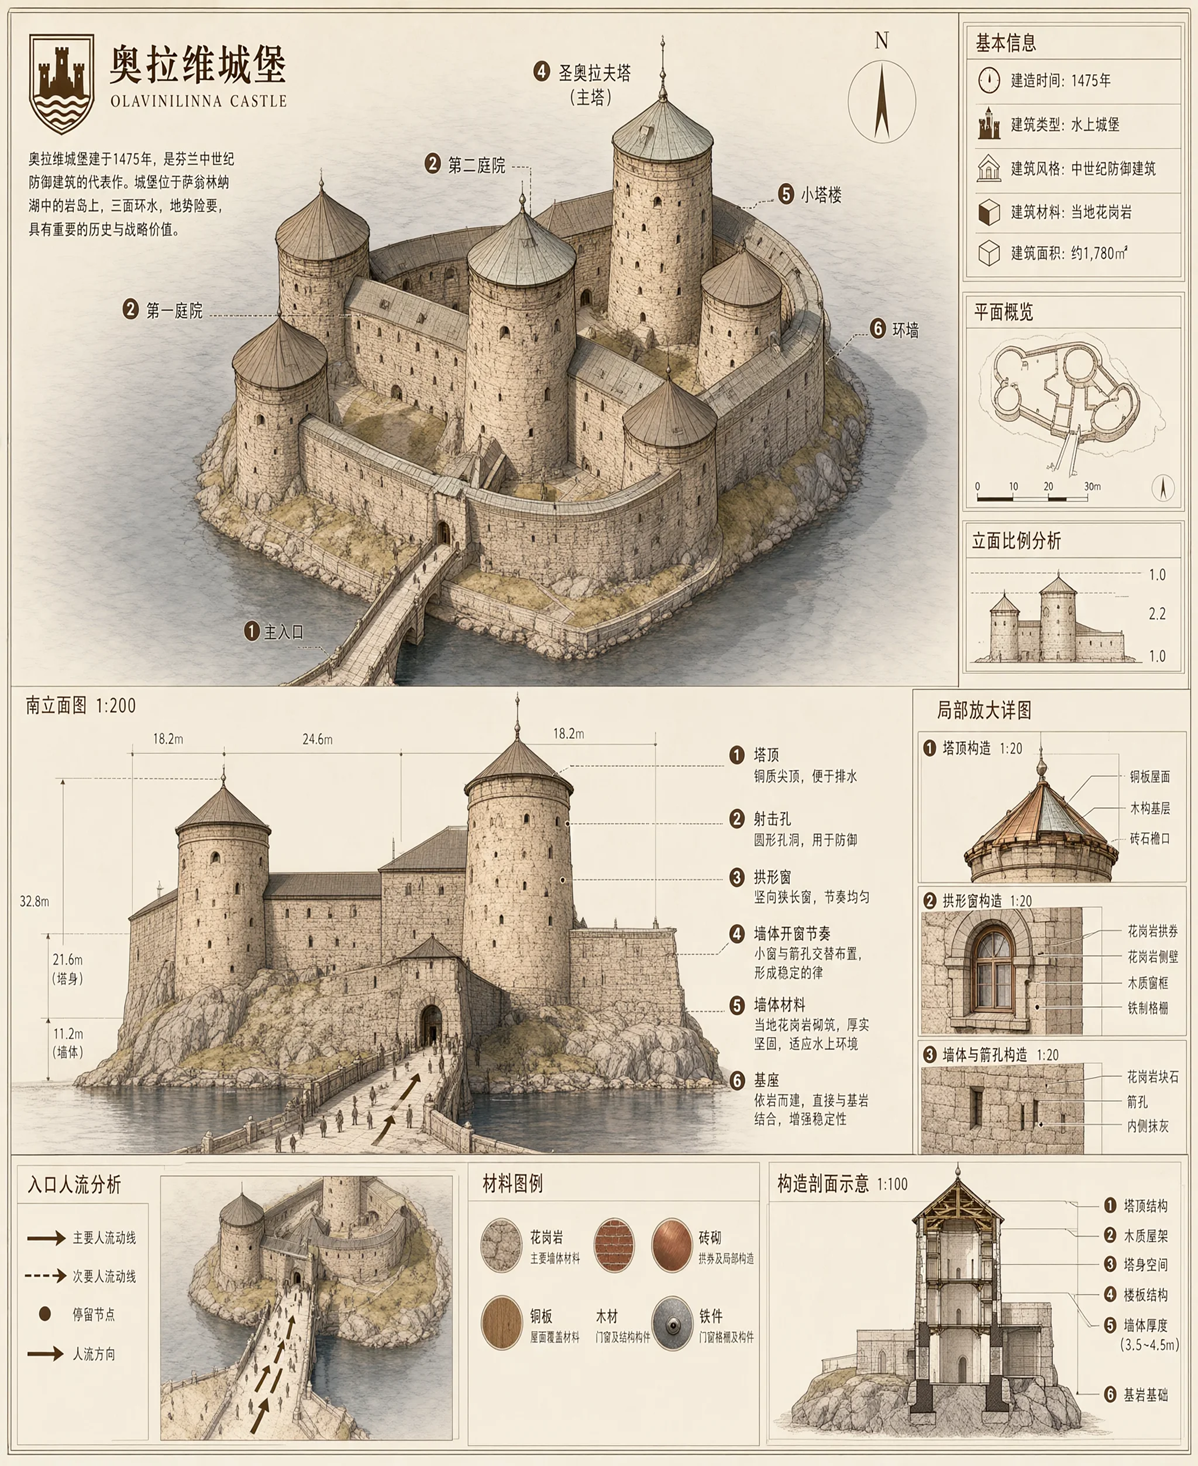
Transparente Assets und Illustrationsgenerierung
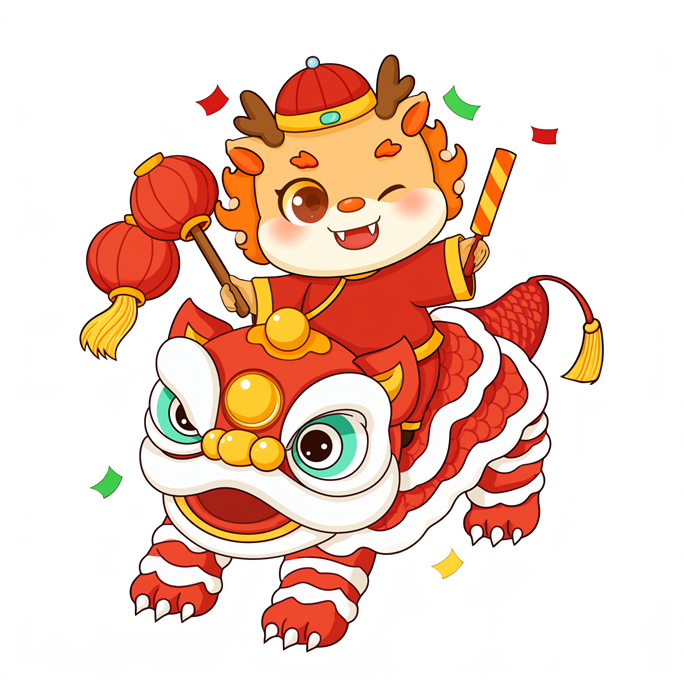
Beispiel 1: Transparente Illustration mit Löwentanz-Motiv. Ein Beispiel für feine Konturdekorationen und Alphahintergrund zugleich.
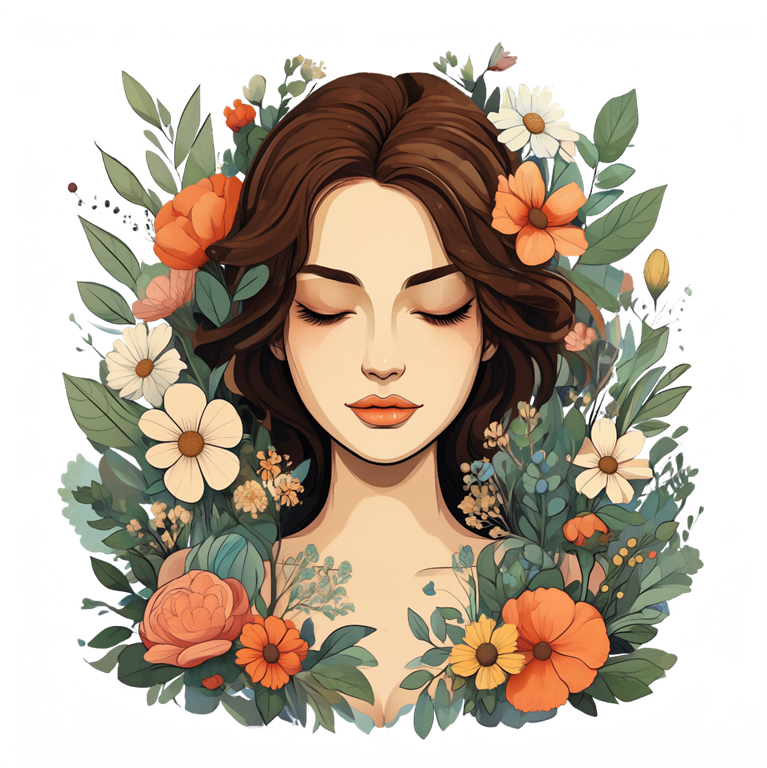
Beispiel 2: Dekorative Illustration einer von Blumen umgebenen Frau. Mit komplexen Übergängen zwischen Haaren, Blütenblättern und Blättern.
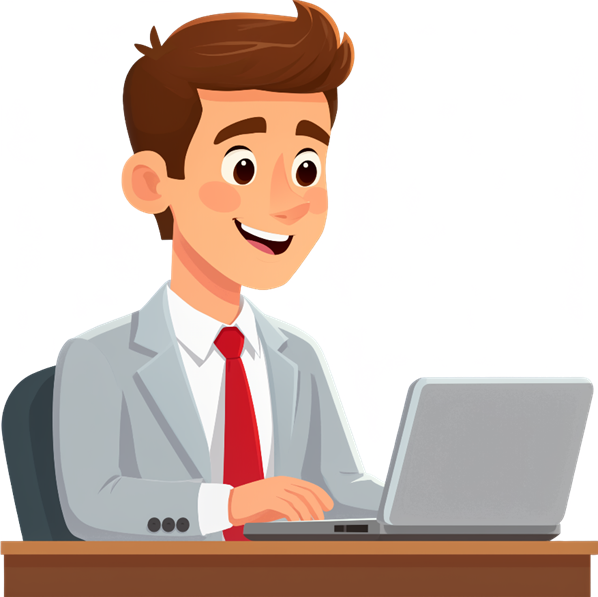
Beispiel 3: Geschäftsperson am Laptop. Eine Cutout-Illustration für Web- oder Präsentationsmaterial.
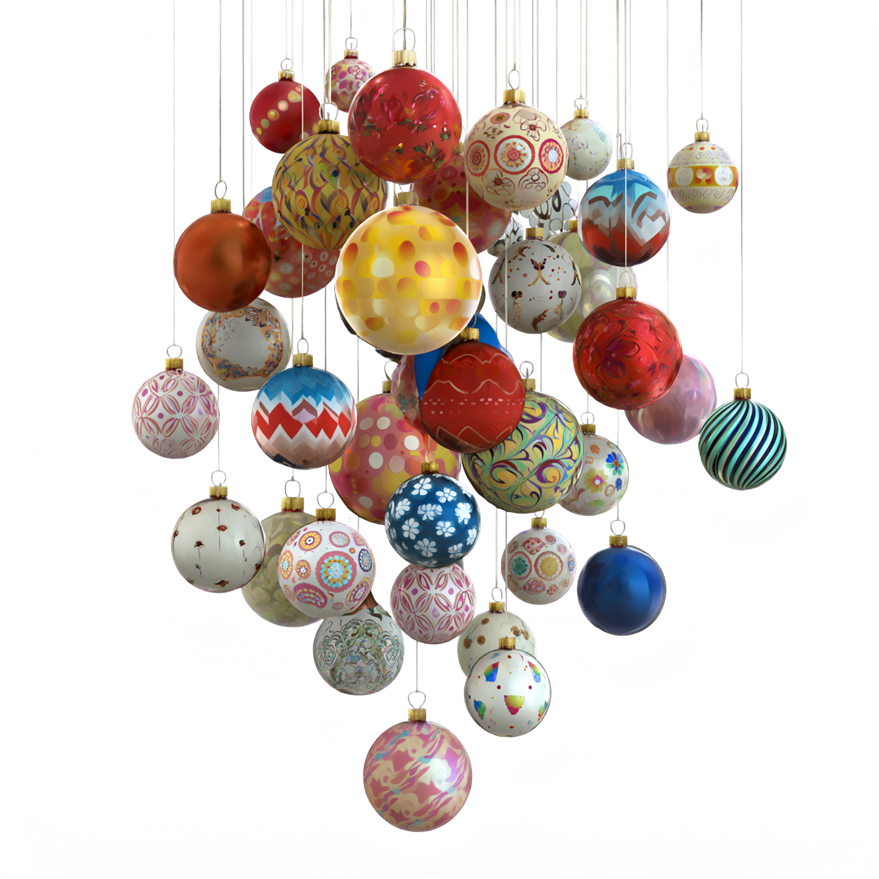
Beispiel 4: Mehrere hängende Dekorationen. Transparenzeffekte, dünne Fäden und unterschiedliche Materialien werden in einem Bild vereint.
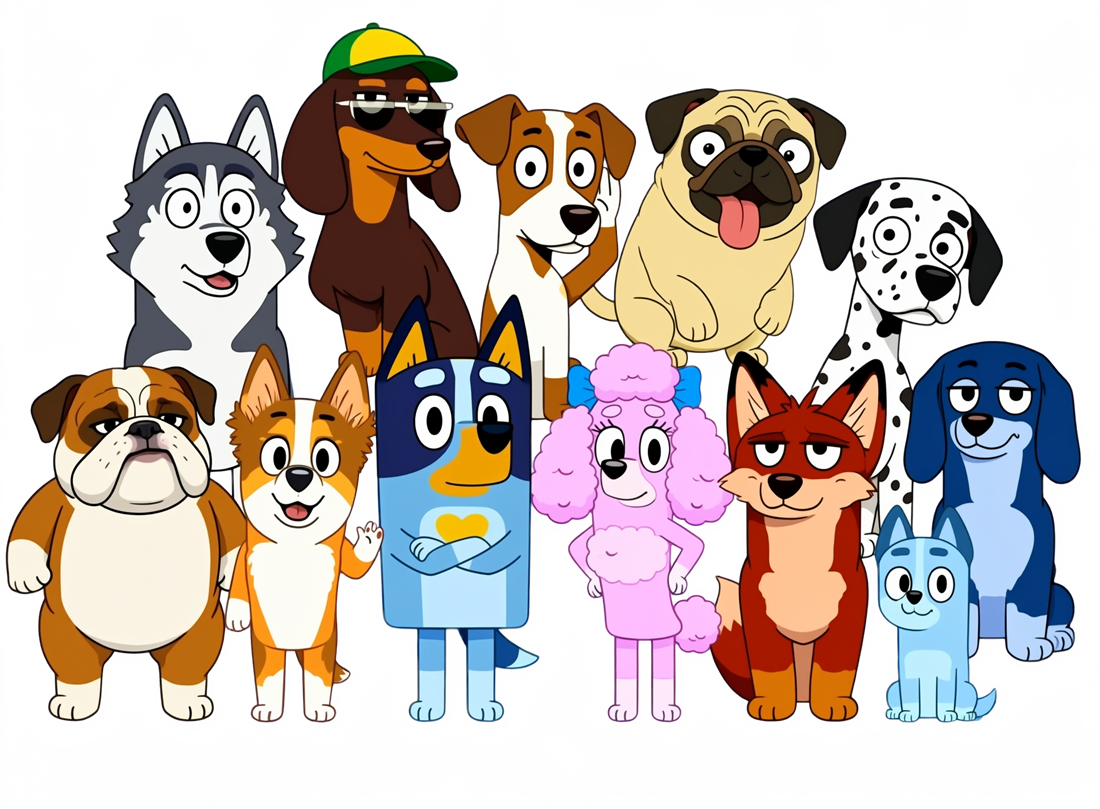
Beispiel 5: Viele Hundecharaktere. Beispiel für die Ausarbeitung mehrerer Subjekte und eine Gruppenkomposition.
Bildbearbeitung und Textersatz
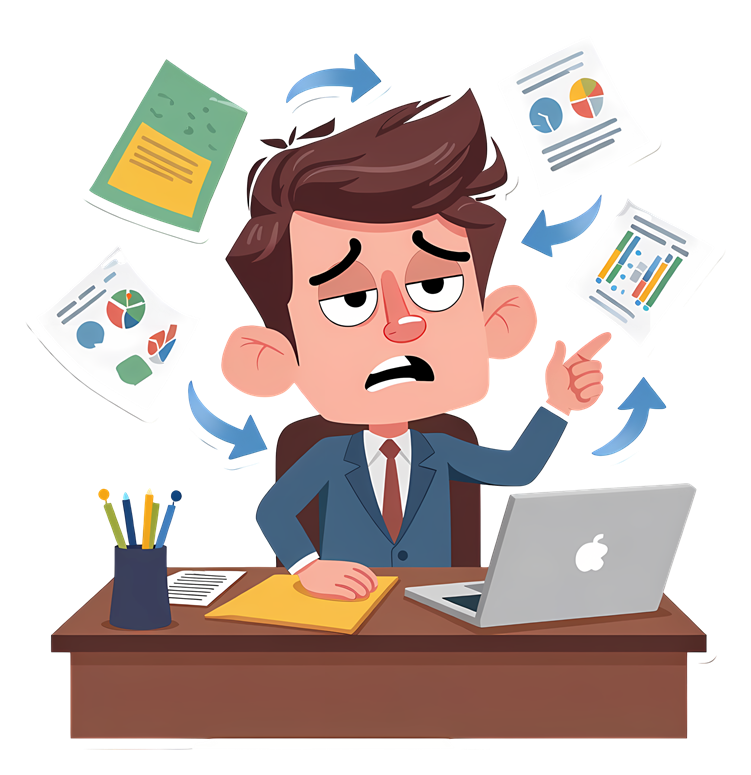
Beispiel 6: Originalbild eines erschöpften Angestellten. Bedingungsbild zum Vergleich mit dem anschließenden Bearbeitungsergebnis.
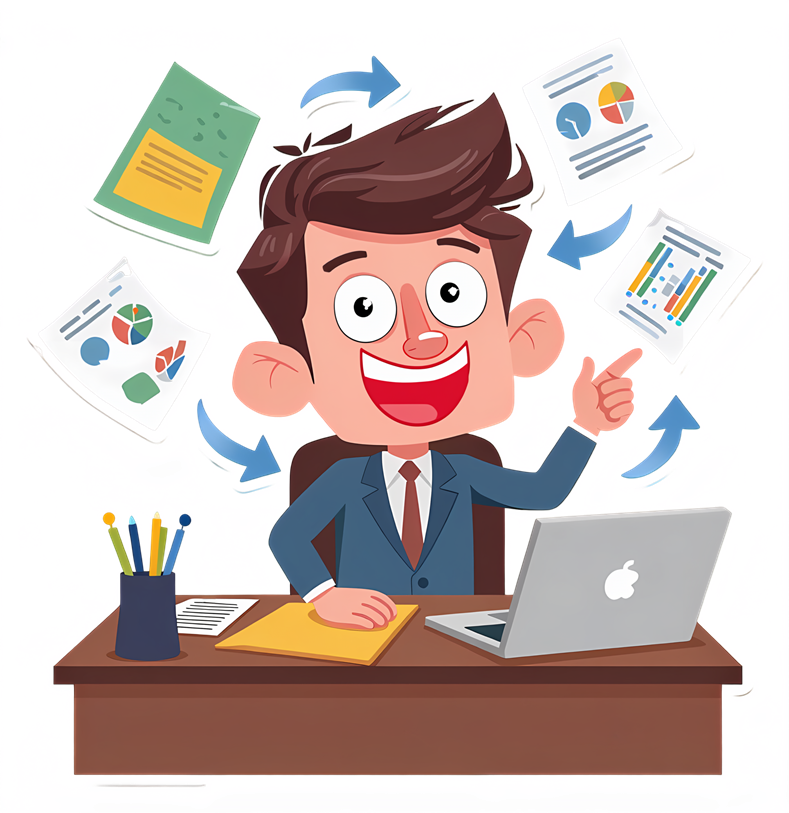
Beispiel 7: Angestellter mit veränderter Stimmung und Mimik. Die Emotion der Person verändert sich, während das Layout erhalten bleibt.
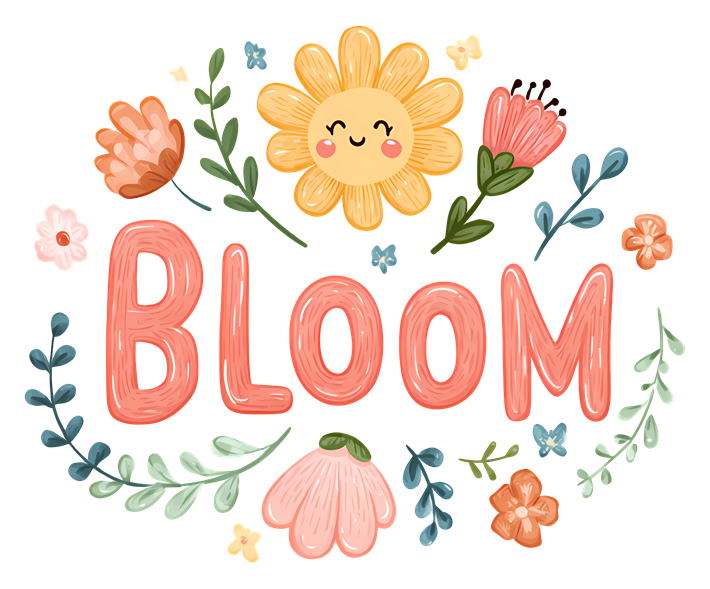
Beispiel 8: Blumen-Schriftzug „BLOOM“. Ein Referenzbeispiel für Schrift, Dekoration und mittige Anordnung.
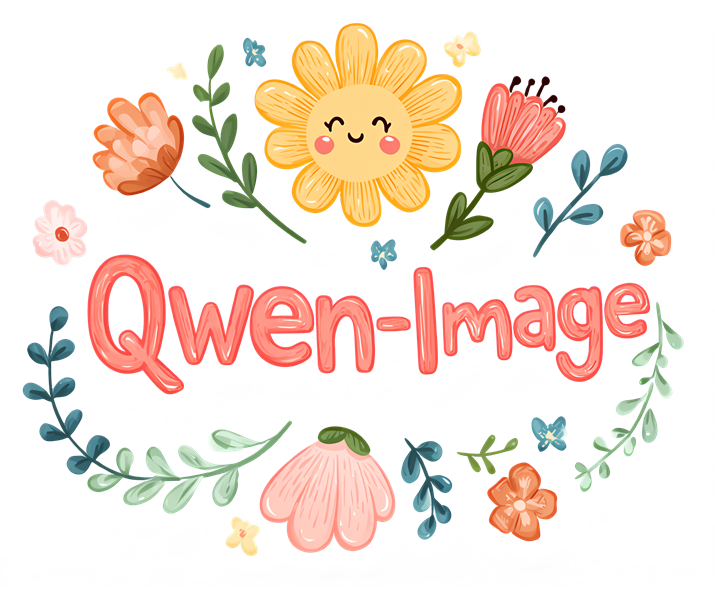
Beispiel 9: Textersatz durch „Qwen-Image“. Typografische Bearbeitung unter Beibehaltung des Blumenstils.
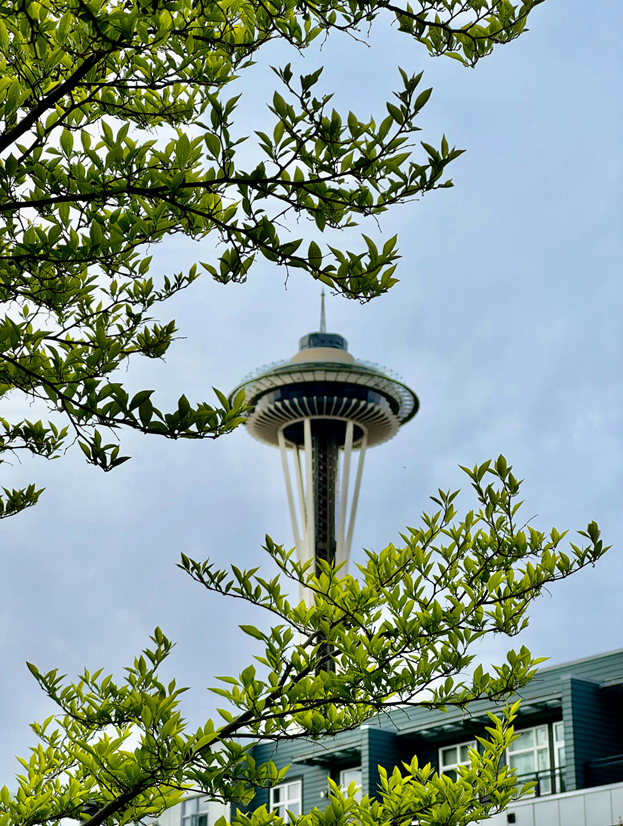
Beispiel 10: Turmaufnahme bei Tag. Eingabebeispiel für die Bearbeitung von Tageszeit und Hintergrund.
Hintergrund, Tageszeit und mehrere Personen
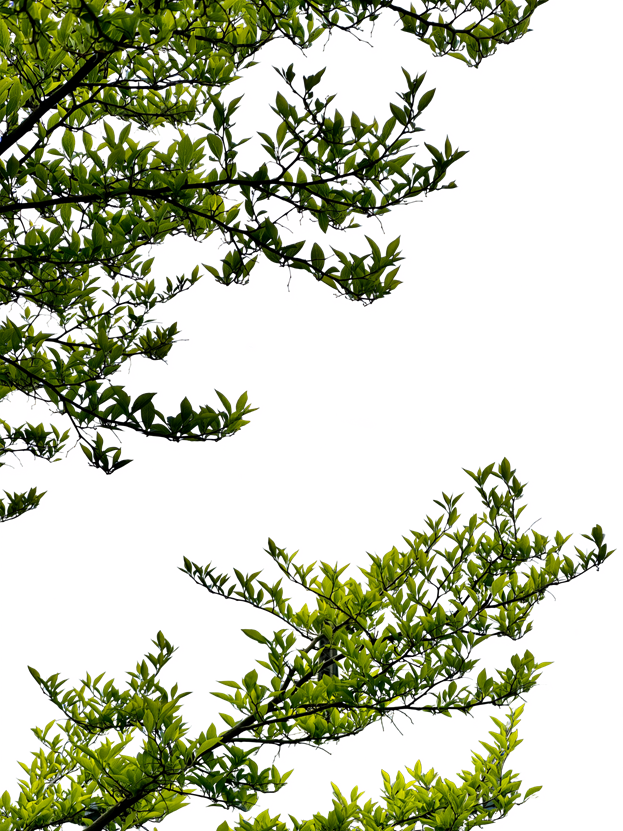
Beispiel 11: Blühender Baum bei Nacht. Zeigt die Bearbeitung von Tagesfoto zu Nachtansicht oder einer anderen Stimmung.
Beispiel 12: Gruppenfoto aus mehreren Personenreferenzen. Veranschaulicht die Kernfunktion von bis zu zehn Referenzen.
Beispiel 13: Outfit aus mehreren Referenzen für Kleidung und Person. Ähnelt dem Prinzip eines virtuellen Anprobierens.
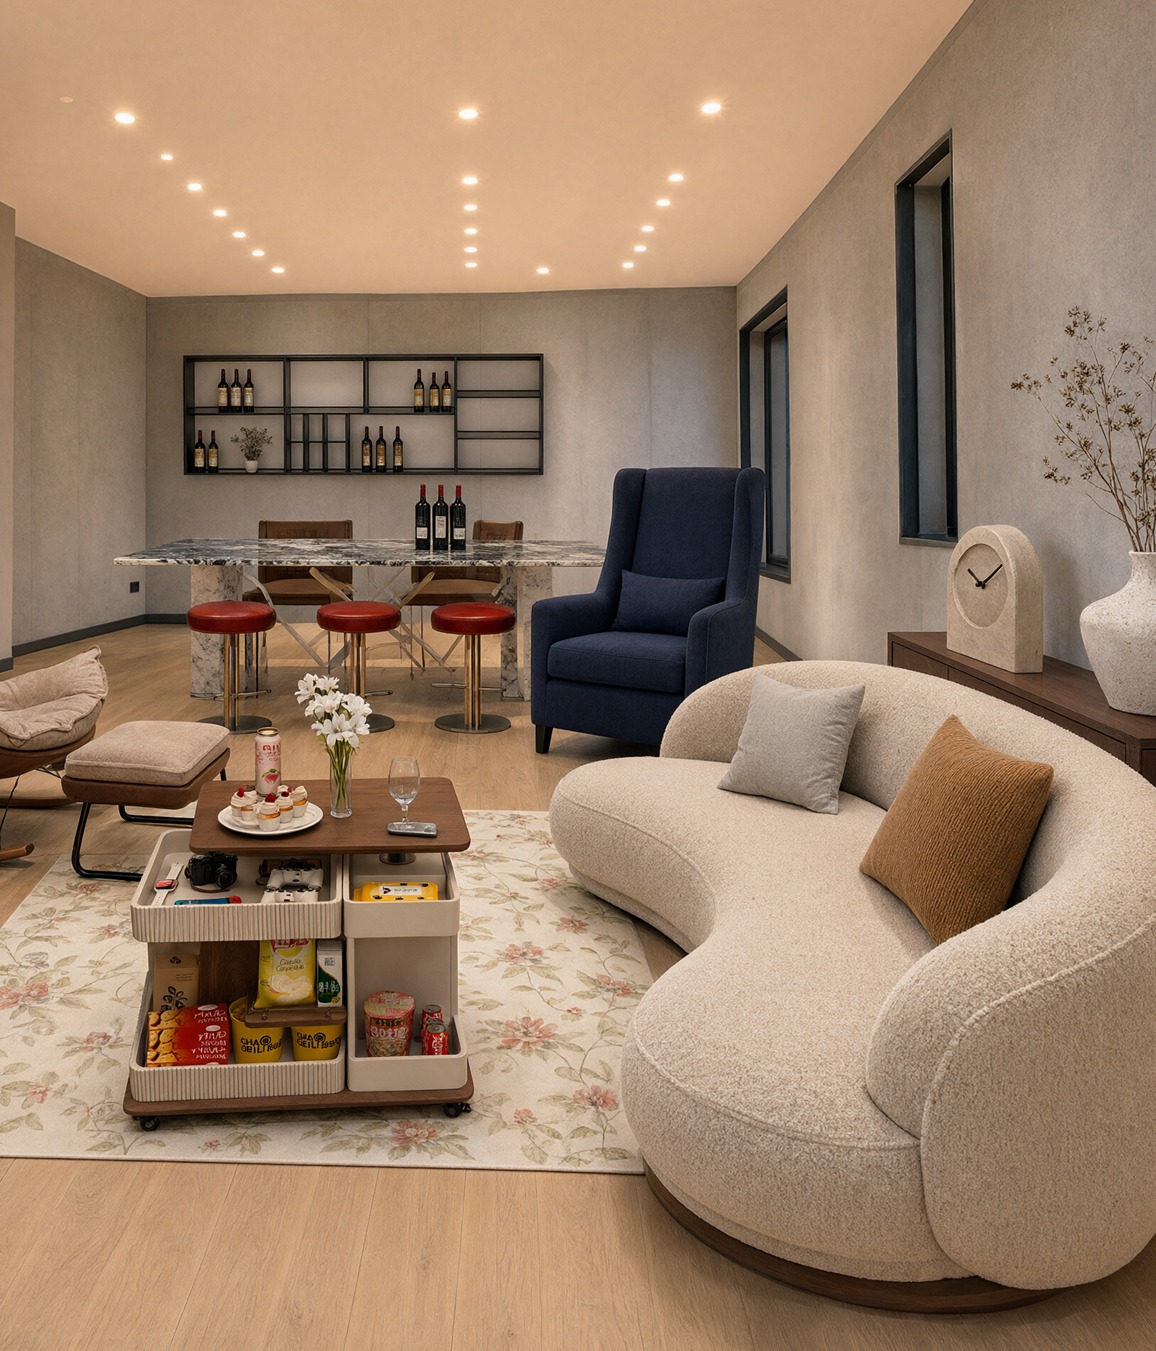
Beispiel 14: Raum aus vielen Möbelbildern. Anwendung zum Platzieren eines Produktkatalogs in einem Zimmer.
Beispiel 15: Farbige Anweisung um eine Katze. Eingabe für lokale Vorgaben mittels eingezeichneter Markierung.
Lokale Bearbeitung, Masken und Compositing
Beispiel 16: Nur die festgelegte Katze verändern. Das Motiv wird ersetzt, während Bettzeug und Person erhalten bleiben.
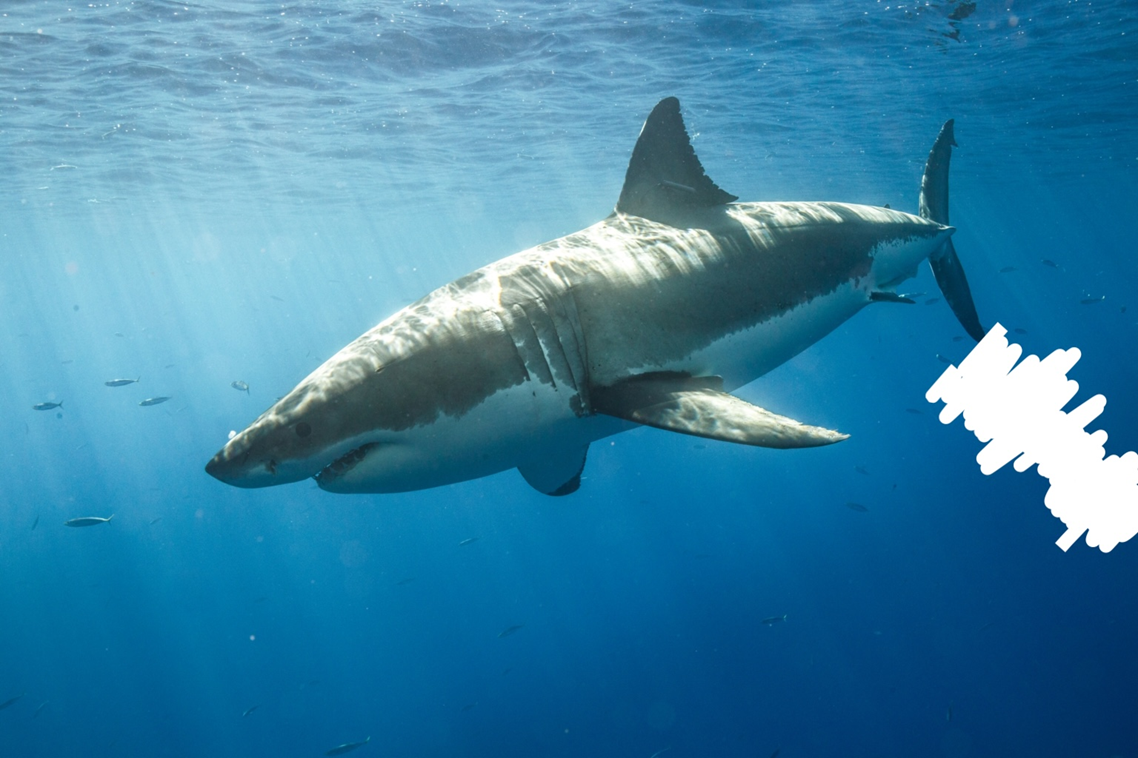
Beispiel 17: Hai unter Wasser mit lokaler Anweisung. Bearbeitungseingabe mit direkter Zeichnung auf dem Zielobjekt.
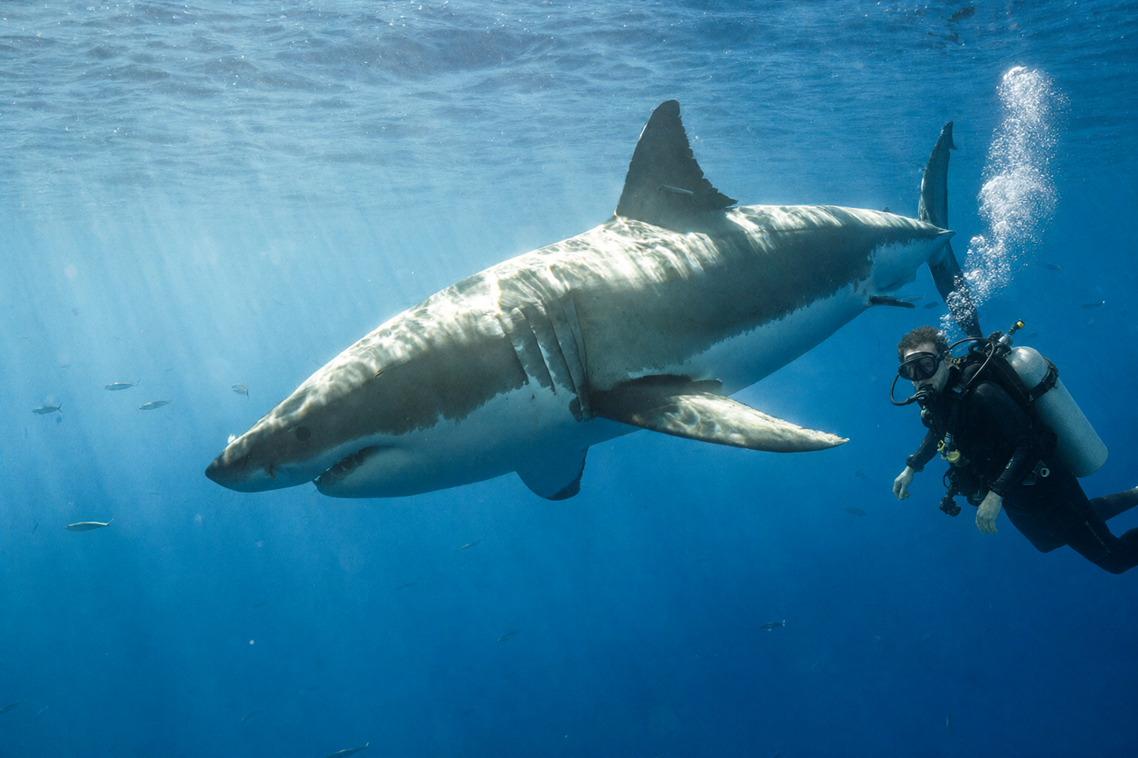
Beispiel 18: Unterwasserszene mit hinzugefügtem Taucher. Compositing mit abgestimmtem Unterwasserlicht und Maßstab.
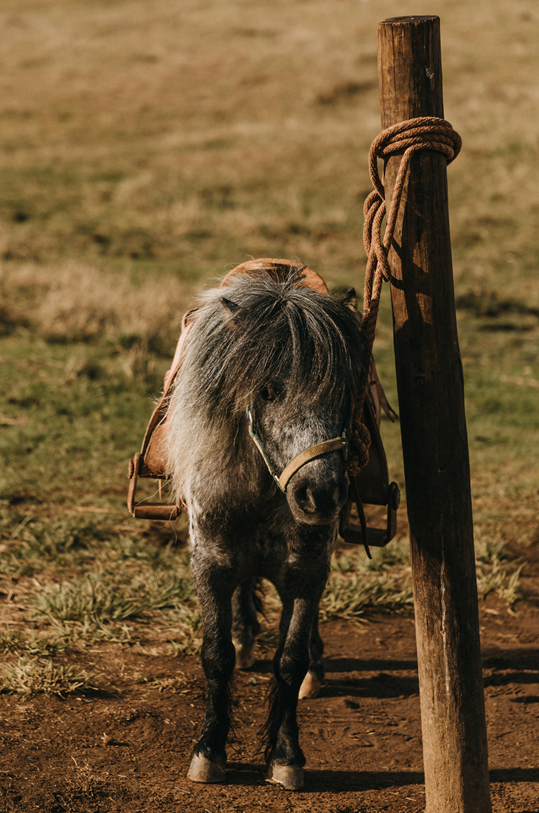
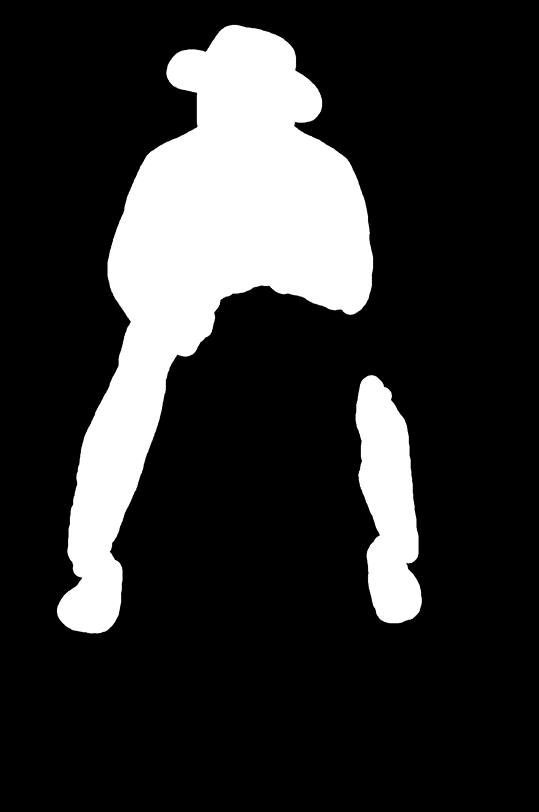
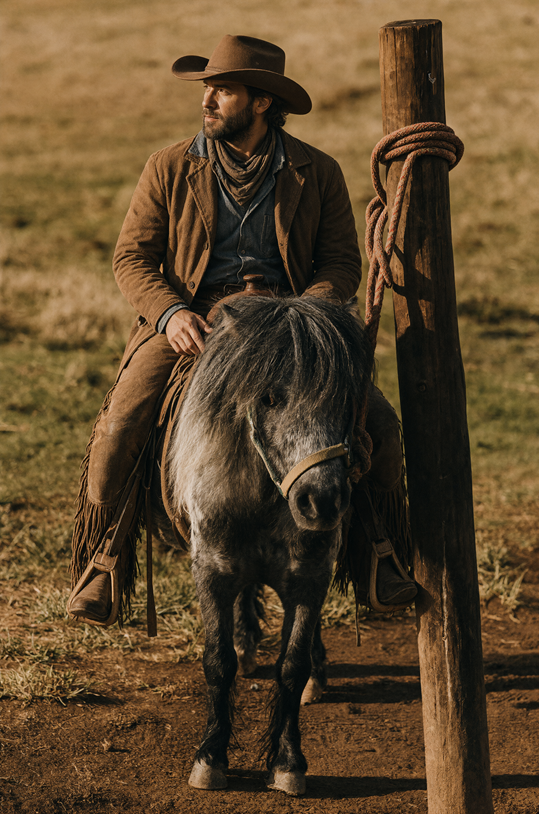
Beispiel 19: Originalbild einer Person auf einem Esel. Foto als Grundlage für Maskenbearbeitung.
Beispiel 20: Maske für Person und Esel. Eine alternative Methode, den Änderungsbereich schwarz-weiß anzugeben.
Neuplatzierung von Personen und Gesichtserhalt
Beispiel 21: Ergebnis einer Personenbearbeitung mit Maske. Auch die Stimmigkeit mit der Graslandschaft im Hintergrund lässt sich vergleichen.
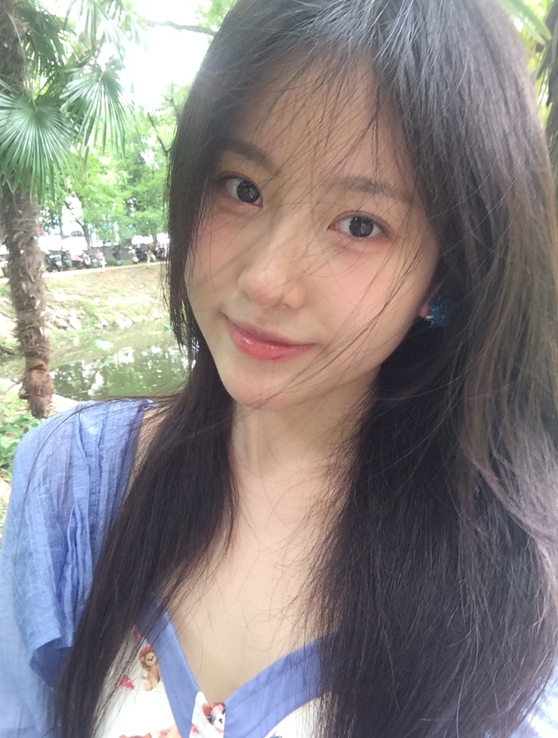
Beispiel 22: Porträt als Gesichtsreferenz. Referenzbild für die anschließende Ganzkörperaufnahme in neuer Umgebung.
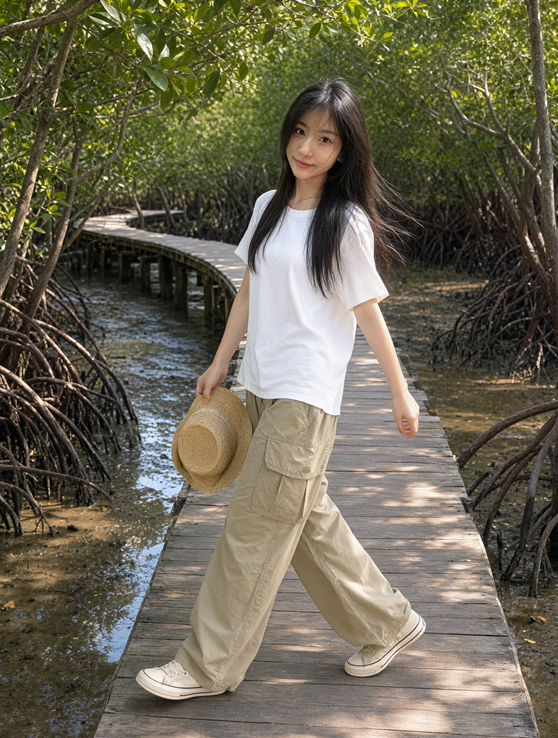
Beispiel 23: Referenzperson als Ganzkörperbild im Freien. Gesicht und Kleidung werden in eine neue Komposition übertragen.
Beispiel 24: Fast frontales Gesichtsfoto. Eingabebedingung für eine Frisurenbearbeitung.
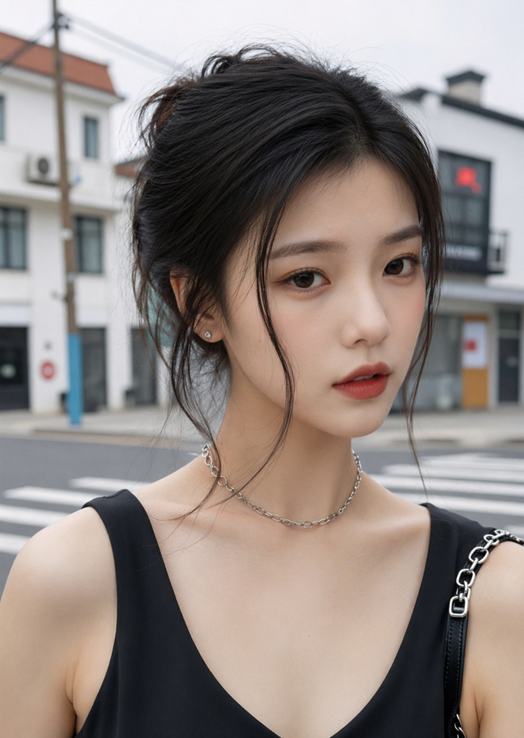
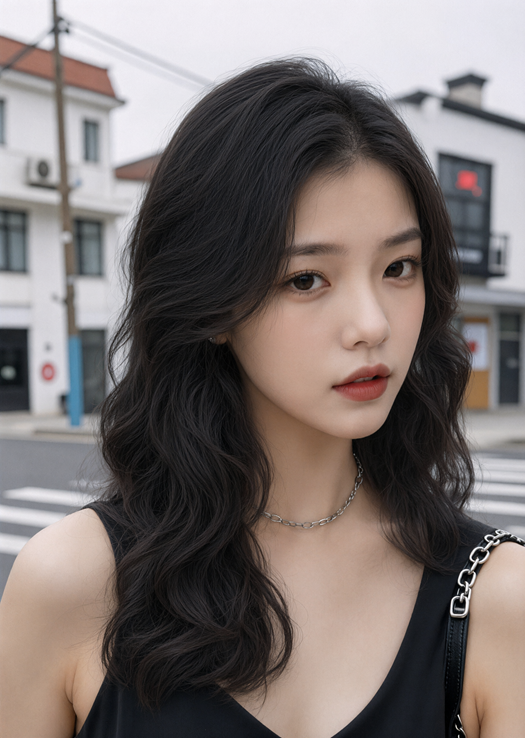
Beispiel 25: Gesichtsfoto mit veränderter Frisur. Gesichtszüge und Hintergrund bleiben erhalten, nur die Haare werden verlängert.
Posen, Szenen und Produktfotografie
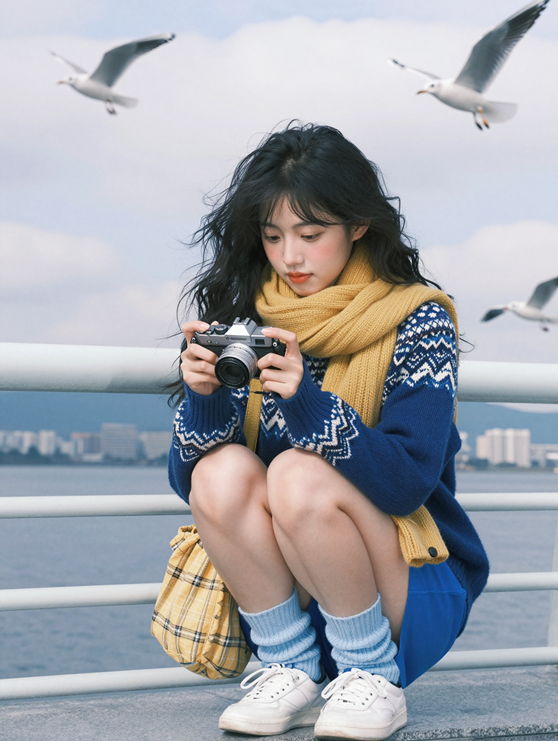
Beispiel 26: Hockende Person im Hafen. Beispiel mit komplexer Pose, Requisiten und Fernhintergrund.
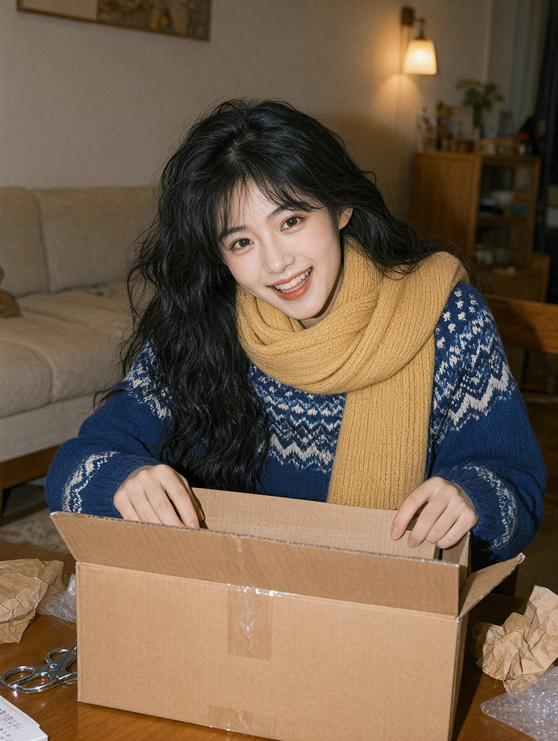
Beispiel 27: Person beim Öffnen eines Kartons in Innenräumen. Komposition zur Beurteilung von Händen, Karton und überlappendem Körper.
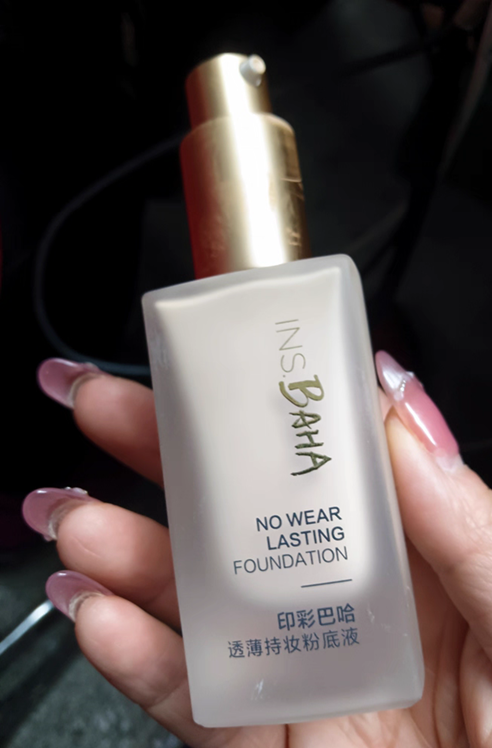
Beispiel 28: Kosmetikprodukt in der Hand. Produktfoto mit Beschriftung und Fingerkontakt.
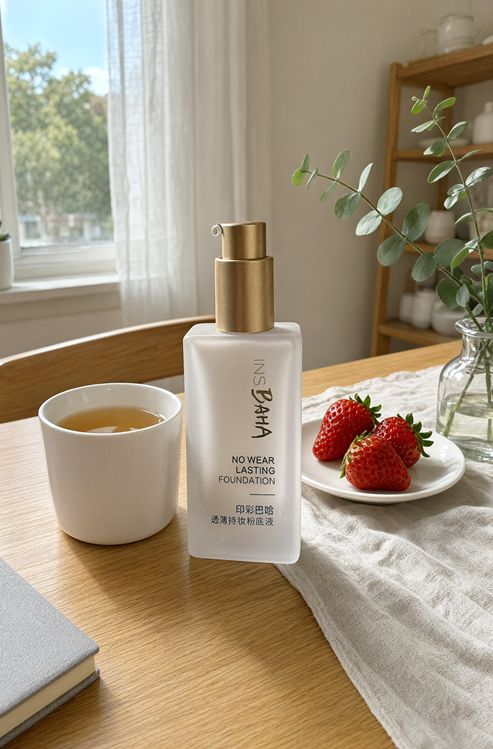
Beispiel 29: Kosmetikprodukt als Produktaufnahme im Raum. Natürliches Licht, Tisch und kleine Lebensmittelobjekte werden ergänzt.
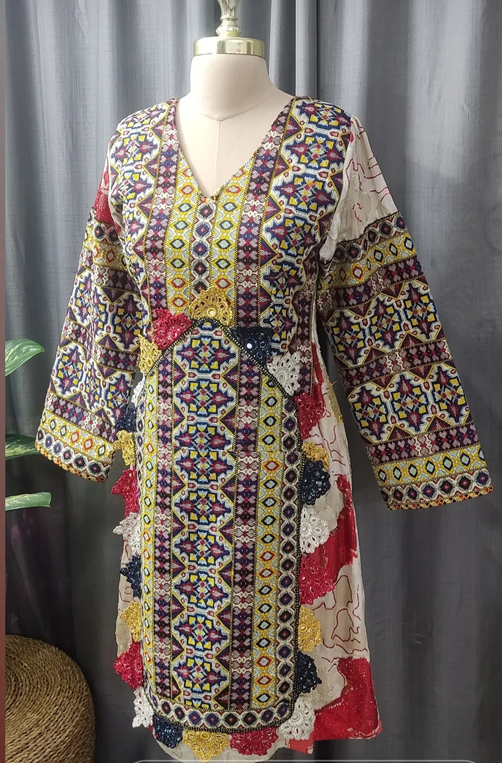
Beispiel 30: Kleidung auf einer Schaufensterpuppe. Produktreferenz für die folgende virtuelle Anprobe.
Virtuelle Anprobe und Produktintegration
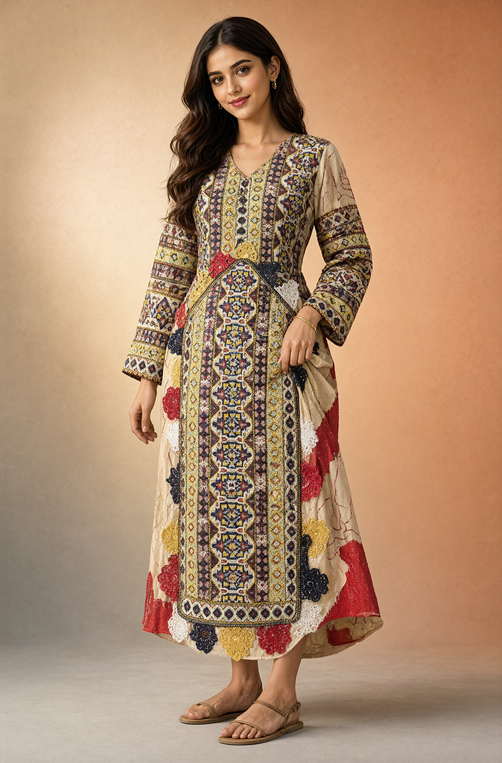
Beispiel 31: Referenzkleidung an einer Person. Muster, Länge und Silhouette werden an den Körper angepasst.
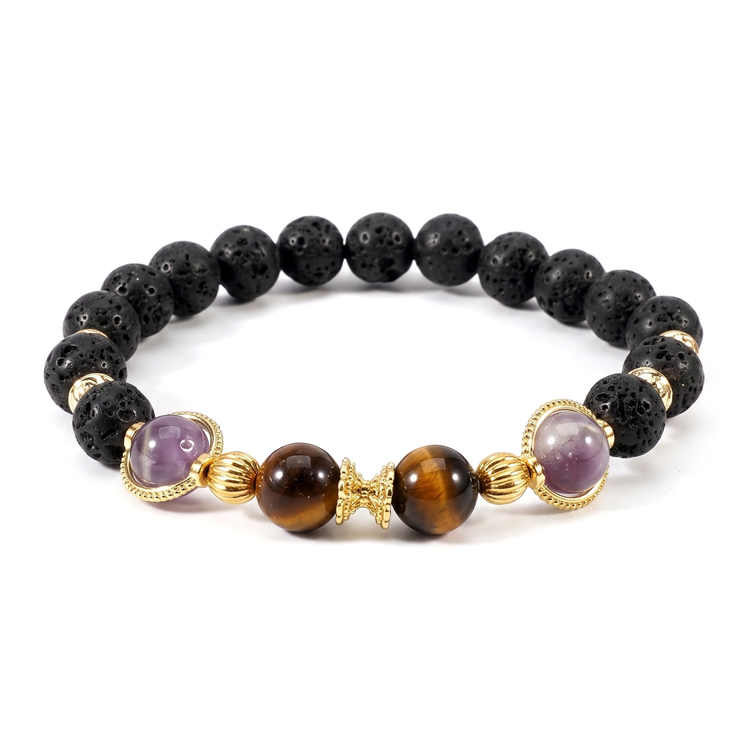
Beispiel 32: Produktfoto eines einzelnen Armbands. Bedingungsbild für das Compositing am Körper.
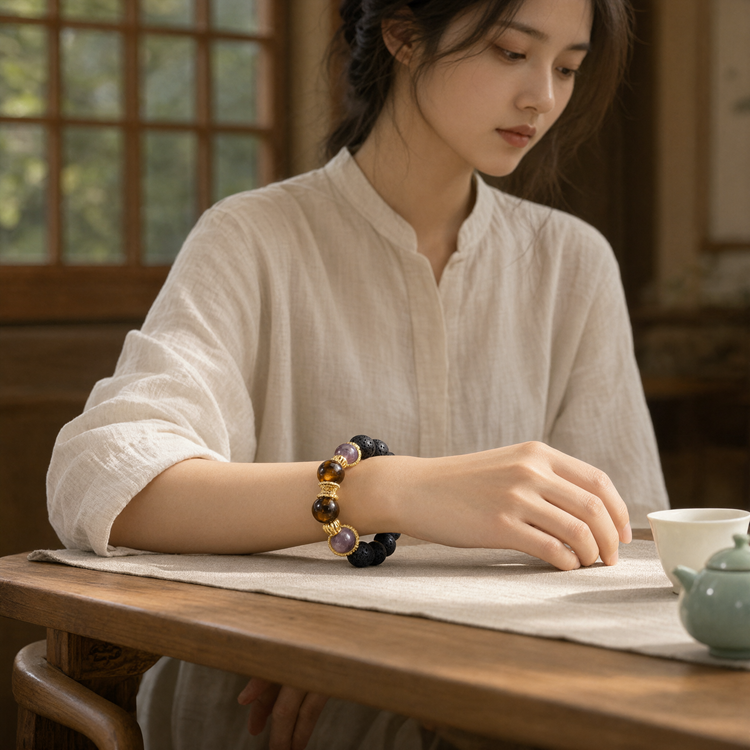
Beispiel 33: Armband am Handgelenk einer Person. Kontakt mit der Haut und Schatten werden natürlich abgestimmt.
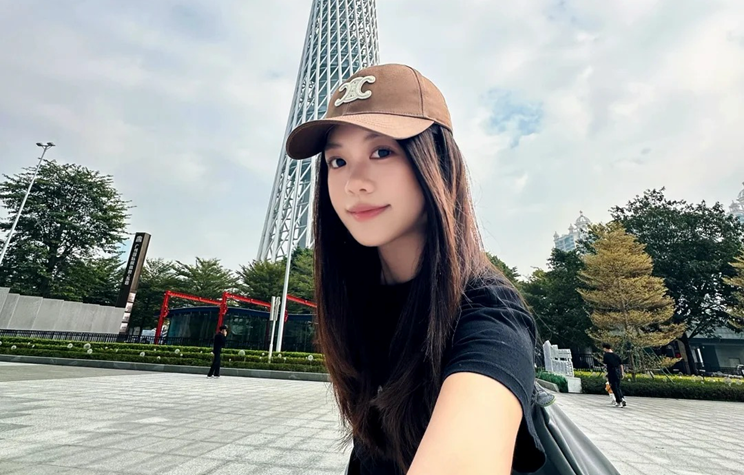
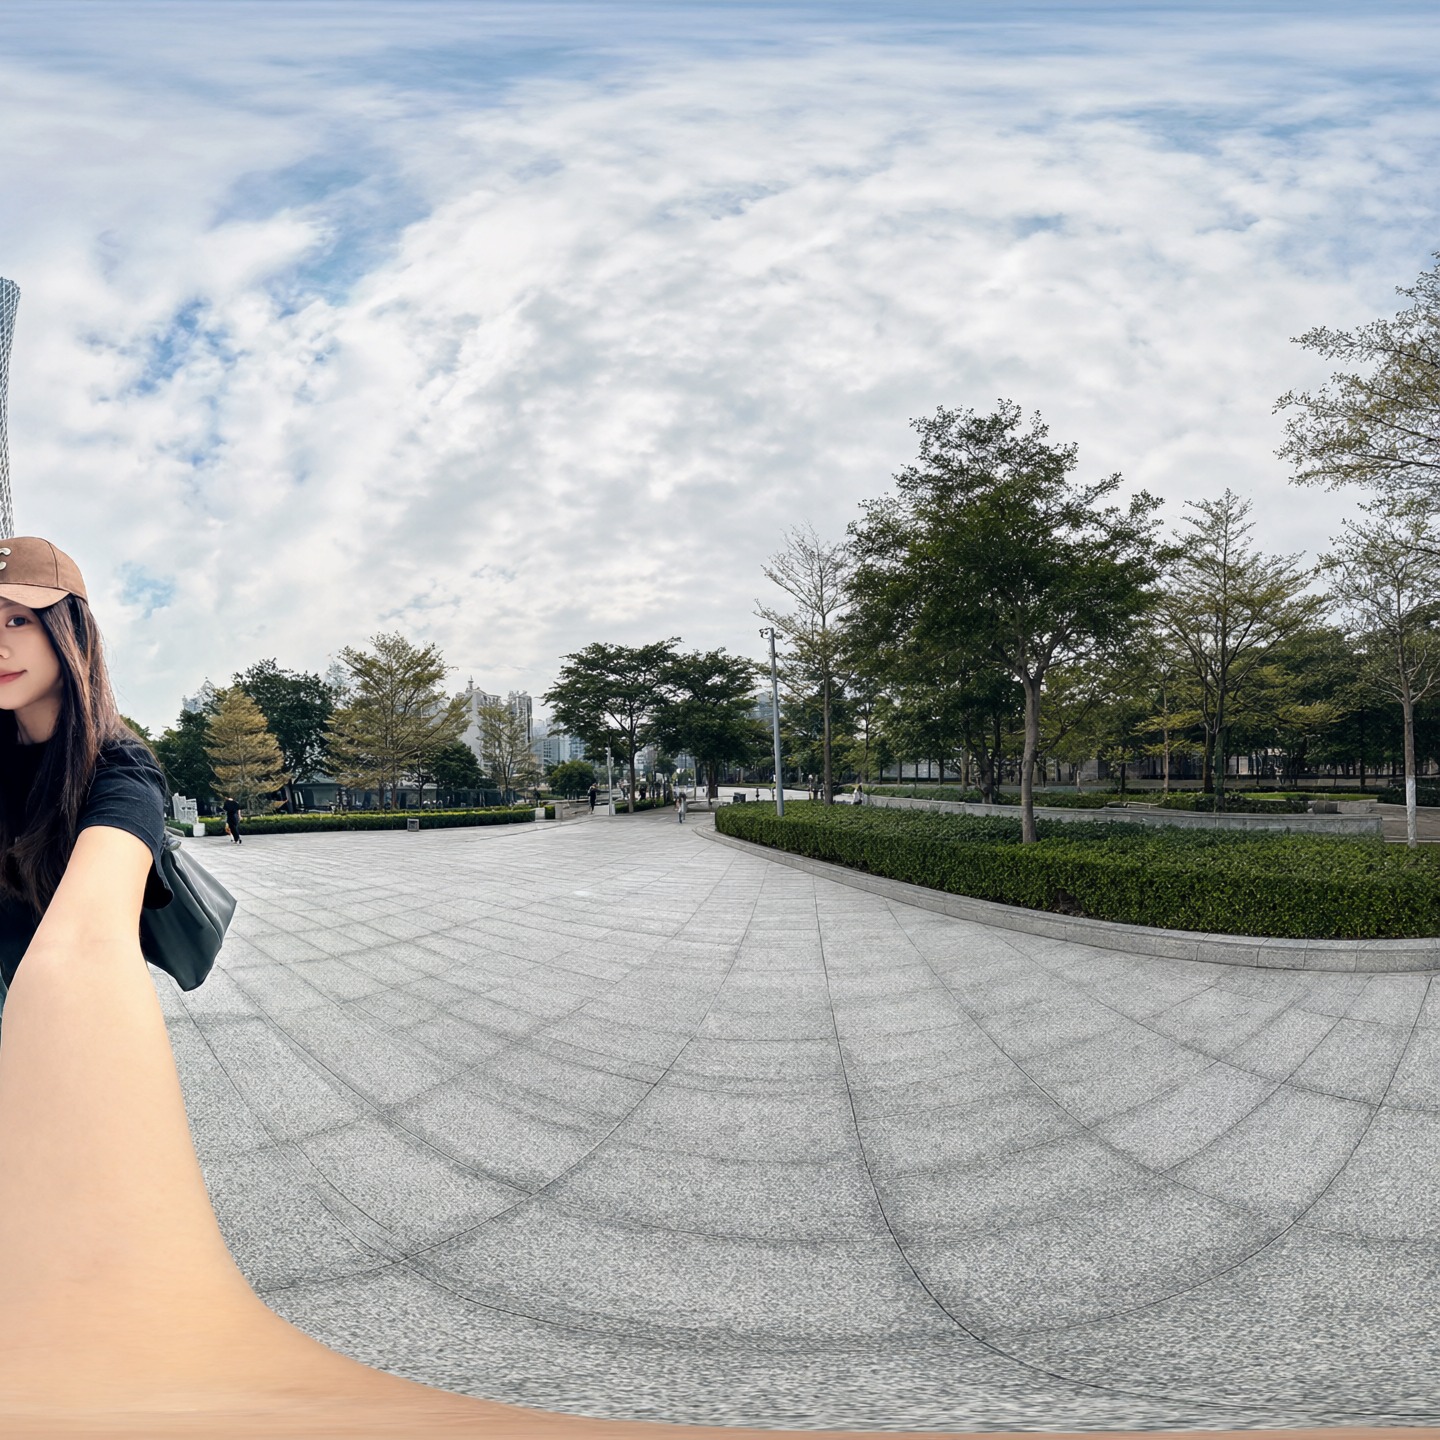
Beispiel 34: Selfie vor einem Turm. Eingabefoto für eine Perspektivänderung.
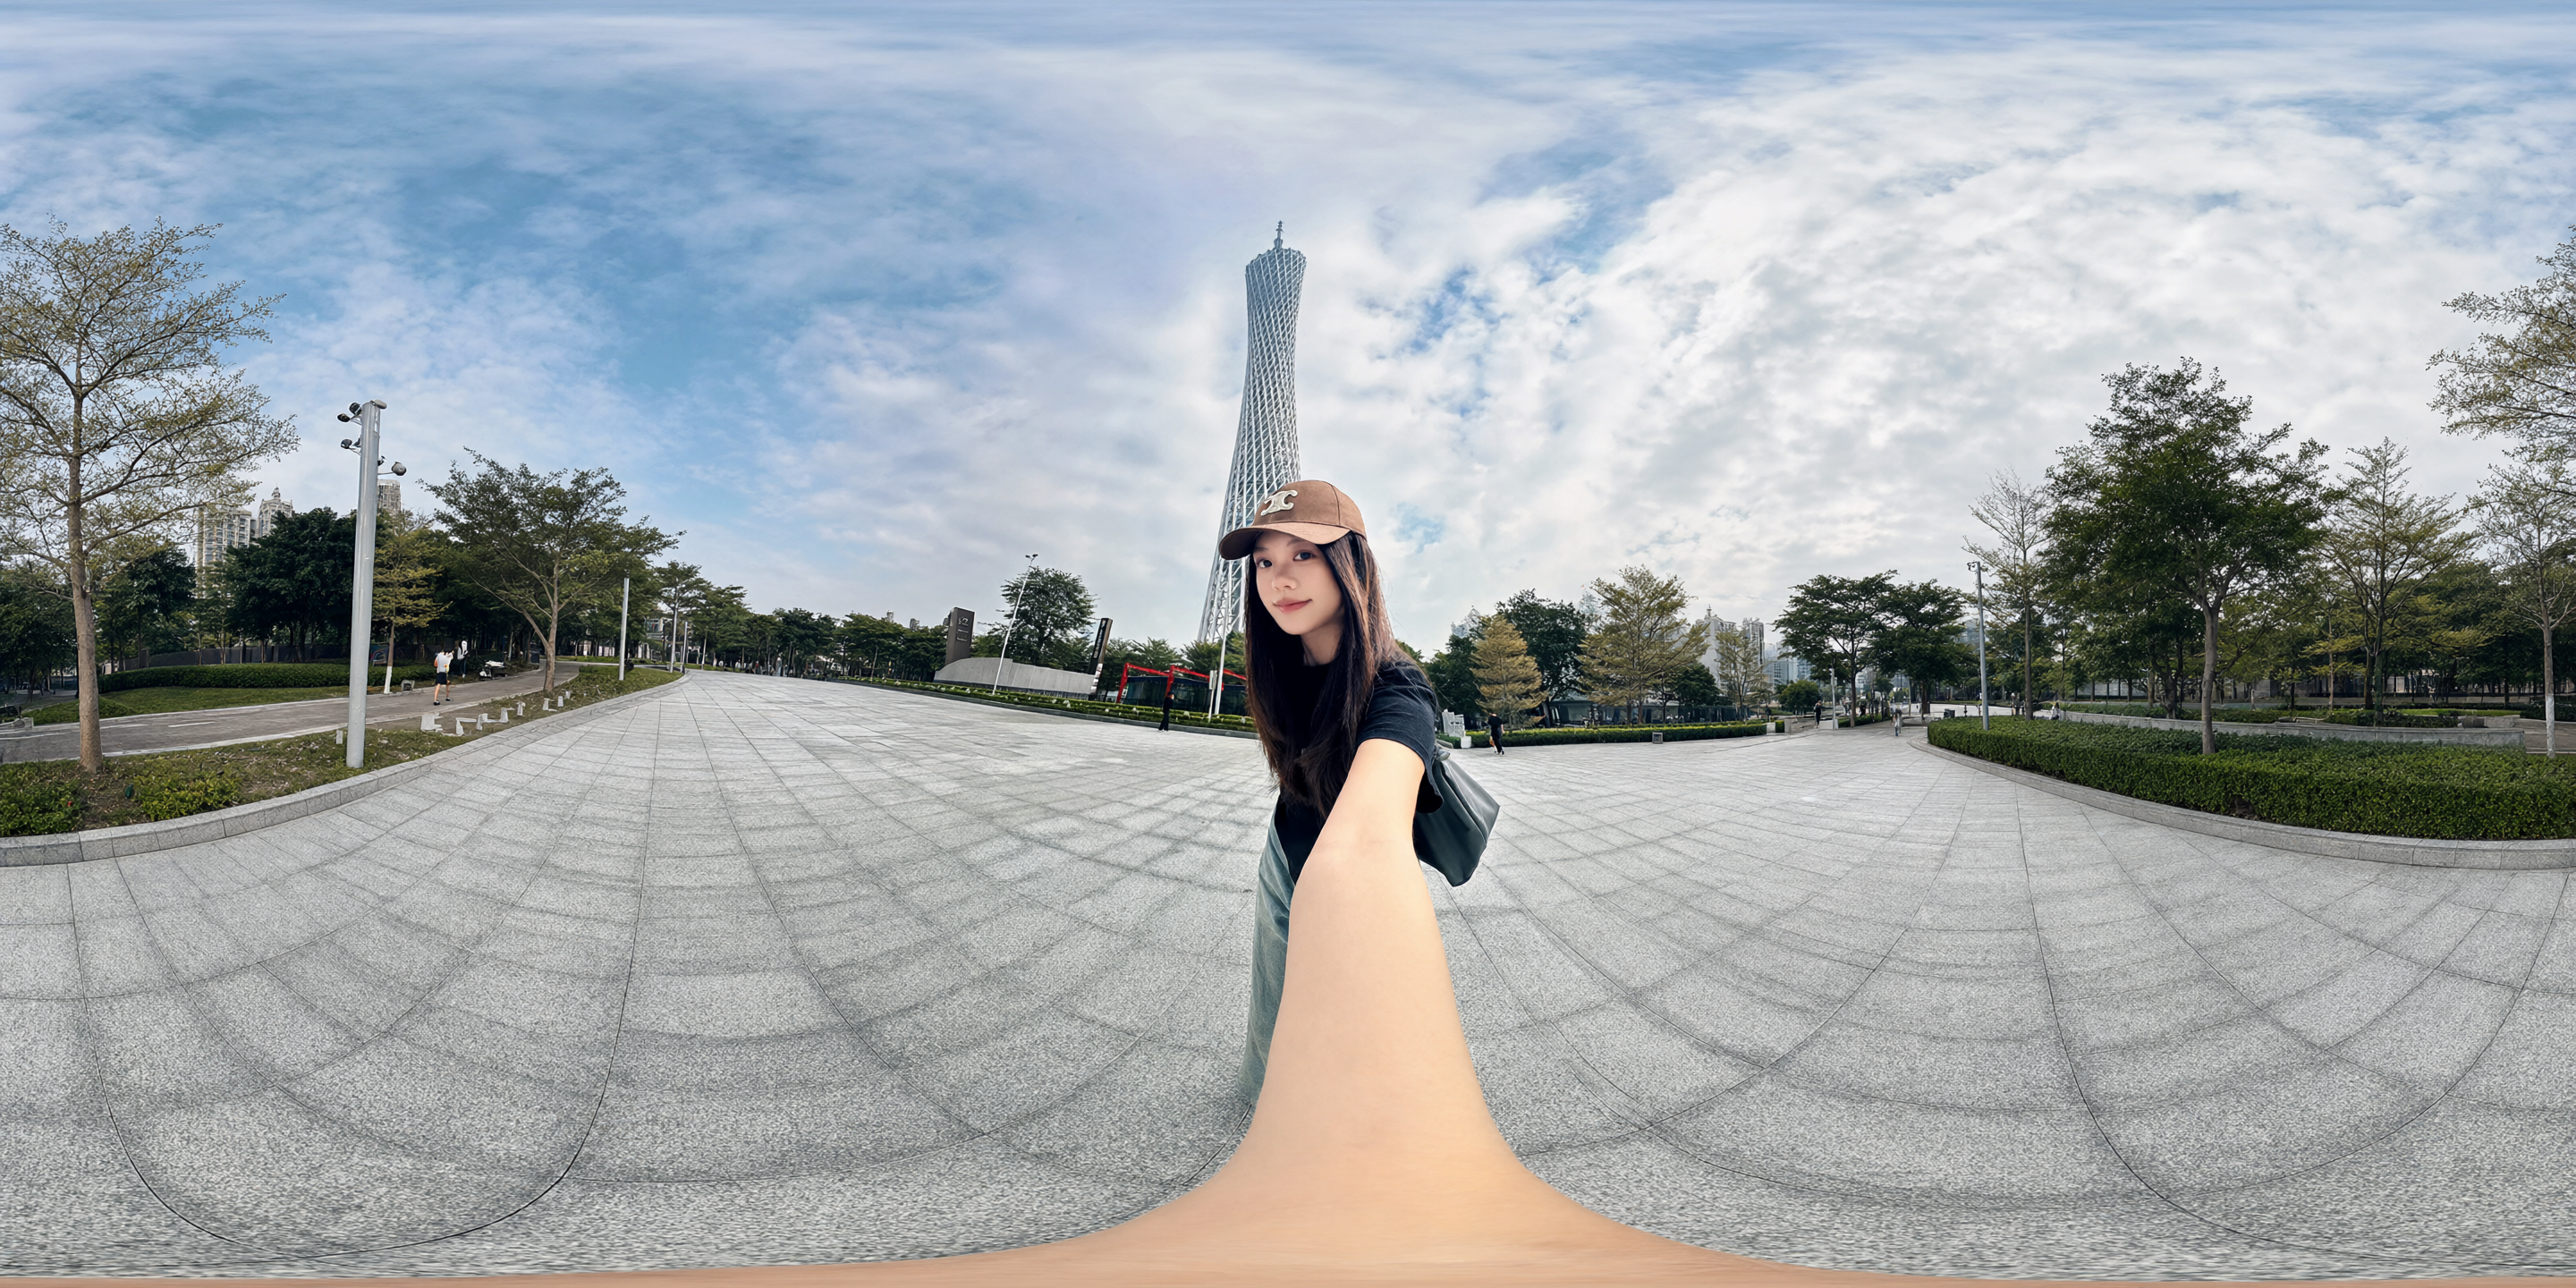
Beispiel 35: Vom Selfie zur Perspektive einer dritten Person. Dieselbe Person und derselbe Ort werden mit weiterem Blickwinkel rekonstruiert.
Charakterbögen und Kontinuität
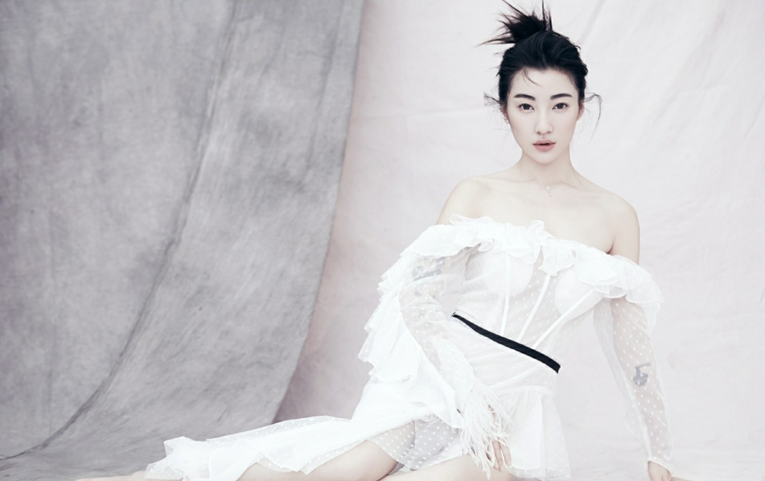
Beispiel 36: Porträt einer Person in weißer Kleidung. Eingabe für Unterlagen zur Charakterdefinition.
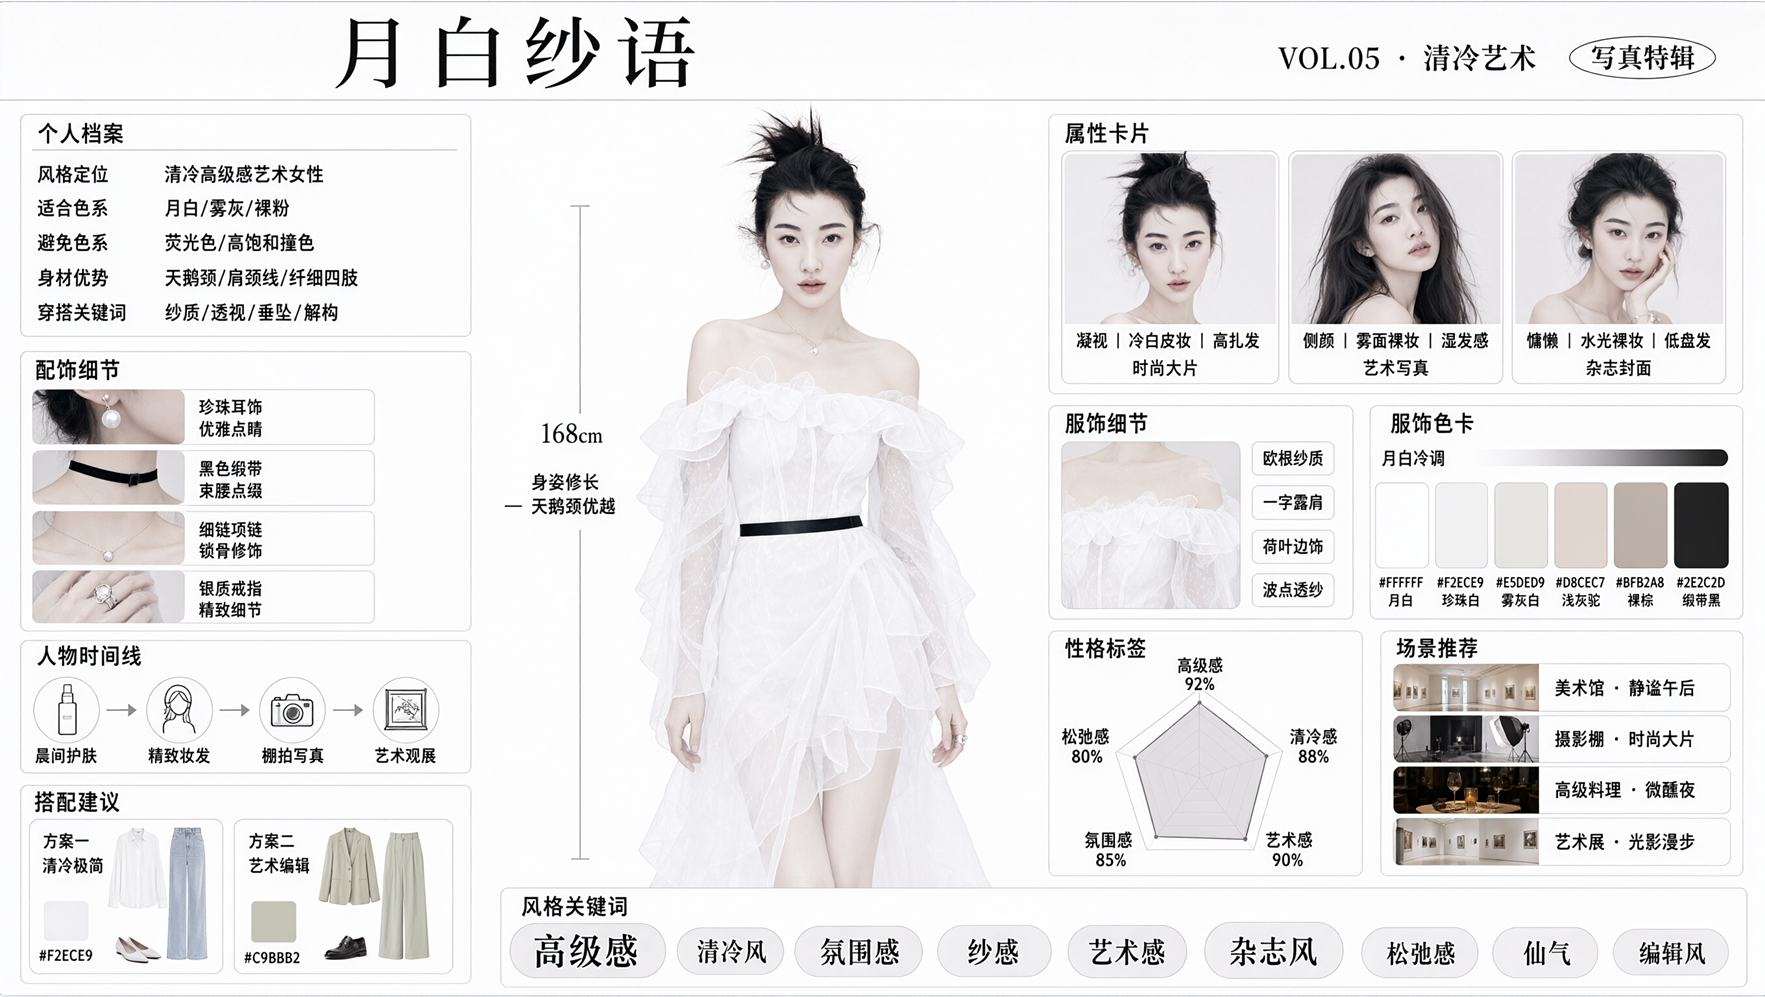
Beispiel 37: Designbogen mit der Figurenbeschreibung auf einem Bild. Gesicht, Kleidung, Zubehör und Textinformationen werden zusammengeführt.
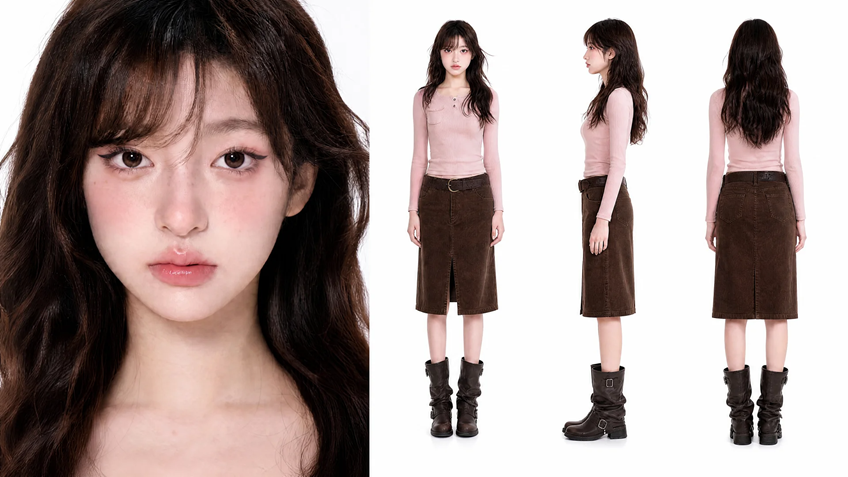
Beispiel 38: Charakterbogen mit Vorder-, Seiten- und Rückansicht. Als Referenzmaterial für Video oder Comic.
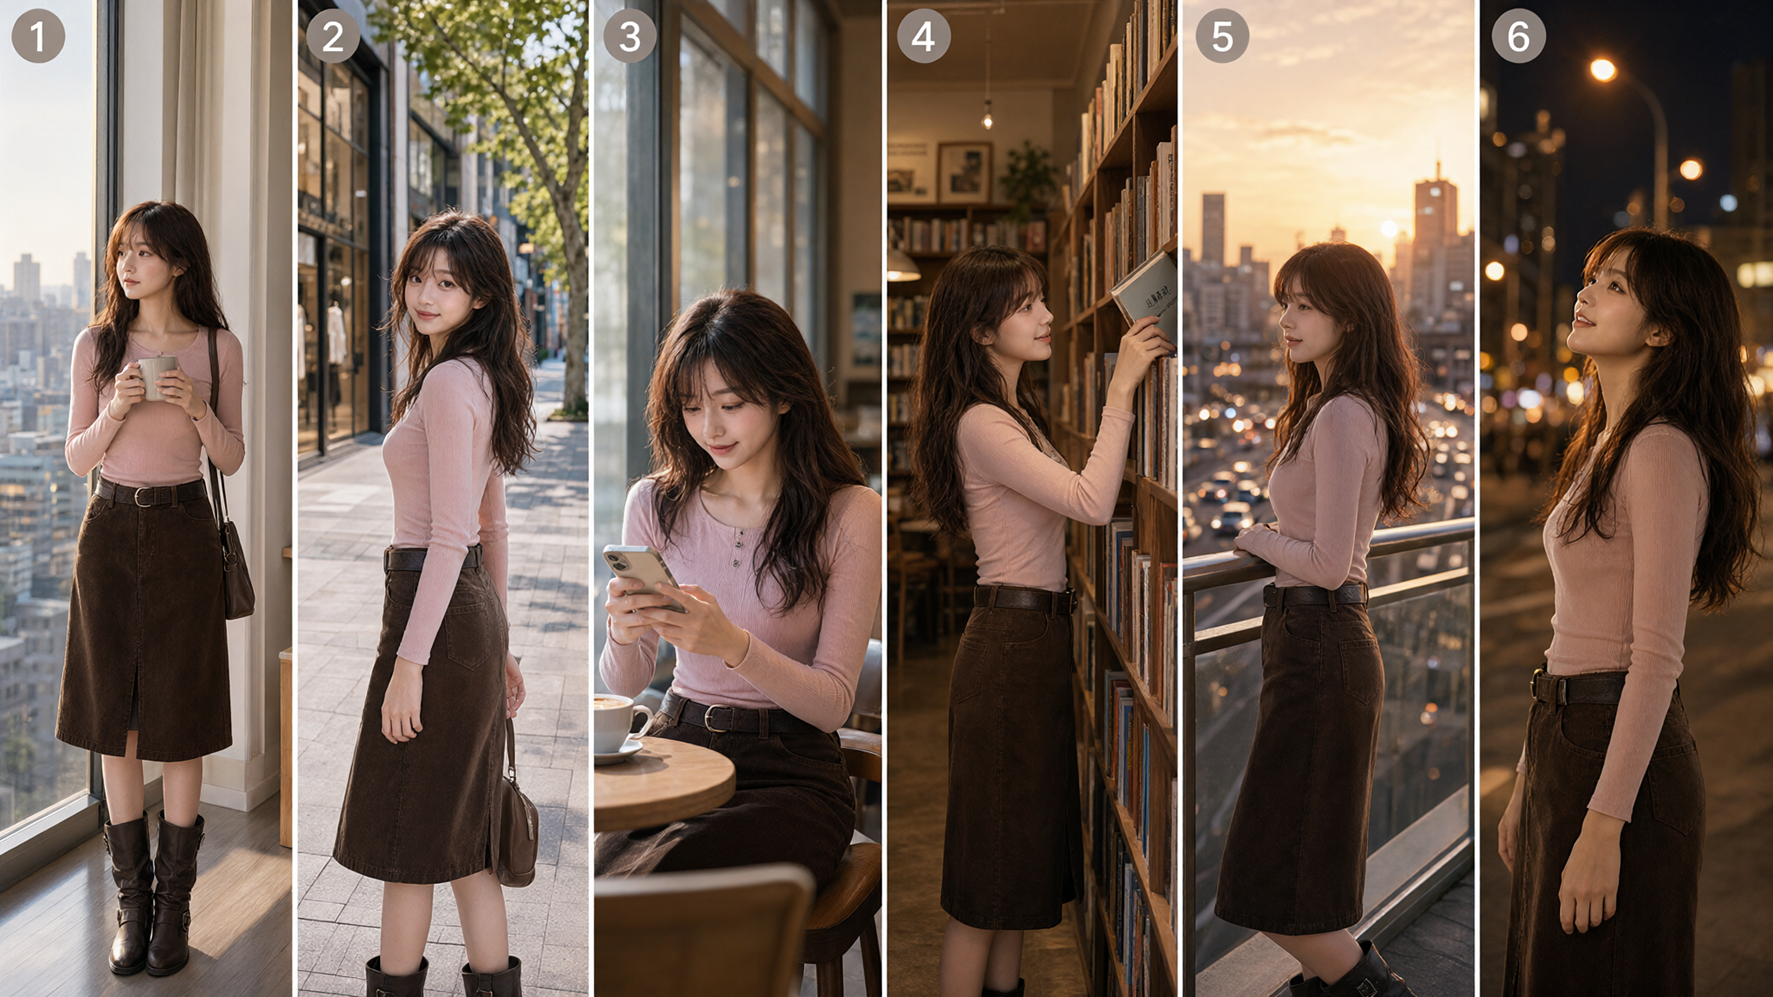
Beispiel 39: Dieselbe Person in mehreren Szenen. Zeigt Gesicht- und Kleidungserhalt bei wechselnden Posen und Orten.
Beispiel 40: Erläuterungsdiagramm eines Bauwerks. Erzeugung einer Unterlage mit Text, Zeichnung, Materialproben und Anmerkungen.
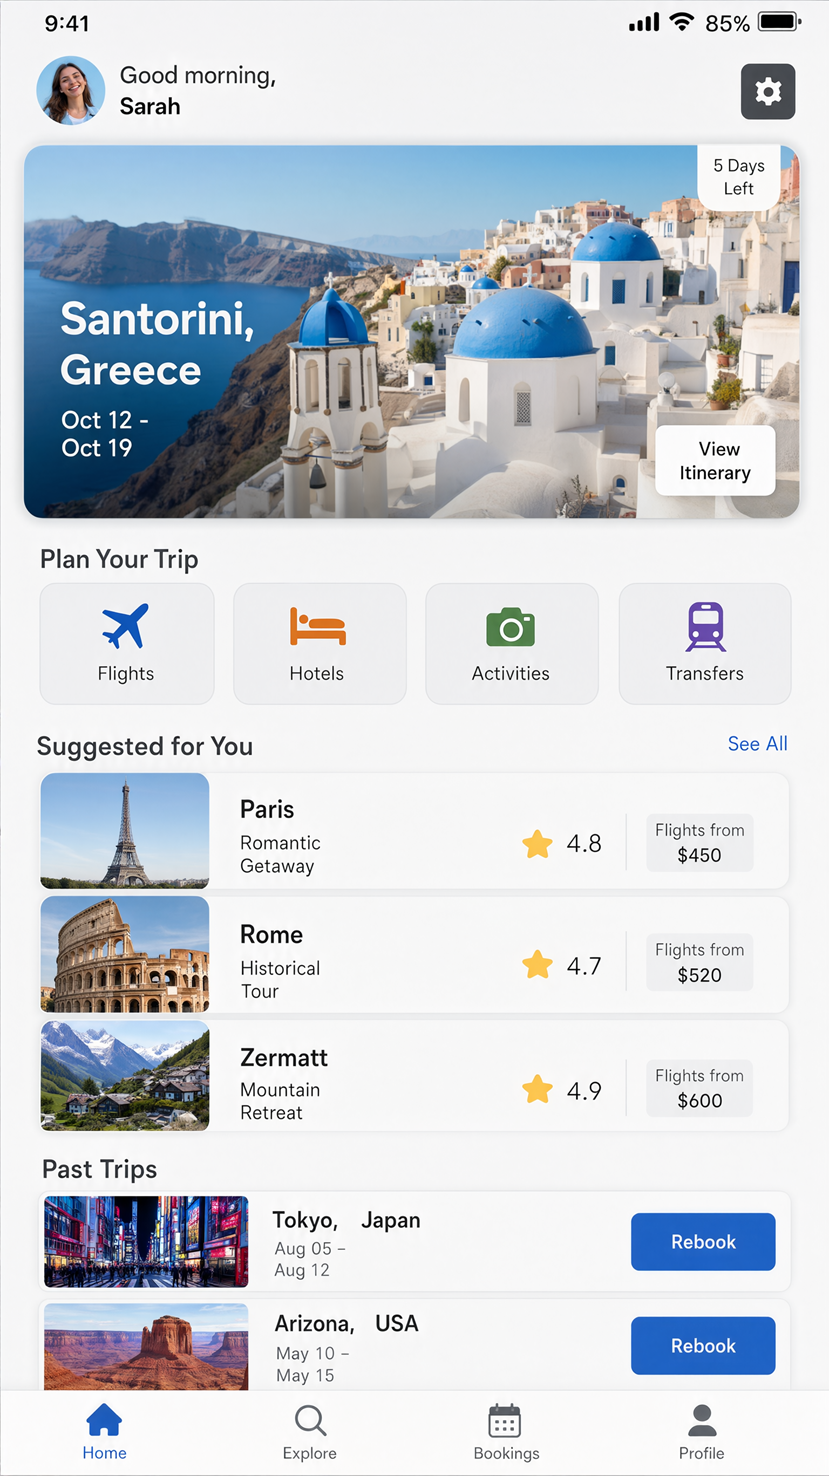
UI, Dokumente und natürliche Personenfotos
Beispiel 41: UI einer Reisebuchungs-App. Bildschirmgestaltung mit kleiner Schrift, Karten, Fotos und Buttons.
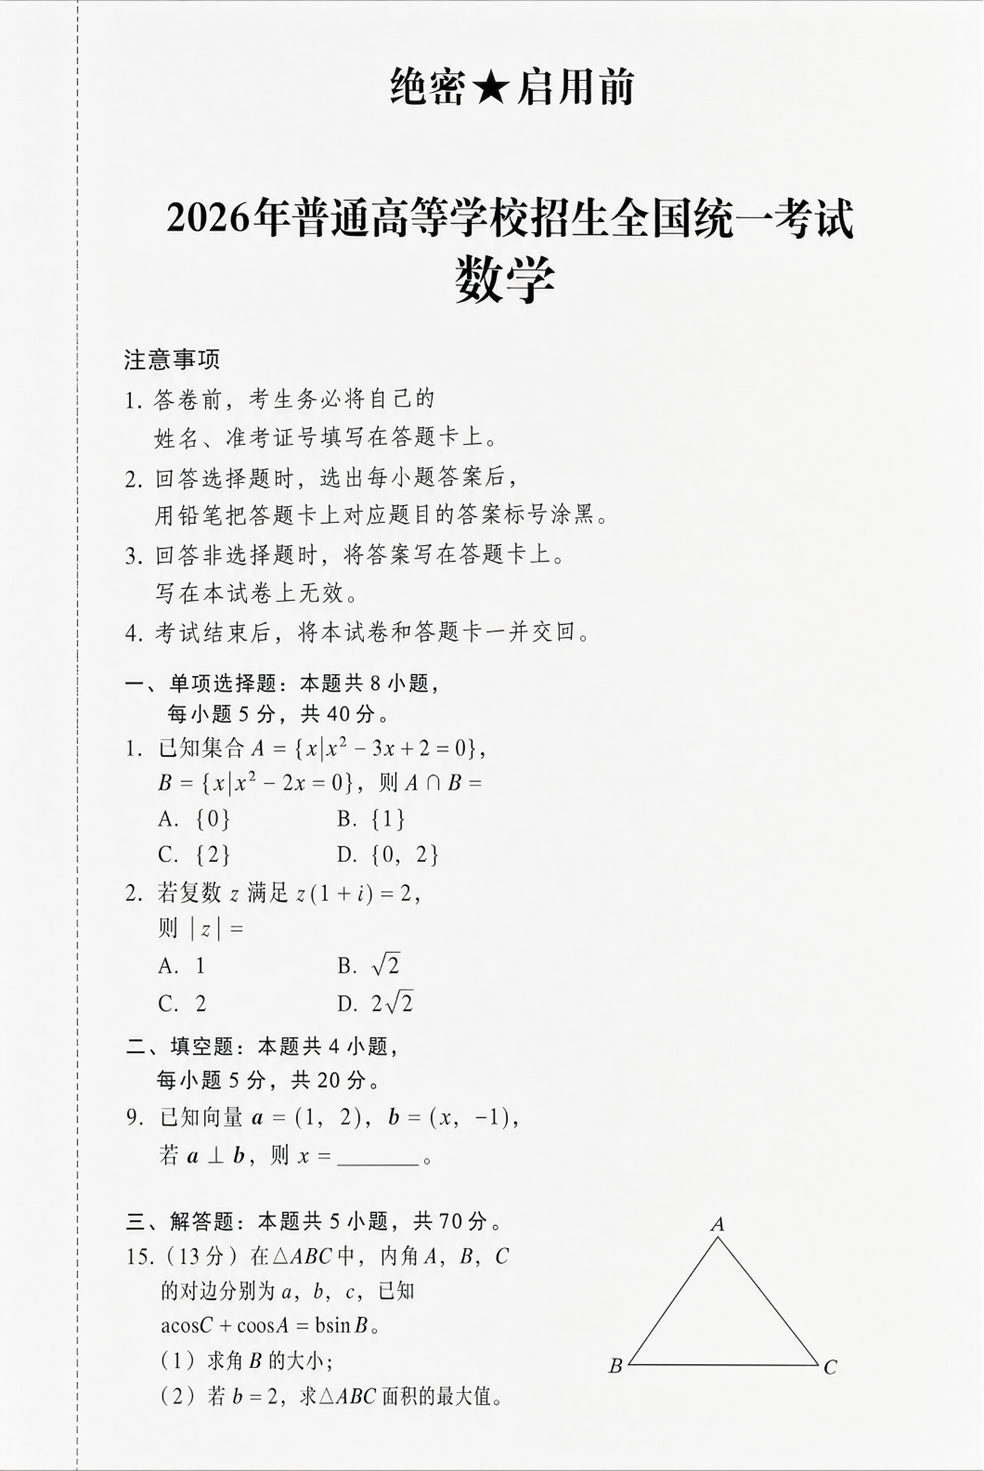
Beispiel 42: Dokument mit Geometrieaufgabe. Verdeutlicht die Schwierigkeit, Seiten mit langem Text und Formen zu erzeugen.
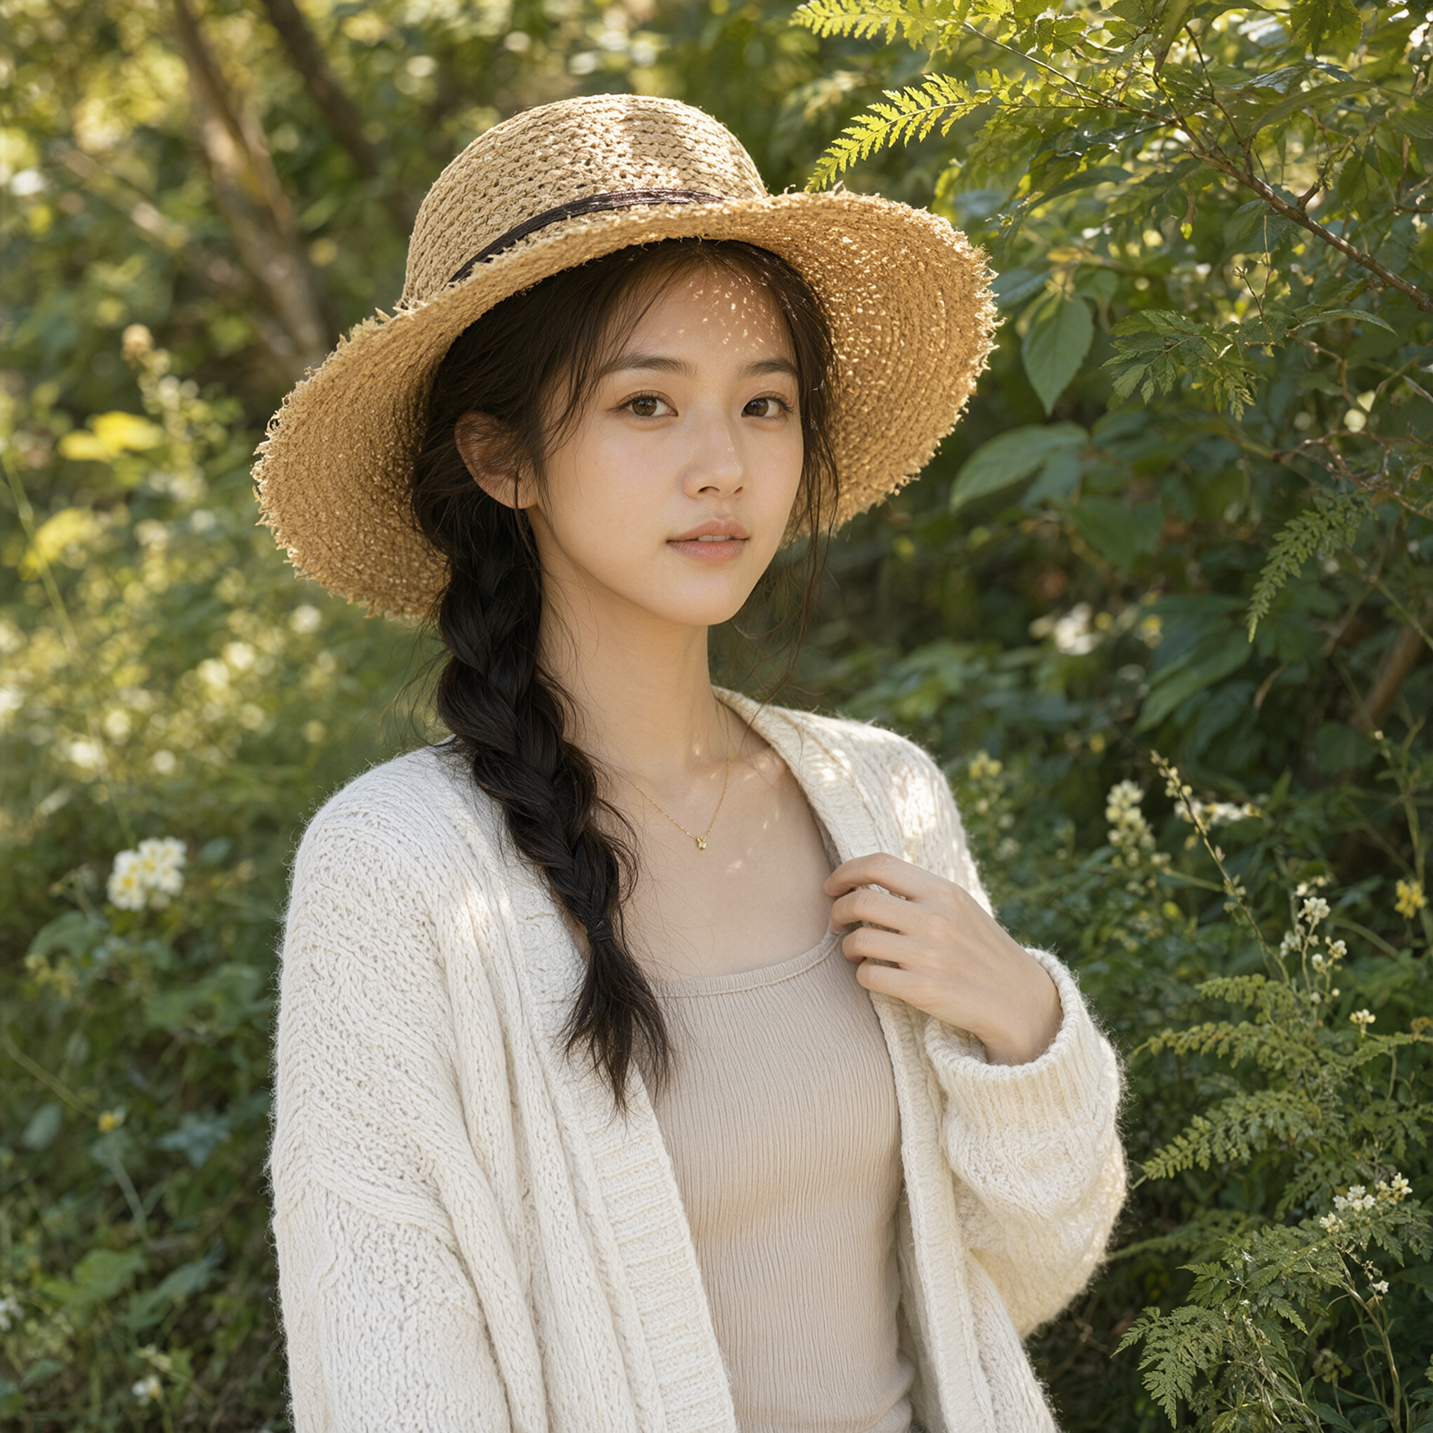
Beispiel 43: Porträt bei natürlichem Außenlicht. Darstellung von Hut, Haaren und durch Blätter fallendem Licht.
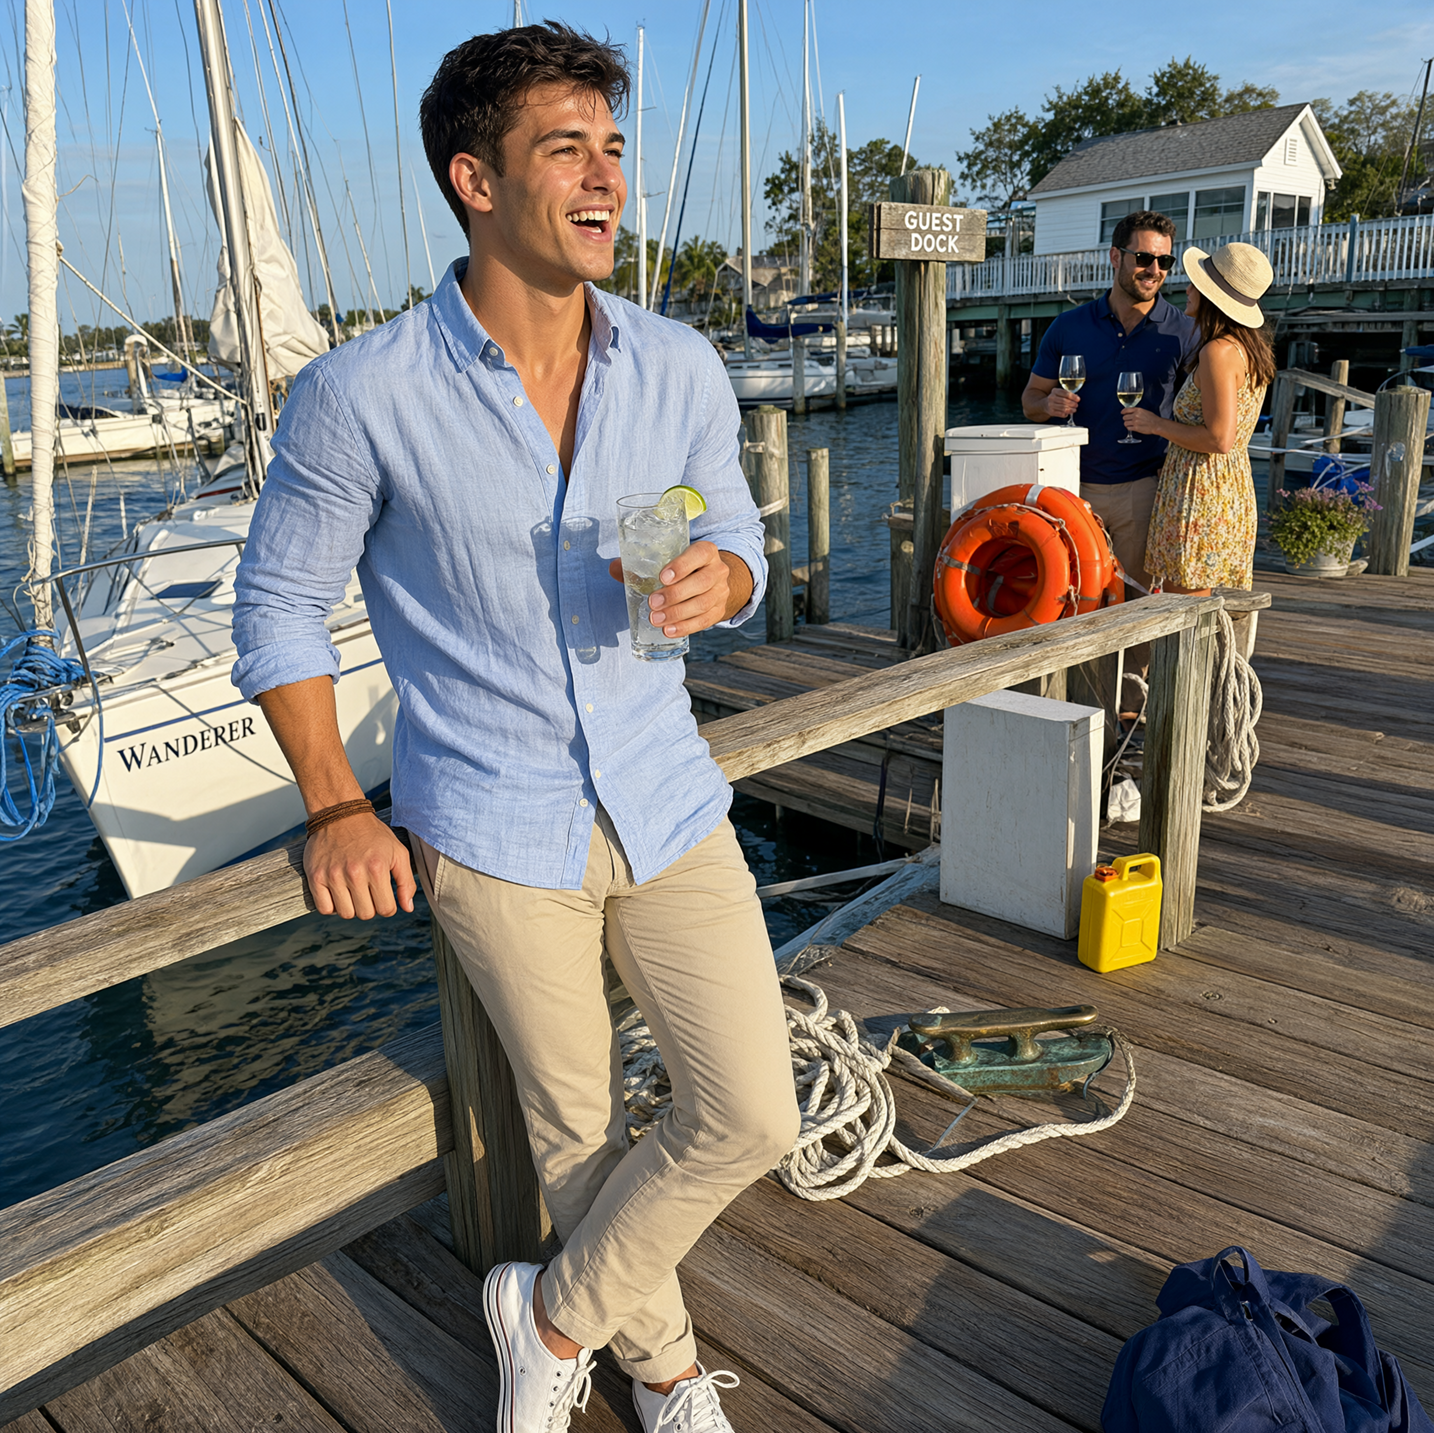
Beispiel 44: Personenfoto in einer Marina. Fotorealistisches Beispiel mit detailliertem Hintergrund wie Seilen, Booten und Werkzeugen.
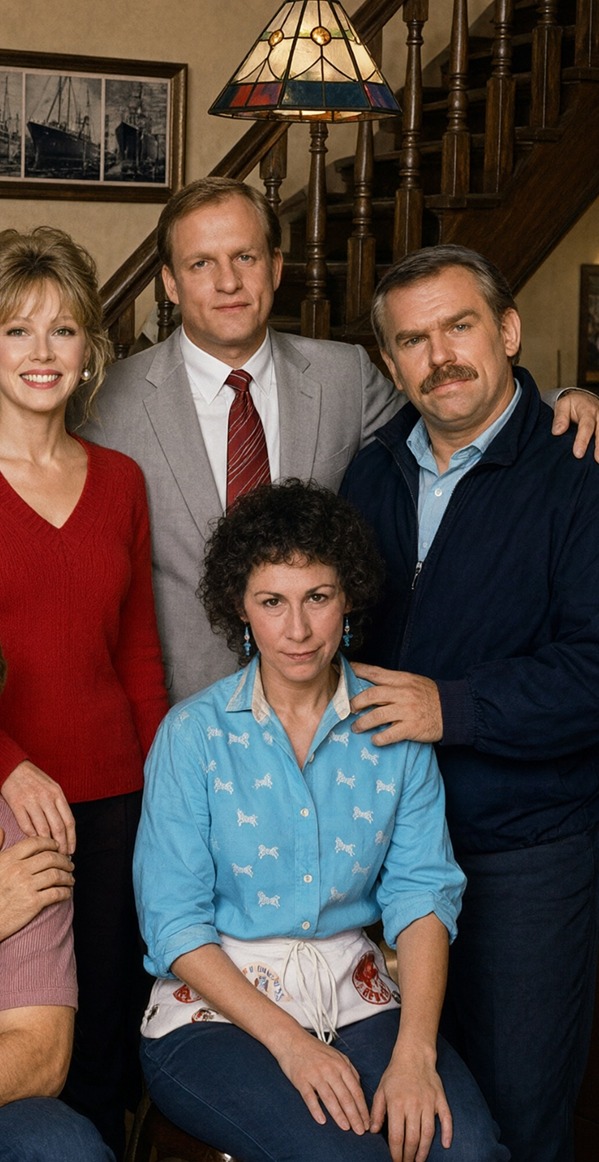
Vergrößerungen und weitere Perspektiven zum Vergleich
Beispiel 45: Vergrößerter Ausschnitt des Gruppenfotos. Prüft Gesichter, Posen und Licht, wenn mehrere Referenzen in einem Raum zusammengeführt werden.
Beispiel 46: Vergrößerter Raum nach der Möbelintegration. Aus einzelnen Produktreferenzen entstehen Perspektive und Licht für den ganzen Raum.
Beispiel 47: Quadratischer Ausschnitt nach Änderung der Kameraperspektive. Macht das Größenverhältnis von Turm und Person im Hintergrund besser sichtbar.
Beispiel 48: Vergrößerung des Charakterdesignbogens. Lokale Qualität von Gesichtvarianten, Text und Zubehör lässt sich prüfen.
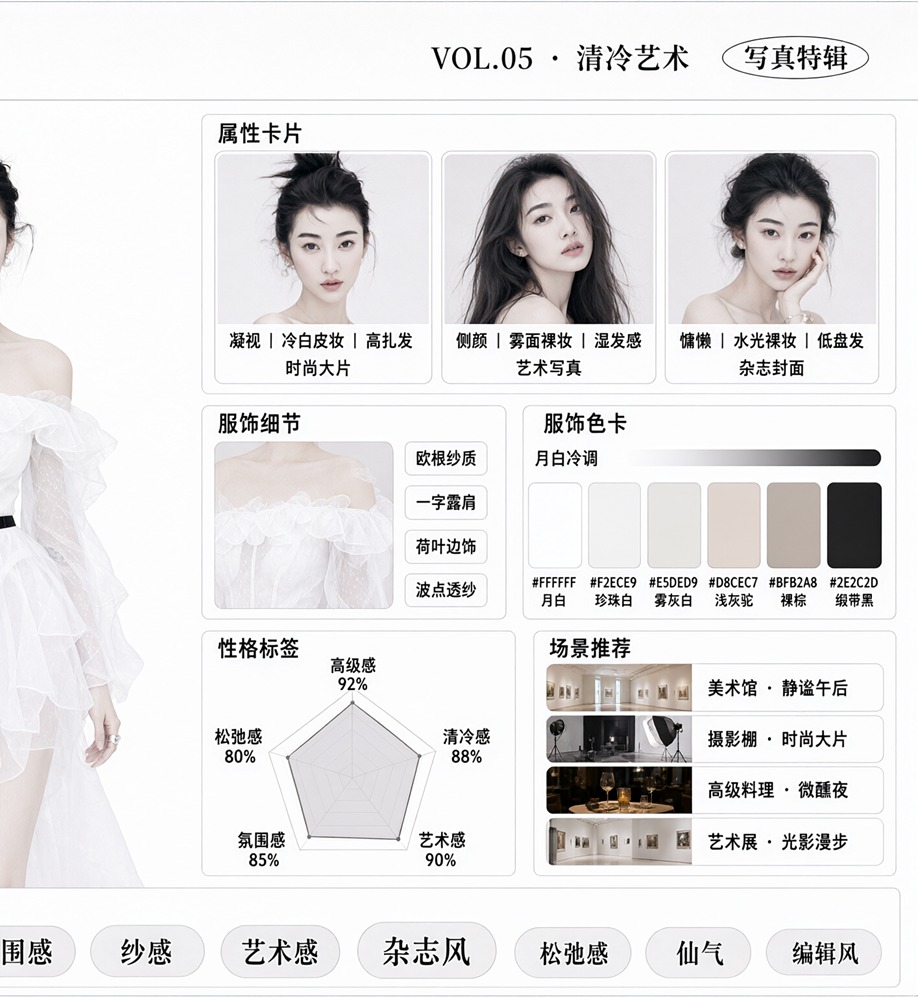
Beispiel 49: Vergrößerung eines Ausschnitts mit derselben Person in mehreren Szenen. Zeigt die für lange Produktionen wichtige Konsistenz von Kleidung und Gesicht.
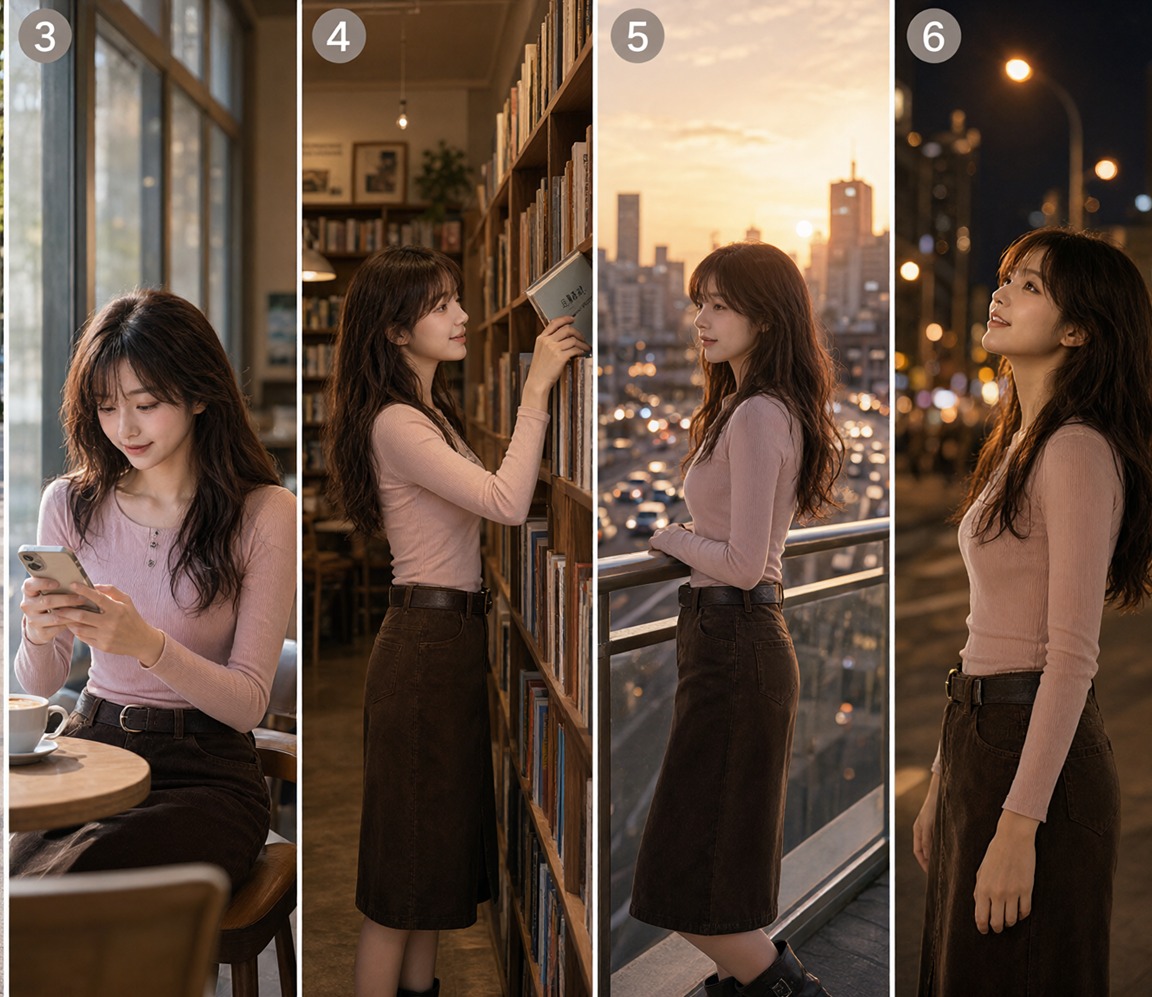
Beispiel 50: Vergrößerte Architekturinfografik. Veranschaulicht die kombinierte Herausforderung aus Linienzeichnung, Materialien, Anmerkungen und Weißraumgestaltung.
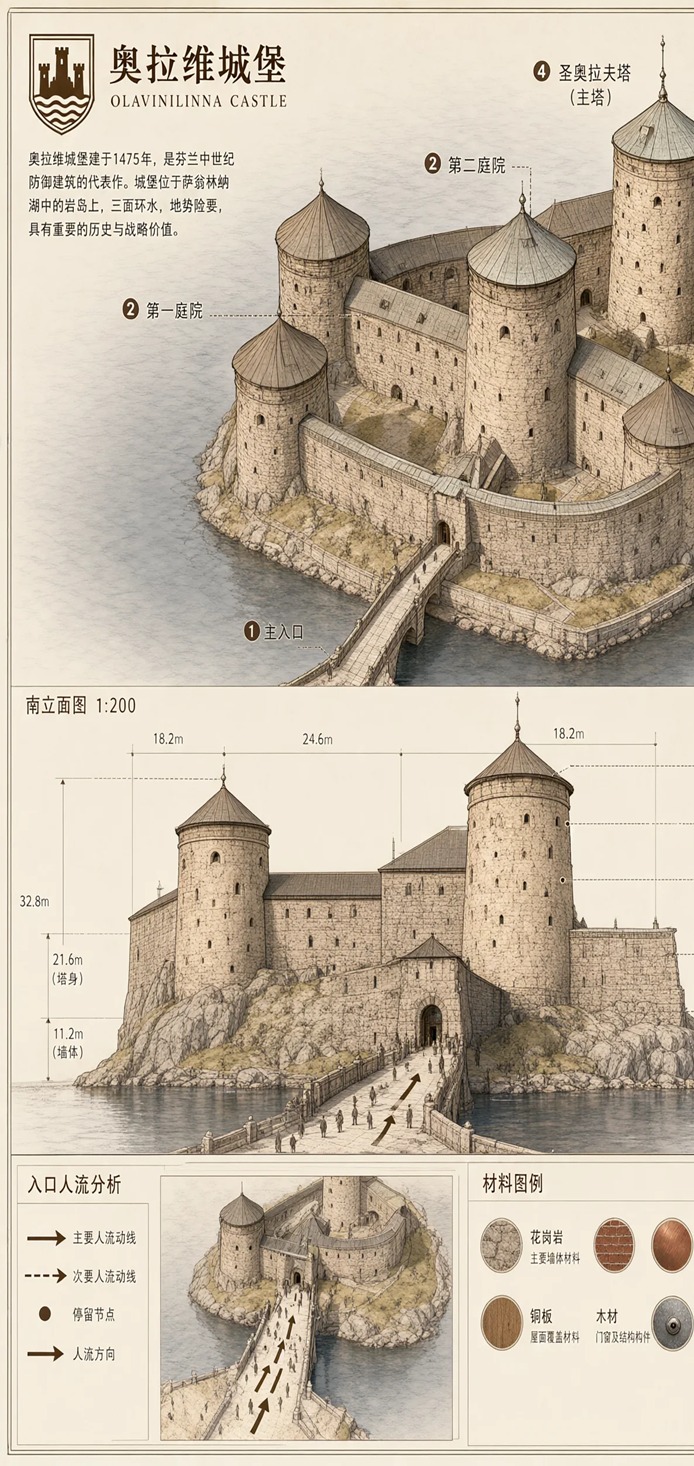
Bildquelle: offizielle Beispiele des Qwen-Teams zu „Qwen-Image-2.1“. Die sechs vergrößerten Ansichten sind für Vergleichserklärungen zugeschnittene Ausschnitte.
100 auf Reddit diskutierte Beispiele und Tests
Die folgende Liste ordnet 100 in wichtigen Reddit-Beiträgen zu Qwen-Image 2.1 tatsächlich diskutierte Muster für Bildgestaltung und Bearbeitung. Da sie subjektive Eindrücke der Beitragenden und Unterschiede zwischen Umgebungen enthält, ist sie kein Benchmark. Sie ist als praktischer Katalog gedacht, der zeigt, mit welchen Tests der Charakter des Modells sichtbar wird.
A. Personenfotos und Porträts (1–10)
- Amateurfoto einer Frau, das wie mit einem Smartphone aufgenommen wirkt.
- Alltagsportät in einem Supermarktgang.
- Personenfoto mit filmischem Gegenlicht.
- Neubeleuchtung einer Person vor nächtlicher Stadtkulisse.
- Gleichzeitige Änderung von Wetter und Tageszeit zu einer regnerischen Nacht.
- Modefoto, das die Hauttextur erhält.
- Rechte Seitenansicht aus niedriger Kameraposition.
- Kameraänderung von einer Frontaufnahme zu einem Dreiviertelwinkel.
- Neugenerierung eines Gesichts mit stark veränderter Mimik.
- Erzeugung eines „Referenzgesichts“ aus mehreren Beleuchtungsbedingungen.
Bemerkenswerte Quellen: 1girl-Test mit über 200 Bildern (ca. 1.483 Upvotes), früher Testbericht
B. Charakterkonsistenz (11–20)
- Bogen mit Vorder-, Seiten- und Rückansicht desselben Charakters.
- Einstellungsunterlage mit Gesichtsnahaufnahme und Ganzkörperbild.
- Erzeugung eines einheitlichen Gesichts aus einer 2×2-Gesichtsreferenz.
- Dieselbe Person an einem anderen Ort bei erhaltenem Gesicht.
- Dieselbe Person mit ausschließlich veränderter Kleidung.
- Dieselbe Person mit ausschließlich veränderter Frisur.
- Dieselbe Person mit ausschließlich ersetzter Pose.
- Dieselbe Person in fotorealistischer und Comic-Version.
- Mehrere Posen für aufeinanderfolgende Einstellungen.
- Nutzung eines Charakterbogens als Referenzmaterial für die Videogenerierung.
Bemerkenswerte Quellen: Charakterdesignbogen, Gesichtsreferenz aus vier Blickrichtungen (ca. 157 Upvotes), Qwen gegen FLUX.2 Krea (ca. 116 Upvotes)
C. Übertragung von Pose, Kamera und Komposition (21–30)
- Übertragung der Pose aus Referenz 2 auf die Person aus Referenz 1.
- Platzierung einer sitzenden Person auf einem gelben Stuhl aus einem anderen Bild.
- Änderung einer stehenden in eine sitzende Pose bei erhaltener Kleidung.
- Änderung einer Frontkomposition zu einer mittleren Einstellung aus niedrigem Winkel.
- Erweiterung des Bildausschnitts bei gleichbleibender Motivgröße.
- Übertragung einer Pose aus einem Pose-Studio-Bild auf eine fotorealistische Person.
- Umwandlung einer fotorealistischen Person in den Simpsons-Stil bei erhaltener Pose.
- Erhalt der Produktposition am Körper trotz Änderung des Kamerawinkels.
- Anwendung großer Schärfentiefe auf Vorder- und Hintergrund.
- Erstellung eines Gruppenfotos, ohne die Anordnung mehrerer Personen zu zerstören.
Bemerkenswerte Quellen: Tipps zur Bearbeitung (ca. 513 Upvotes), Editing Beast (ca. 840 Upvotes)
D. Produkte, Werbung und virtuelle Anprobe (31–40)
- Gesamtweiser Ersatz zerdrückter Coladosen durch Dosen eines anderen Produkts.
- Änderung nur von Farbe und Design bei erhaltener Verformung der Dose.
- Spiegelung der Produktfarbe auf umgebenden weißen Flächen.
- Natürliches Anbringen einer Uhr aus einem anderen Bild am Handgelenk einer Person.
- Uhrenwerbung bei erhaltener Pose, Körperform und Beleuchtung.
- Anprobe mit fünf Referenzen für Model, Kleidung, Schuhe, Tasche und Hut.
- Platzierung eines Logos aus einem anderen Bild auf einem Produktfoto.
- Austausch nur der Verpackung bei erhaltenem Foto-Set.
- Freistellung eines Produkts mit transparentem Hintergrund für E-Commerce.
- Darstellung desselben Produkts mit mehreren Hintergründen und Beleuchtungen.
Bemerkenswerte Quellen: Editing Beast (ca. 840 Upvotes), Mehrfachreferenz-Beispiele im offiziellen Blog
E. Bearbeitung von Hintergrund, Licht und Material (41–50)
- Änderung eines Tageshintergrunds in eine regnerische Nacht.
- Austausch nur des Hintergrunds bei erhaltener Person.
- Gleichzeitige Übertragung von Beleuchtung und Hintergrund eines Referenzbilds.
- Ersatz einer Wand durch die grüne Textur eines anderen Bildes.
- Änderung eines Innenraums zu warmem Abendlicht.
- Änderung zu scharfem Licht im Stil eines High-Fashion-Shootings.
- Neuberechnung der Schatten einer Person passend zum Hintergrundlicht.
- Vergleich der fotorealistischen Wirkung von normalem und Brownian Noise.
- Vergleich der Textur von Euler und einem Custom-Sampler mit Eta 0,50.
- Kombination von Schärfe und Natürlichkeit mit einem zweistufigen Sampler.
Bemerkenswerte Quellen: Tipps zur Bearbeitung, Thread zur Einstellungserprobung (ca. 80 Upvotes)
F. Transparente PNGs, Freistellung und lokale Bearbeitung (51–60)
- PNG eines einzelnen Charakters mit transparentem Hintergrund.
- Transparentes Produkt-Asset.
- Transparentes Design-Asset aus mehreren Elementen.
- Extraktion nur der Person aus einem Foto.
- Bearbeitung eines Motivs auf einer transparenten Ebene.
- Inpainting einer Form einschließlich ihrer Alphagrenze.
- Gleichzeitige Änderung von Kopfhörerform und transparentem Bereich.
- Austausch nur eines rot eingefärbten Kleidungsbereichs.
- Bearbeitung nur eines eingekreisten Zubehörteils.
- Lokale Bearbeitung mit vollständiger Wiederherstellung außerhalb der Maske.
Bemerkenswerte Quellen: Alphabearbeitung mit LanPaint (ca. 77 Upvotes), früher Testbericht
G. Outpainting und Restaurierung (61–70)
- Erweiterung der Leinwand nur nach links.
- Erweiterung der Leinwand nur nach rechts.
- Erweiterung der Leinwand nur nach oben.
- Erweiterung der Leinwand nur nach unten.
- Gleichzeitige Erweiterung nach links, rechts und unten.
- Ergänzung leerer Bereiche eines schräg geneigten Fotos.
- Rekonstruktion eines durch schlechten Beschnitt fehlenden Hintergrunds.
- Ergänzung des Umfelds eines teilweise angeschnittenen Motivs.
- Weitwinkligere Darstellung bei erhaltenem Originalhintergrund.
- Vergleich von Körnung und Kontrastveränderungen bei der Restaurierung alter Fotos.
Bemerkenswerte Quellen: Outpainting-Test (ca. 62 Upvotes), kritischer Test zur Fotorestaurierung
H. Poster, Text und Grafikdesign (71–80)
- Veranstaltungsposter mit großer Überschrift.
- Werbedesign, bei dem Komposition und Informationshierarchie vorher festgelegt werden.
- Vergleich zur Stabilisierung großer Schrift bei 2 bis 2,5 MP.
- Vergleich zur Steigerung der Detailtiefe textfreier Visuals bei rund 4 MP.
- Verpackungsdesign mit Produktnamen.
- Grafik mit „Qwen“ auf einem Vintage-Fernseher.
- Natürliches Compositing von Schildern oder Logos in ein anderes Bild.
- Komplexes Layout durch einen langen Prompt.
- Test zu fehlerhaftem Text und chinesischen Zeichen in englischen Infografiken.
- Poster zum Vergleich der Designqualität mit GPT-basierten Bildmodellen.
Bemerkenswerte Quellen: Prompt-Vorlage für Design, Kurzbericht und Beispiel mit Vintage-TV
I. Stiltransfer, Illustration und narrative Produktion (81–90)
- Umwandlung eines fotorealistischen Bilds in einen Comic-Stil.
- Umwandlung einer fotorealistischen Person in den Simpsons-Stil.
- Übertragung ausschließlich des Bildstils einer Referenz auf ein anderes Bild.
- Farbtonänderung bei erhaltenem Charakter und Hintergrund.
- Bildgenerierung im Stil eines Polaroidfotos.
- Erzeugung eines Storyboards im Vier-Panel-Format.
- Darstellung derselben Person in mehreren Szenen.
- Zusammenhängende Erzählbilder mit erhaltenen Tieren, Fahrzeugen und Personen.
- Bildgestaltung im Stil eines modernen Anime-Screenshots.
- Vergleich von Fehlschlägen, bei denen Anime-Stile in Richtung Fotorealismus gezogen werden.
Bemerkenswerte Quellen: Polaroid-Experiment, Vergleich mit Krea 2 für Anime-Anwendungen, früher Testbericht
J. Workflow, Geschwindigkeit und Qualitätsvergleiche (91–100)
- Vergleich von Komposition, Textur und Kontrast bei CFG 1 bis 5.
- Vergleich zwischen CFG unter 2 und dem „überbackenen“ Ergebnis bei CFG 4.
- Schnelle Generierung mit 16 Schritten, 1 MP und INT8.
- Test der Bearbeitungsqualität bei 25 Schritten und 2K.
- Upscaling von 2K auf 4K nach 30 Schritten.
- Bearbeitung mit einer 4-Step-LoRA für etwa doppelte Geschwindigkeit.
- Personengenerierung mit 8 Schritten bei 1024×1280 auf einer RTX 3060 in etwa 45 Sekunden.
- Geschwindigkeitsvergleich von Qwen und FLUX.2 Krea für Charakterbögen.
- Test der Pixelpräzision bei 2K und der Zusammenführung von zehn Referenzbildern.
- Vergleich zur Unterdrückung von Detailrauschen mit Fix v2.0 und Spezial-Sampler.
Bemerkenswerte Quellen: Thread zur Veröffentlichung der ComfyUI-Modelle (ca. 106 Upvotes), 4 Schritte bei wenig VRAM (ca. 44 Upvotes), Experimentergebnisse, Fix v2.0
Zusammenfassung der Reddit-Bewertungen
Besonders gelobte Punkte
- Bearbeitungsleistung: Farbe, Hintergrund, Materialien, Pose und Produkte lassen sich verändern, während das Originalbild vergleichsweise gut erhalten bleibt.
- Mehrfachreferenzen: Stark für Produktionen, die Personen, Produkte, Kleidung und Zubehör kombinieren.
- Charakterkonsistenz: Vielversprechend als Ausgangspunkt für Einstellungsunterlagen und zusammenhängende Bildfolgen.
- Transparente Bilder: Nicht nur Freistellung; auch der Alphakanal selbst kann generiert und bearbeitet werden.
- Outpainting: Praktisch für die gleichzeitige Erweiterung in mehrere Richtungen.
- Größe und Geschwindigkeit: Für einen 7B-Generierungsteil praxisnah und mit vielen Optionen für Quantisierung und Beschleunigung.
Wiederholt genannte Schwächen
- Hände, Finger, Arme und komplexe menschliche Anatomie sind instabil.
- Gesichter im Hintergrund und feine Linien brechen leicht auseinander.
- Standardausgaben können einen rauschigen Eindruck und unruhige Details zeigen.
- Der Kontrast ist teils stark; Schwarztöne können zu sehr absaufen.
- Bei der Fotorestaurierung werden ursprüngliche Körnung oder feine Formen manchmal eigenmächtig verändert.
- Es gibt Kritik an gedrungenen Körperproportionen in Charakterbögen.
- Mit mehr Referenzbildern treten Eigenschaftsvermischungen und Halluzinationen leichter auf.
- Einige Anime-Stile werden in eine fotorealistische oder filmische Richtung gezogen.
- Es gibt zwar gute Textbeispiele, doch kleine Schrift und englische Infografiken bleiben instabil.
- Einstellungen, Prompt-Rewriting und Sampler haben großen Einfluss auf die Ergebnisse.
Aus diesen Vor- und Nachteilen wird deutlich: Qwen-Image 2.1 ist kein „universelles Modell, das mit einem Versuch perfekt funktioniert“, sondern ein Produktionsmodell für Bearbeitung, das mit sorgfältigen Einstellungen und ausgefeilten Workflows deutlich besser wird.
Praktischer Einstieg
In ComfyUI sollte zunächst auf die aktuelle Version aktualisiert und dann Text-to-Image oder Image Edit aus den integrierten Vorlagen ausgewählt werden. Auch die offiziell unterstützten Workflows sind auf GitHub veröffentlicht. Es empfiehlt sich, erst mit den offiziellen 40 Schritten ein Referenzbild zu erstellen und anschließend mit 16, 8 und 4 Schritten Geschwindigkeit und Qualität zu vergleichen.
Bei Bearbeitungen ist eine vage Anweisung wie „Mach es besser“ weniger aussagekräftig. Die folgende Reihenfolge erleichtert Tests:
- Was soll geändert werden?
- Aus welchem Referenzbild soll es übernommen werden?
- Was darf auf keinen Fall verändert werden?
- Wie sollen Licht, Hintergrund, Körperform, Pose und Komposition erhalten bleiben?
- Welche fehleranfälligen Elemente gehören in eine negative Anweisung?
Für ein Produkt-Compositing sollte etwa klar formuliert werden: „Behalte die Person und Pose aus Bild 1 bei und bringe nur die Uhr aus Bild 2 am Handgelenk an. Verändere Körperform, Hintergrund und Beleuchtung nicht.“ Bei mehreren Referenzen ist es wichtig, die Zuordnung von <image1> und <image2> eindeutig zu halten.
Bei transparenten Bildern werden in auf Reddit geteilten Beispielen ausdrücklich „RGBA image“, „alpha channel“ und „background is transparent“ genannt. Wenn auch die transparente Kante bearbeitet werden soll, empfiehlt sich eine alphafähige Maskenverarbeitung wie LanPaint.
Für wen eignet sich das Modell?
Qwen-Image 2.1 passt gut zu folgenden Einsatzbereichen:
- Personen, die lokal mit ComfyUI produzieren möchten.
- Personen, die nur einzelne Teile von Personen oder Produkten verändern möchten.
- Teams, die mehrere Referenzmaterialien in einer Anzeige oder Szene zusammenführen möchten.
- Personen, die Charakterunterlagen oder Referenzbilder für Videos erstellen möchten.
- Personen, die transparente PNGs oder Assets für Spiele und das Web benötigen.
- Forschungs- und Entwicklungsteams, die APIs für Bildgenerierung und -bearbeitung auf eigenen Servern betreiben möchten.
Weniger geeignet ist es ohne weiteren Vergleich und Lizenzprüfung für vollständige Fotorestaurierung, strikt identische Charaktere über lange Serien, komplexe Posen mit wichtigen Händen, Infografiken mit dichter kleiner Schrift oder eine vorbehaltlose kommerzielle Einführung.
Fazit
Der Kern von Qwen-Image 2.1 besteht darin, einen relativ kleinen Generierungsteil mit 7 Milliarden Parametern mit T2I, Bildbearbeitung, bis zu zehn Referenzen, lokaler Bearbeitung, transparentem RGBA und Motiveextraktion zu vereinen. Das größte Interesse auf Reddit gilt entsprechend nicht der einfachen Generierung attraktiver Figuren, sondern Anwendungen, die Produktionsschritte verkürzen: Austausch von Uhren oder Dosen, Charakterbögen, Übertragung von Hintergrund und Licht, Outpainting und Alphabearbeitung.
Die Bewertung der Beispiele hängt jedoch stark von den Einstellungen ab. CFG, Sampler, Schrittzahl, Auflösung, Prompt-Rewriting und beschleunigende LoRAs können die Resultate so stark verändern, dass sie kaum wie Ergebnisse desselben Modells wirken. Am sichersten ist es, zunächst mit der offiziellen Konfiguration eine Referenz zu erzeugen, Änderungen einzeln zu vergleichen und für wichtige Projekte Blindvergleiche mit anderen Modellen durchzuführen.
Der wichtigste Hinweis betrifft die Lizenz. Veröffentlichte Gewichte bedeuten nicht automatisch freie kommerzielle Nutzung. Technisch ist das Modell äußerst attraktiv, doch für den geschäftlichen Einsatz sollten die offizielle Lizenz und die aktuellen Bedingungen geprüft werden.
Wichtige Links
- Offizieller Blog zu Qwen-Image 2.1
- Offizielles GitHub-Repository
- Hugging Face Diffusers-Dokumentation
- Modelle für ComfyUI
- Reddit: 1girl-Beispielsammlung
- Reddit: Editing Beast
- Reddit: Bearbeitungstipps
- Reddit: Outpainting
- Reddit: Inpainting des Alphakanals
- Reddit: Qwen-Image 2.1 Fix v2.0
※ Dieser Artikel basiert auf offiziellen Informationen und öffentlichen Community-Beiträgen vom 4. Oktober 2026. Reddit-Upvotes, Werkzeuge im Umfeld des Modells und Lizenzbedingungen können sich ändern.