GPT-2 von Grund auf mit einer einzigen RTX 4090 gebaut: In einem Tag besser als das Original und chatfähig gemacht
Ich habe GPT-2 (124M) von Grund auf mit einer einzigen RTX 4090 zu Hause trainiert. Von der Datenvorbereitung über das Vortraining bis zum Instruction Tuning (SFT), damit das Modell chatten kann – alles lief auf meinem eigenen PC.
Das Fazit vorweg:
- Das Vortraining war nach rund 21 Stunden abgeschlossen. Beim Common-Sense-Reasoning-Test HellaSwag erreichte das Modell 30,5 % und übertraf damit die 29,4 % des originalen GPT-2 124M.
- SFT dauerte knapp zwei Stunden. Bereits fünf Minuten nach Trainingsbeginn klangen die Antworten wie ein Gespräch.
- Inhaltlich war es allerdings voller Halluzinationen. Aussagen wie „Paris hat 2,4 Milliarden Einwohner“ oder „12+7=30“ kamen ganz selbstverständlich.
Es war spannend zu beobachten, wie GPT-2 nach und nach schlauer wurde, deshalb halte ich den Prozess hier fest.
Umgebung
- GPU: RTX 4090 (24 GB)
- CPU: i7-13700K / 64 GB RAM
- OS: Windows 11 (ohne WSL, direkt unter Windows)
- PyTorch 2.11 nightly (CUDA 12.8) + triton-windows
Der Code folgt demselben Ansatz wie Karpathys nanoGPT/build-nanogpt. Ich habe Claude Code gebeten: „Erstelle ein GPT-2, das auf der GPU dieses PCs innerhalb eines Tages trainierbar ist.“ Von der Architekturplanung über die Skripterstellung bis zur Überwachung des Trainings hat es mich dabei begleitet.
Datenvorbereitung: 10B Token in 12 Minuten bereit
Als Trainingsdaten diente die 10B-Token-Version von FineWeb-Edu (hochwertige englische Webtexte mit Bildungsbezug). Als Parquet-Dateien umfasst sie rund 27 GB.
Anfangs erreichte der Download über das normale Hugging Face nur 1,7 MB/s – das hätte über vier Stunden gedauert. Nach der Installation von hf_transfer waren es 60–70 MB/s; eine 2-GB-Datei war in 30 Sekunden da. Damit verlagerte sich der Flaschenhals auf die Tokenisierung, und Download und Tokenisierung zusammen waren nach rund 12 Minuten erledigt.
Übrigens hatte ich anfangs HF_HOME, mit dem sich der Cache-Speicherort ändern lässt, nach dem Import von huggingface_hub gesetzt. Dadurch griff die Einstellung nicht, und die Dateien wurden auf ein anderes Laufwerk heruntergeladen. Diese Umgebungsvariable wird beim Import eingelesen – also vor dem Import setzen. Ein unscheinbarer Stolperstein.
Trainingseinstellungen
| Punkt | Inhalt |
|---|---|
| Modell | GPT-2 small (12 Schichten, 768 Dimensionen, 124 Millionen Parameter) |
| 1 Schritt | Rund 520.000 Token (16×1024, 32-mal Gradientenakkumulation) |
| Anzahl Schritte | 16.000 (rund 8,4B Token) |
| Geschwindigkeit | Rund 120.000 Token/Sekunde |
| VRAM | Rund 12 GB |
Oft hört man, dass torch.compile unter Windows nicht funktioniert und man deshalb WSL nutzen müsse. In dieser Umgebung mit triton-windows lief es jedoch direkt.
Mit allen 10B Token hätte das Training mehr als 24 Stunden gedauert, deshalb habe ich es auf 8,4B Token gekürzt, damit es in einen Tag passt.
Als kleinen Trick habe ich die Vokabulargröße von 50257 auf 50304 (ein Vielfaches von 128) aufgerundet. Das ist Karpathys bekannte Optimierung für schnellere GPU-Matrixberechnungen – und sie erwies sich später beim Chat-fähig-Machen unerwartet als nützlich.
Zwischenfall: Das Training stoppte nach 2,5 Stunden
Als ich den Fortschritt überprüfte, war das Training angehalten. Ursache waren die Evaluierungsdaten von HellaSwag. Code im nanoGPT-Stil lädt die Daten von GitHub rowanz/hellaswag, aber dort erschien „451 Unavailable For Legal Reasons“ – die Veröffentlichung war aus rechtlichen Gründen eingestellt worden. Die 404-Fehlermeldung ließ das gesamte Training zusammen mit der Auswertung abstürzen.
Ich stellte es auf Rowan/hellaswag bei Hugging Face um (inhaltlich dieselben 10.042 Fragen) und setzte das Training von einem Checkpoint fort, der alle 500 Schritte gespeichert worden war. Außerdem umschloss ich die Auswertung mit try/except, damit ein Fehler bei der Evaluation das Training nicht mehr stoppt.
Bei langen Trainingsläufen darf ein Fehler in Dingen „außerhalb des Kerns“, etwa Evaluation oder Logging, nicht das Training zum Absturz bringen. Das ist wichtig.
Ergebnis: Das originale GPT-2 übertroffen
Der Loss auf den Validierungsdaten sah so aus. In der ersten Stunde fiel er steil ab und sank danach langsam weiter.
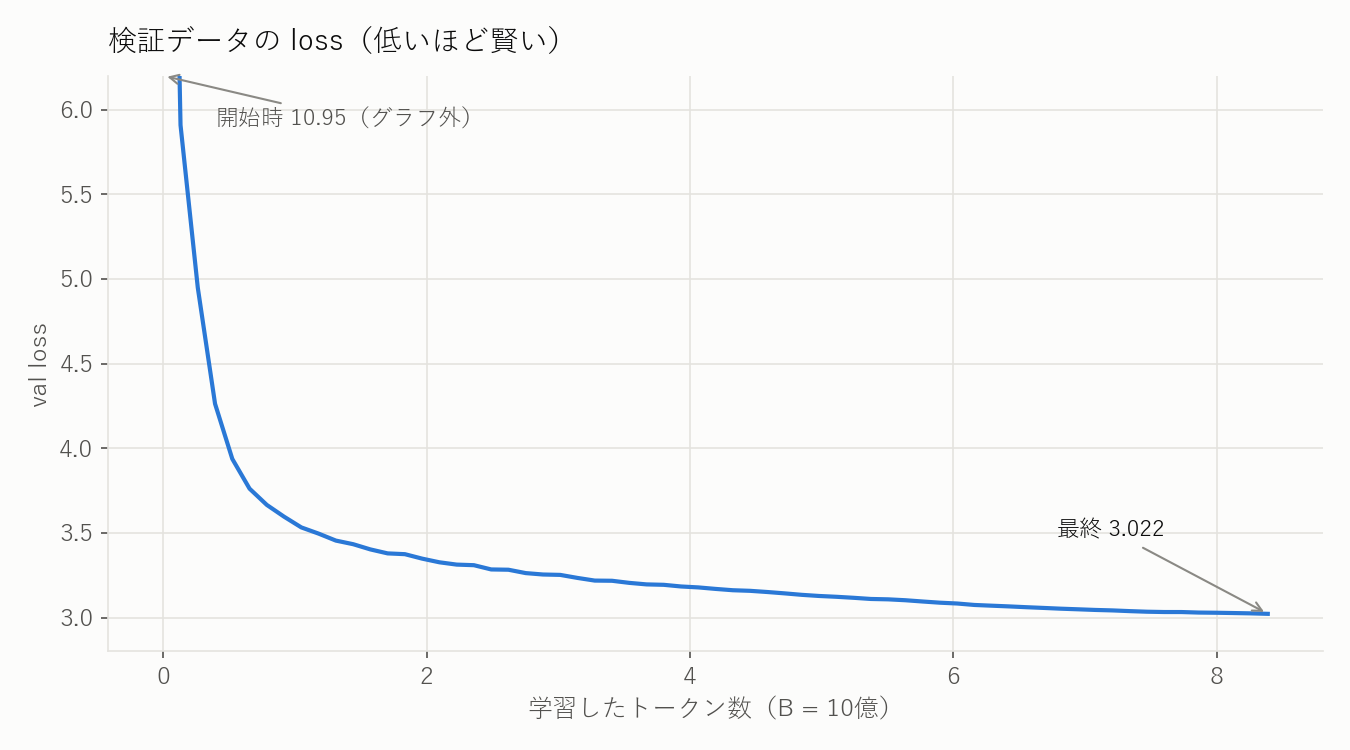
Der anfängliche Loss von 10,95 liegt fast bei ln(50304)≒10,83. Das heißt: Das Modell startete damit, aus 50.000 Wörtern völlig blind zu raten.
Die HellaSwag-Genauigkeit entwickelte sich so:
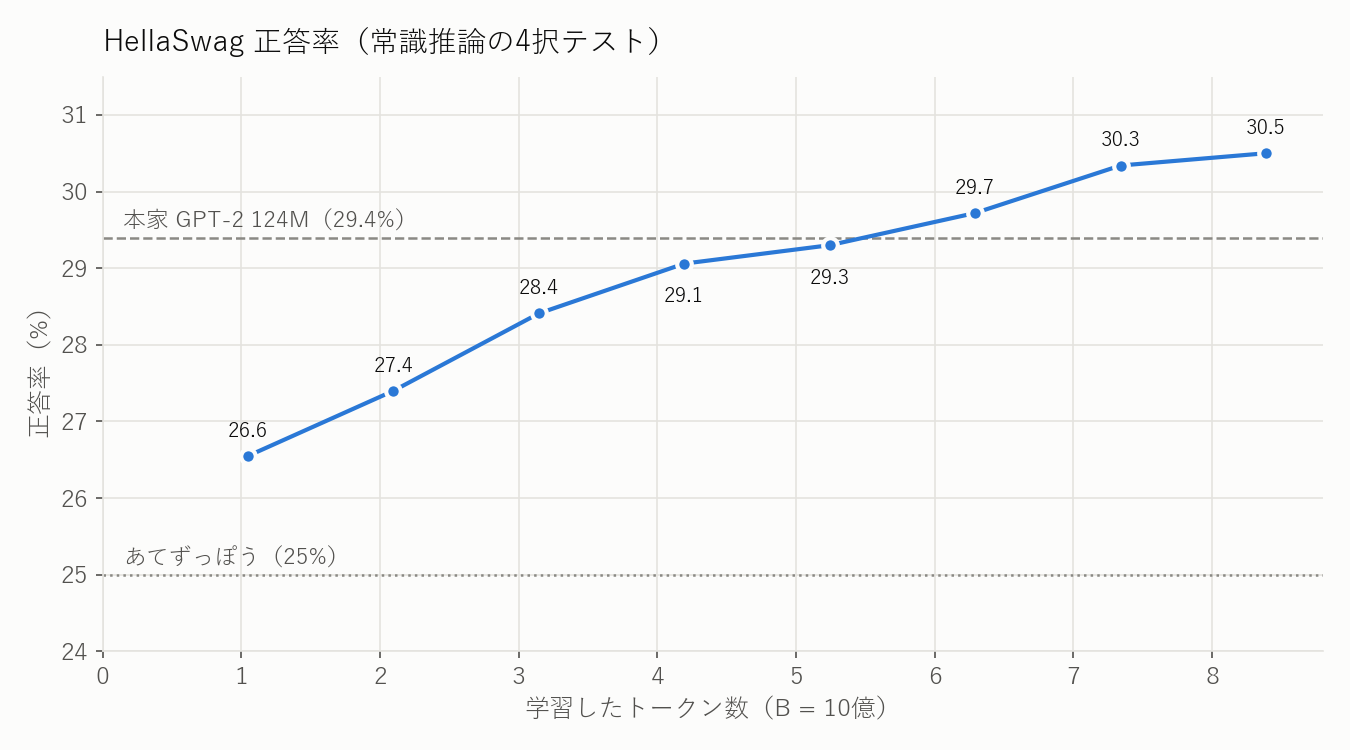
Nach rund 6,3B Token (Schritt 12.000) übertraf das Modell die 29,4 % des originalen GPT-2 124M und endete bei 30,5 %. Das Original-GPT-2 wurde auf WebText trainiert. Dieses Modell nutzte FineWeb-Edu; vermutlich machte sich die höhere Qualität der bildungsbezogenen Daten bemerkbar.
Wie es nach und nach schlauer wurde
Während des Trainings erzeugte ich stündlich mit demselben Prompt Text und zeichnete ihn auf. Das war der spannendste Teil.
Vor dem Training (zufälliger Zustand)
Hello, I'm a language model,CHR 351ointment Education rodents Effectiveantically emulatorprot grievance...
Die Wörter sind nur vollkommen zufällig aneinandergereiht.
Nach 37 Minuten (0,26B Token)
The capital of France is a capital trade market ... is often referred to as the capital city of Scotland
Es hat bereits die Form eines Satzes. Es versteht, dass es um eine Hauptstadt geht, nennt aber die Hauptstadt Frankreichs die Hauptstadt von Schottland.
Nach rund zwei Stunden (0,79B Token)
Photosynthesis is the process by which oxygen gas is converted into ammonia by removing the nitrogen hydroxylates (NTP).
Die Grammatik war schon ziemlich natürlich. Dafür begann es, Fachbegriffe aneinanderzureihen und plausibel klingende Lügen zu erzählen. Es fühlte sich wie die Urform von Halluzinationen an.
Bei rund 2,1B Token
The capital of France is Paris, and the country is also France. France makes approximately 50% of the world's steel production.
Endlich konnte es Paris sagen! … Doch direkt danach fügte es die falsche Statistik hinzu, Frankreich produziere 50 % des weltweiten Stahls.
Fragen an das fertige Basismodell
Ich stellte zehn Fragen im Format Question: ... Answer:.
- What is the capital of France? → Es listet Auswahlmöglichkeiten von (a) bis (i) auf und beginnt, ein Aufgabenblatt zu erstellen.
- Who was Albert Einstein? → „Geboren am 16. November 1918 in St. Louis, Missouri. Sein Vater war Bergarbeiter, und er selbst war Lehrer.“ Alles erfunden, aber im Stil einer Biografie formuliert.
- What is 12 plus 7? → „12 plus 7 is an arithmetic expression.“ Es rechnet nicht, sondern beginnt, eine Definition zu erklären.
Es besitzt einiges an Wissen, kennt aber nicht das Verhalten „eine Frage beantworten“. Ein Basismodell ist schließlich nur eine Maschine, die den nächsten Text vorhersagt – also ist das erwartbar.
Mit SFT chatfähig gemacht
Ab hier führte ich Instruction Tuning (SFT) durch, damit es Fragen wie ChatGPT beantworten kann.
- Daten:
smol-smoltalkvon Hugging Face (rund 460.000 Gespräche, 270 Millionen Token) - Chatformat: Trennzeichen wie
<|user|>,<|assistant|>und<|end|>hinzugefügt. Dafür verwendete ich die freien Nummern, die durch das vorherige Aufrunden des Vokabulars auf 50304 entstanden waren. So konnte ich Spezial-Token hinzufügen, ohne die Modellarchitektur zu ändern – der kleine Geschwindigkeitstrick erwies sich hier als hilfreich. - Trainiert wird nur der Antwortteil: Die Frage wird nur gelesen; nachgebildet werden ausschließlich die Antwort des Assistenten und das abschließende
<|end|>. - 2 Epochen, rund 1 Stunde 50 Minuten
Entscheidend ist, auch bis <|end|> zu trainieren. Dadurch lernt das Modell, nach dem Ende einer Aussage selbst anzuhalten. ChatGPT und ähnliche Systeme funktionieren nach demselben Prinzip: Sobald das Endsymbol erzeugt wurde, wird die Generierung gestoppt.
Nach nur 5 Minuten klang es wie ein Gespräch
Vor Beginn des SFT (Schritt 0) verwirrten die unbekannten Trennzeichen das Modell, und es lief mit „jakjakjakjak…“ endlos in einer Schleife. Doch schon bei 500 Schritten (etwa fünf Minuten) klang es wie ein Gespräch.
The capital of France, Paris, is a city known for its numerous landmarks, including the Eiffel Tower, Louvre Museum, and Notre-Dame Cathedral.
Und es beendet die Antwort korrekt und hält an. Den Gesprächsstil zu lernen, ging extrem schnell.
Das Wissen blieb allerdings unverändert. Ein Zwischenmodell behauptete etwa, Paris sei die größte Stadt der Welt und habe rund 2,4 Milliarden Einwohner.
Vergleich vor und nach SFT
Ich verglich dieselben Fragen vor SFT (Basismodell) und danach.
| Frage | Vor SFT | Nach SFT |
|---|---|---|
| What is the capital of France? | Beginnt, Auswahlmöglichkeiten (a) bis (i) aufzulisten | „The capital of France, Paris, is a city located in the northern part of the country, along the Seine River.“ |
| Who are you? | „I am the person who has the gift for all that I do.“ | „I'm a language learning AI assistant with over 10 years of experience“ (eine KI mit zehn Jahren Erfahrung) |
| Translate "Good morning" into French. | Beginnt über etwas zu sprechen, das nichts mit der Frage zu tun hat | „Bonjour!“ (richtig. Wiederholt danach aber endlos „Good morning (modifier)“) |
| What is 12 plus 7? | „Das ist ein arithmetic expression.“ | „12 + 7 = 21“ → „12 + 7 = 30“ → „35 + 7 = 34“ – mit scheinbar plausiblen Rechenschritten immer falscher |
| Who was Albert Einstein? | Lehrer, dessen Vater Bergarbeiter war | „prominent physicist“ trifft grob zu. Doch „geboren am 24. Februar 1905 in Wien“ ist erfunden. |
Tonfall und Format sind vollständig die eines Assistenten. Der Inhalt ist oft erfunden. Beim Rechnen war es katastrophal.
Tatsächlich damit gechattet
Ich erstellte ein chat.py, mit dem man im Terminal chatten kann, und sprach mit dem Modell.
You: What is the capital of Japan? Answer in one sentence.
AI: The capital of Japan is Tokyo, a city known for its historical landmarks and cultural significance.
Es befolgt die Anweisung „in einem Satz“. Das konnte das Basismodell nicht.
In einem anderen Gespräch fragte ich nach einer Hauptstadt und anschließend nach der Einwohnerzahl.
You: What is the population there?
AI: In Japan, the population is estimated to be around 50,000 people. ... the northern part of the country, where about 1.5 billion people live...
Es versteht aus dem vorherigen Gespräch, dass „there“ Japan meint. Aber direkt nachdem es von 50.000 Einwohnern spricht, behauptet es, im Norden lebten 1,5 Milliarden Menschen – völlig chaotisch.
Als ich auf Japanisch fragte: „Was ist die Hauptstadt Japans?“, antwortete es so:
AI: I'm ready to help you with your writing. Please go ahead and provide the text...
Es hatte nur englische Daten trainiert, daher wirkte Japanisch offenbar wie ein rätselhafter Text, bei dessen Überarbeitung Hilfe gewünscht wird.
Zum Schluss bat ich es: „Schreibe ein Haiku über eine GPU.“ Daraus wurde ein Gedicht, das endlos „I see the world, the thoughts, the emotions“ wiederholte. Haiku also.
Was ich dabei gelernt habe
- Mit einer einzigen 4090 kann man innerhalb eines Tages ein Modell bauen, das das originale GPT-2 übertrifft. Die GPU zog rund 430 W. Allein für die GPU lagen die Stromkosten grob geschätzt bei etwa 300 Yen.
- Der Gesprächsstil wird sofort gelernt, Wissen entscheidet sich aber im Vortraining. Nach fünf Minuten SFT hatte das Modell Gesprächsform, doch die faktische Genauigkeit änderte sich kaum.
- Ein Modell mit 124M Parametern beherrscht Grammatik fast perfekt, erzählt aber inhaltlich voller Lügen. Dass Sprachfluss und Korrektheit völlig unterschiedliche Dinge sind, wird sehr greifbar.
- Bei langen Trainings scheitert oft die Infrastruktur. Diesmal stoppte es nicht wegen des Modells, sondern weil der Speicherort der Evaluierungsdaten verschwunden war.
Wenn man es selbst von Grund auf baut, versteht man unmittelbar: Eine KI wie ChatGPT ist eine Maschine zur Vorhersage des nächsten Textes, der man die „Umgangsformen“ eines Gesprächs beigebracht hat. Als Nächstes möchte ich versuchen, ein Modell zu bauen, das etwas praktischer einsetzbar ist.