Mein selbst gebautes LLM mit 300 Millionen Parametern quantisiert: Geschwindigkeit und Genauigkeit auf der CPU verglichen
Das im vorigen Artikel erstellte Modell mit 320 Millionen Parametern für kroatisches RAG. Da es auf der CPU laufen soll, habe ich es diesmal quantisiert, um zu testen, wie klein und schnell es werden kann – und wie stark die Genauigkeit darunter leidet.
Vorweg das Fazit.
- Q6_K ist genau richtig. Ein Fünftel der Größe (254 MB), etwa viermal schnellere Generierung und die gleiche Genauigkeit wie das ursprüngliche Modell
- Q2_K ist kaputt. Schnell, aber selbst bei Fragen mit Antwort behauptet es plötzlich: „Es gibt keine Antwort.“
- Überraschenderweise war Q3_K_M genauer als Q4_K_M
Was ich gemacht habe
Das in PyTorch erstellte Modell habe ich in ein Format (GGUF) konvertiert, das sich mit llama.cpp, einem häufig für CPU-Inferenz verwendeten Tool, ausführen lässt, und in acht Genauigkeitsstufen gespeichert.
- Das Modell im gleichen Format wie Qwen3 exportiert und in GGUF konvertiert
- Da der Tokenizer selbst gebaut ist, verweigerte llama.cpp die Konvertierung mit dem Hinweis auf einen „unbekannten Tokenizer“. Beim Vergleich der Regeln zur Worttrennung stellte sich heraus, dass sie Zeichen für Zeichen mit Qwen2 übereinstimmen, daher habe ich es als Qwen2 registriert und so durchgelassen
- Überprüft, ob die Konvertierung korrekt ist. Die Tokenisierung von 160 Texten stimmte vollständig mit der PyTorch-Version überein. Bei 20 Fragen ließ ich jeweils das Wort mit der höchsten Wahrscheinlichkeit erzeugen; auch die Ausgaben waren bei allen 20 Fragen vollständig identisch
- Mit
llama-quantizeF16 bis Q2_K erstellt
Daher enthält F32 in der Tabelle denselben Inhalt wie die PyTorch-Version. Das ist die Referenz für den Vergleich.
Messmethode
- Die CPU ist ein i7-13700K. Es wurde keine GPU verwendet
- Einstellungen von llama.cpp: 8 Threads für die Generierung, 16 Threads zum Einlesen der Texte (das war in meinen Tests am schnellsten)
- Für 100 Evaluierungsfragen × 4 Arten von Kontexten ließ ich jedes Modell jeweils 400-mal antworten
- Absatz: Ein Absatz von etwa 100 Tokens, der die Antwort enthält
- Langer Text: Ein Text mit etwa 3.000 Tokens, der die Antwort enthält (auch irrelevante Artikel sind beigemischt)
- Keine Antwort (Absatz/langer Text): Texte, die keine Antwort enthalten. Eine Verweigerung zählt als richtig
- Im vorigen Artikel wurden 300 Fragen gemessen, daher weichen die Zahlen leicht ab
Ergebnisse: Genauigkeit
| Format | Größe | Absatz korrekt | Langer Text korrekt | Langer Text verweigert | Erfunden (keine Antwort: Absatz/langer Text) | Genauigkeit nach Abgleich |
|---|---|---|---|---|---|---|
| F32 (Referenz) | 1,233MB | 77% | 53% | 30% | 1% / 9% | 80.9% |
| F16 | 617MB | 77% | 53% | 30% | 1% / 9% | 80.9% |
| Q8_0 | 329MB | 76% | 53% | 30% | 1% / 8% | 81.9% |
| Q6_K | 254MB | 79% | 54% | 30% | 2% / 9% | 81.3% |
| Q5_K_M | 223MB | 72% | 45% | 41% | 1% / 6% | 84.4% |
| Q4_K_M | 193MB | 68% | 37% | 46% | 1% / 7% | 75.9% |
| Q3_K_M | 160MB | 72% | 48% | 38% | 1% / 8% | 80.4% |
| Q2_K | 129MB | 39% | 11% | 78% | 4% / 7% | 72.2% |
„Genauigkeit nach Abgleich“ bezeichnet den Anteil korrekter Antworten, nachdem ein Programm überprüft hat, ob die Zitate des Modells tatsächlich im Text vorkommen; wenn nicht, wurde die Antwort durch „keine Antwort“ ersetzt.
- F16, Q8_0 und Q6_K sind fast identisch mit der Referenz. Es gibt nur Unterschiede von ein bis zwei Fragen
- Ab Q5_K_M nehmen nicht so sehr die Fehler zu, sondern die Verweigerungen. Es wirkt, als würde das Modell bei sinkender Sicherheit einfach ablehnen – genau die Eigenschaft, die ich ihm im vorigen Artikel beigebracht habe. Erfundene Antworten nehmen nicht zu
- Q4_K_M ist schlechter als Q3_K_M. Bei langen Texten 37% gegenüber 48%. Bei 100 Fragen gibt es zwar etwas Schwankung, aber 11 Prozentpunkte sind viel. Den Grund habe ich noch nicht untersucht
- Q2_K verweigert bei 78% der langen Texte. Das ist bereits ein anderes Modell
Ergebnisse: Geschwindigkeit
| Format | Generierungsgeschwindigkeit | Durchschnittszeit pro Durchlauf |
|---|---|---|
| PyTorch fp32 (Referenz) | Absatz 14.6 · langer Text 6.7 tok/s | — |
| F32 | 18.7 tok/s | 2.76 Sekunden |
| F16 | 35.9 tok/s | 2.08 Sekunden |
| Q8_0 | 59.0 tok/s | 1.93 Sekunden |
| Q6_K | 73.1 tok/s | 1.33 Sekunden |
| Q5_K_M | 81.2 tok/s | 1.26 Sekunden |
| Q4_K_M | 89.1 tok/s | 1.10 Sekunden |
| Q3_K_M | 103.4 tok/s | 1.12 Sekunden |
| Q2_K | 119.9 tok/s | 1.07 Sekunden |
Die Zahlen für llama.cpp sind Durchschnitte aus 400 Durchläufen (Absätze, lange Texte und Fälle ohne Antwort zusammengefasst). Die PyTorch-Zahlen stammen aus den Messungen im vorigen Artikel.
- Die Generierungsgeschwindigkeit ist nahezu umgekehrt proportional zur Größe. Auf der CPU bestimmt eher die Geschwindigkeit, mit der Gewichte aus dem Speicher gelesen werden, als die Rechenleistung die Geschwindigkeit – je kleiner, desto schneller
- Selbst bei gleichem F32 ist llama.cpp schneller als PyTorch
- Ab Q6_K sinkt die Zeit pro Durchlauf jedoch kaum noch. Bei dieser Länge dominiert die Zeit zum anfänglichen Einlesen des Textes
Video: Dieselbe Frage zu einem langen Text auf der CPU lösen lassen
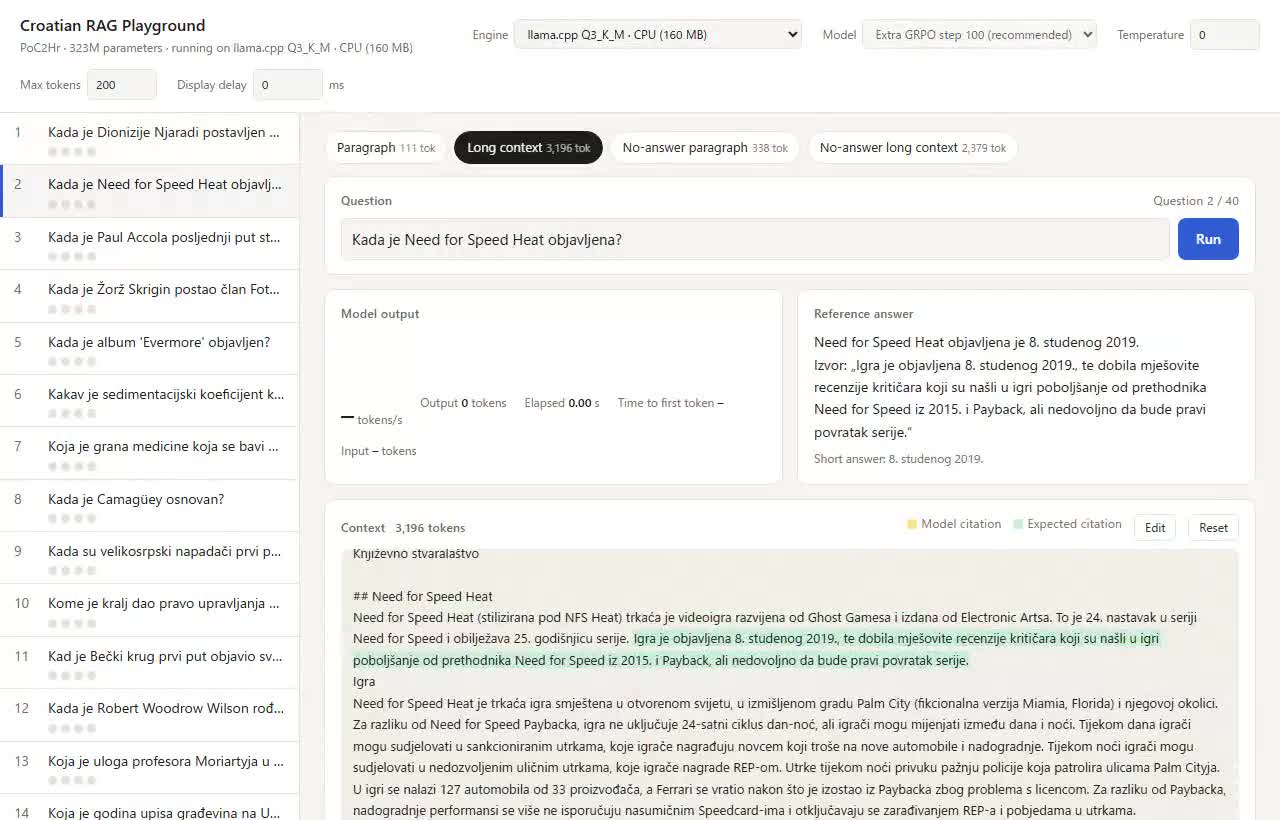
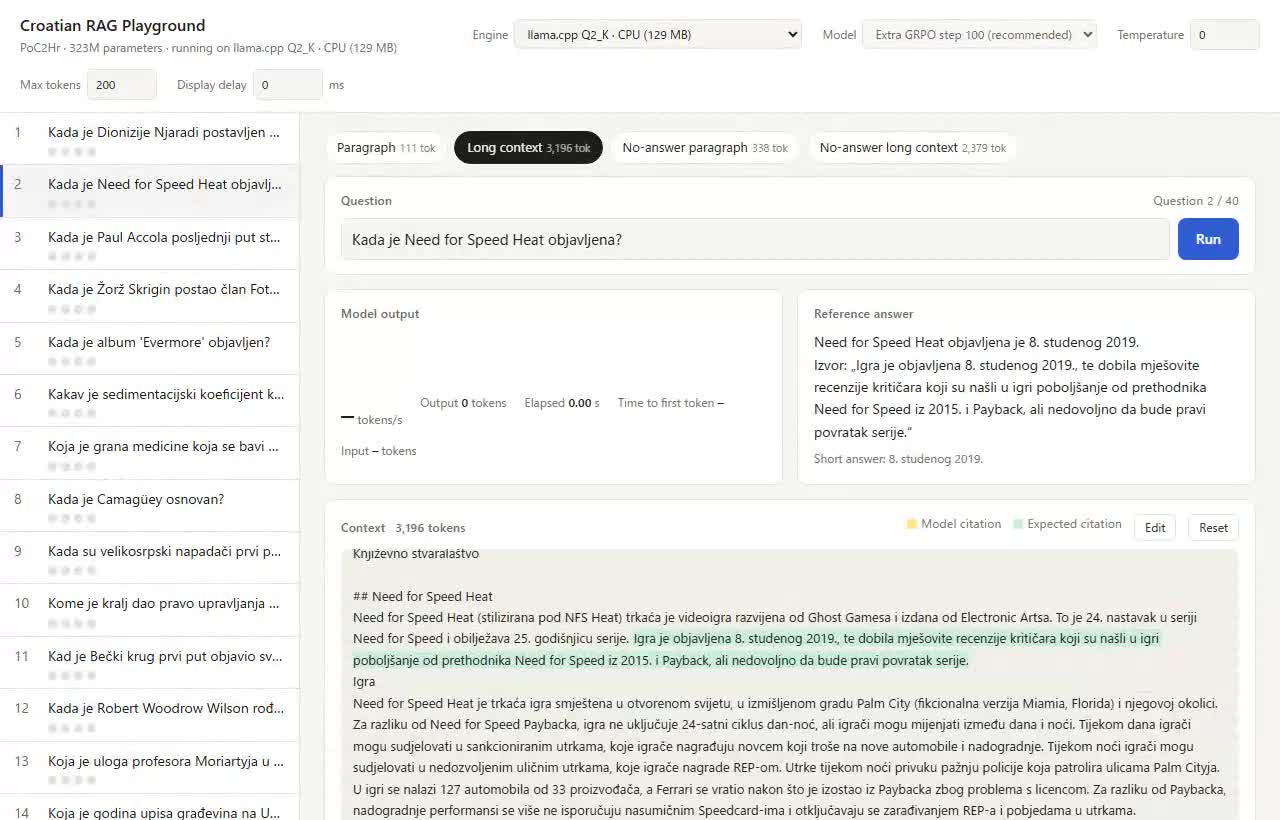
Ich gab dem Modell einen Text mit etwa 3.200 Tokens und fragte: „Wann wurde Need for Speed Heat veröffentlicht?“ Die richtige Antwort ist der 8. November 2019.
Da die Aufnahme lief und gleichzeitig der Browser den Bildschirm zeichnete, sind die Geschwindigkeiten im Video niedriger als in der Tabelle oben. Es ist zum direkten Vergleichen nebeneinander gedacht.
| Format | Generierungsgeschwindigkeit im Video | Bis zum ersten Zeichen | Gesamt | Ergebnis |
|---|---|---|---|---|
| PyTorch fp32 | 5.5 tok/s | 4.8 Sekunden | 18.5 Sekunden | korrekt |
| F32 | 14.2 tok/s | 2.8 Sekunden | 8.1 Sekunden | korrekt |
| F16 | 25.9 tok/s | 3.5 Sekunden | 6.4 Sekunden | korrekt |
| Q8_0 | 38.2 tok/s | 4.0 Sekunden | 5.9 Sekunden | korrekt |
| Q6_K | 41.6 tok/s | 2.6 Sekunden | 4.4 Sekunden | korrekt |
| Q5_K_M | 46.3 tok/s | 2.6 Sekunden | 4.3 Sekunden | korrekt |
| Q4_K_M | 47.2 tok/s | 2.3 Sekunden | 4.7 Sekunden | korrekt (Antwort länger) |
| Q3_K_M | 56.7 tok/s | 2.5 Sekunden | 4.5 Sekunden | korrekt (Antwort länger) |
| Q2_K | 61.3 tok/s | 2.7 Sekunden | 2.8 Sekunden | verweigert |
Von F32 bis Q5_K_M sind sowohl Antwort als auch Zitat Zeichen für Zeichen identisch mit der PyTorch-Version. Bei Q4_K_M und Q3_K_M wurden die Antwortsätze länger, aber die Zitate waren korrekt. Q2_K verweigerte mit „Der Text enthält keine Antwort“, obwohl eine Antwort vorhanden war.
PyTorch fp32 (das ursprüngliche Modell)
llama.cpp F32 (1,233MB)
llama.cpp F16 (617MB)
llama.cpp Q8_0 (329MB)
llama.cpp Q6_K (254MB)
llama.cpp Q5_K_M (223MB)
llama.cpp Q4_K_M (193MB)
llama.cpp Q3_K_M (160MB)
llama.cpp Q2_K (129MB)
Fazit
- Wenn dieses Modell auf der CPU laufen soll, dann Q6_K. Die Genauigkeit bleibt unverändert, die Größe sinkt auf ein Fünftel und die Generierung ist etwa fünfmal so schnell wie mit PyTorch. Es gibt keinen Grund zu zögern
- Für zusätzliche Sicherheit Q8_0. Fast identisch mit dem Original bei 329 MB. Das ist immer noch klein genug
- Kleine Modelle mit 300 Millionen Parametern sind anfällig für Quantisierung. Bei großen Modellen heißt es, dass selbst Q4 kaum Einbußen verursacht, hier war der Verlust ab Q5 jedoch deutlich sichtbar. Das Modell hat von Anfang an wenig Spielraum, daher wirkt sich jede Kürzung aus
- Dass es eher verweigert als halluziniert, ist erfreulich. Für RAG ist eine Verweigerung sicherer als mehr erfundene Antworten. Der Effekt des Verstärkungslernens, mit dem ich dem Modell im vorigen Artikel das Verweigern beigebracht habe, zeigt sich auch hier
- Bei kleinen Modellen schrumpfen die Geschwindigkeitsunterschiede. Ab Q6_K bleibt trotz schnellerer Generierung die Zeit zum Einlesen der Texte bestehen, weshalb sich das subjektiv kaum verändert. Auch im Video liegen Q6_K bis Q3_K_M alle bei etwa vier Sekunden
- Warum Q4_K_M gegen Q3_K_M verloren hat, bleibt unklar. Ich möchte das mit mehr Fragen sowie einer Untersuchung, welche Schichten wie quantisiert werden, weiter analysieren