Ich habe ein kroatisches Sprachsynthesemodell mit 32 Millionen Parametern gebaut: Stimmen während des Trainings im Vergleich
Nach dem LLM für kroatisches RAG habe ich diesmal ein kleines Sprachsynthesemodell (TTS) speziell für Kroatisch gebaut. Ziel war, dass es in Echtzeit auf der CPU eines Smartphones läuft.
Die Methode war „Destillation“: Ich ließ ein großes Sprachsynthesemodell (HiggsAudio v3) kroatische Skripte vorlesen, erzeugte daraus Trainingsdaten und trainierte damit ein kleines Modell von Grund auf. Zunächst führte ich ein Pilottraining mit 7,5 Stunden Daten durch und verglich, wie sich derselbe Satz im Laufe des Trainings verändert.
Vorweg das Fazit.
- Mit 32 Millionen Parametern (Matcha-TTS 18,3 Mio. + Vocos 13,5 Mio.) sprach das Modell tatsächlich Kroatisch
- Nach 50 Minuten Training (5.000 Schritten) las es bereits skriptgetreu vor. Danach verbesserte sich vor allem das „Rauschen“
- Die Zeichenfehlerrate für 14 Testsätze lag am Ende bei 0,9 % (10 von 14 Sätzen waren exakt gleich)
- Selbst mit einem CPU-Thread ließ sich eine Sekunde Audio in 0,09 Sekunden erzeugen (i7-13700K)
Demo: Lass es tatsächlich sprechen
Im kroatischen TTS-Playground liegt das Modell aus diesem Artikel (die finale Version mit 30.000 Schritten). Gib beliebigen kroatischen Text ein, und er wird direkt vorgelesen.
- Wähle aus 50 Beispielsätzen (Begrüßungen, Reisen, Krankenhaus usw.) oder gib selbst bis zu 1.000 Zeichen ein
- Sprechgeschwindigkeit, Stärke der Intonation und Anzahl der Syntheseschritte lassen sich ändern. Bei festem Seed erzeugt derselbe Satz jedes Mal dieselbe Stimme
- Die Synthese läuft ausschließlich auf der CPU des Servers (ONNX Runtime; weder GPU noch externe API werden verwendet)
- Zahlen können nicht vorgelesen werden; sie müssen als Wörter geschrieben werden, etwa „dvadeset pet (25)“
Was ich gemacht habe
1. Skripte erstellen: Ich ließ ein lokales Gemma 4 31B Dialogzeilen für kroatische Alltagssituationen schreiben. Situationen, Gesprächspartner, Emotionen und Länge wurden zufällig vorgegeben, zum Beispiel „Auf dem Markt mit einer Großmutter sprechen“ oder „Mitten in der Nacht ein seltsames Geräusch hören und Angst haben“; pro Durchlauf entstanden 22 Zeilen. Als Sprecherin war eine Frau in ihren Dreißigern vorgesehen. Es wurden 23 Emotionen gemischt, darunter neutral, Freude, Wut und Flüstern.
2. Audio erzeugen: Ich ließ HiggsAudio v3 die Skripte mit der Stimme einer Referenzaufnahme (16 Sekunden) vorlesen. Mit Emotionstags (etwa <|emotion:anger|>) wird die Stimme tatsächlich wütend oder fröhlich. 4.500 Clips entstanden in etwa fünf Stunden.
3. Automatisch prüfen: Mit Whisper large-v3 ließ ich die Audios transkribieren und mit dem Skript vergleichen, um Versprecher auszusortieren. Zusätzlich maß ein Sprechererkennungsmodell die Ähnlichkeit zur Referenzstimme und sortierte auch Clips mit veränderter Stimme aus. Bestanden haben 4.393 von 4.500 Clips (97,6 %). Nach dem Abschneiden der Stille am Anfang und Ende blieben 7,46 Stunden übrig.
4. Das kleine Modell trainieren: Matcha-TTS (ein TTS-Verfahren namens Flow Matching) trainierte ich fünf Stunden auf einer RTX 4090, etwa 30.000 Schritte. Für den Vocoder, also den Teil, der wieder eine Audio-Wellenform erzeugt, verwendete ich das veröffentlichte Vocos unverändert.
Kroatisch wird fast so gelesen, wie es geschrieben wird. Daher wandelte ich die Eingabe nicht in phonetische Zeichen um, sondern nutzte die Buchstaben direkt. Nur lj, nj und dž sind jeweils ein Laut und wurden daher als ein Zeichen zusammengefasst.
Stimmen während des Trainings vergleichen
Den Satz außerhalb der Trainingsdaten „Molim Vas, možete li mi reći koliko košta ova haljina? (Entschuldigen Sie, wie viel kostet dieses Kleid?)“ habe ich mit Modellen aus verschiedenen Trainingsphasen synthetisiert.
Schritt 5.000 (etwa 50 Minuten nach Trainingsbeginn)
Schritt 10.000 (etwa 1 Stunde 40 Minuten)
Schritt 15.000 (etwa 2 Stunden 20 Minuten)
Schritt 20.000 (etwa 3 Stunden 10 Minuten)
Schritt 30.000 (etwa 5 Stunden, final)
Zum Vergleich ein Trainingsdaten-Clip, den HiggsAudio in der Rolle des Lehrers erzeugt hat (ein anderer Satz: „Samo polako hodajte, nema potrebe da žurimo kroz ovaj mrak.“).
Bei der Transkription mit Whisper war dieser Satz von Schritt 5.000 bis zum Schluss vollständig und Zeichen für Zeichen identisch mit dem Skript. Mit anderen Worten: Was gesagt wird, funktionierte von Anfang an.
Der Unterschied liegt in der Klangqualität. Nach meinem Höreindruck liegt bei Schritt 5.000 ein körniges Rauschen auf der Stimme, das bei Schritt 10.000 deutlich abnimmt. Im Spektrogramm derselben Audios (horizontal die Zeit, vertikal die Frequenz) wird das gut sichtbar.
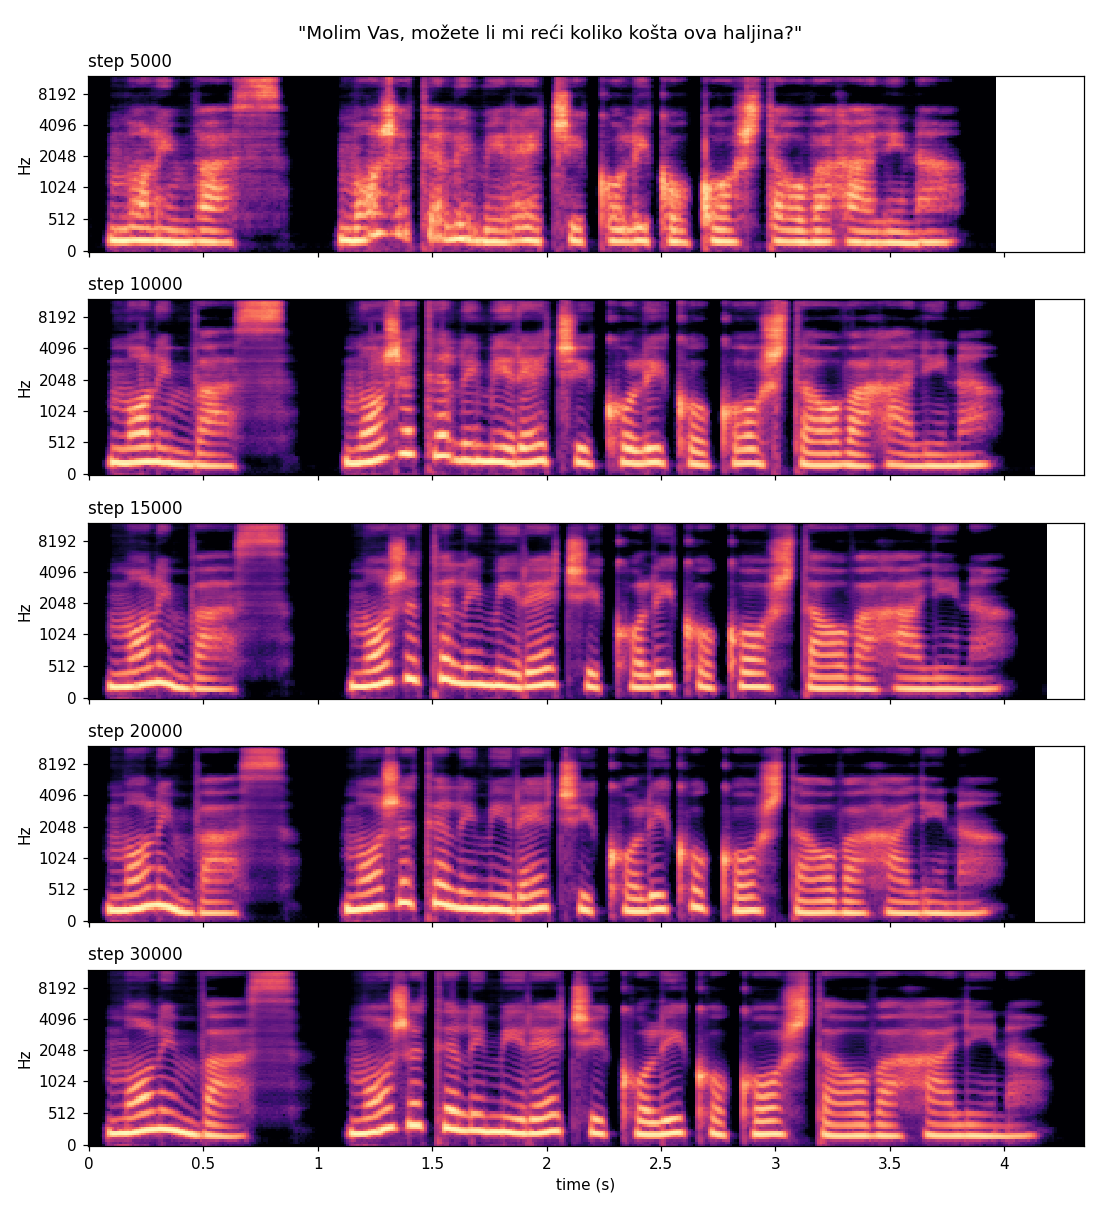
Die horizontalen Streifen, die sich passend zur Tonhöhe anordnen (Obertöne), sind bei Schritt 5.000 verschwommen; die Zwischenräume sind neblig ausgefüllt. Das ist der Teil, der als Rauschen hörbar ist. Ab Schritt 10.000 werden die Streifen deutlich und die Zwischenräume dunkler. Mit fortschreitendem Training verlaufen die Streifen außerdem sanfter auf und ab, sodass auch die Bewegung der Tonhöhe (Intonation) klarer erkennbar zu werden scheint.
In Zahlen
Ich ließ 14 Testsätze, die sämtlich nicht in den Trainingsdaten enthalten waren, mit Whisper large-v3 transkribieren und maß die Zeichenfehlerrate (CER). Sie reichen von kurzen Begrüßungen bis zu etwa 16 Sekunden langen Monologen.
| Schritte | Trainingszeit | Zeichenfehlerrate | Exakte Übereinstimmung |
|---|---|---|---|
| 5.000 | etwa 50 Min. | 1,1 % | 9 / 14 |
| 10.000 | etwa 1 Std. 40 Min. | 3,4 % | 8 / 14 |
| 15.000 | etwa 2 Std. 20 Min. | 0,7 % | 11 / 14 |
| 20.000 | etwa 3 Std. 10 Min. | 0,9 % | 11 / 14 |
| 30.000 | etwa 5 Std. | 0,9 % | 10 / 14 |
- Dass die Zahlen bei Schritt 10.000 schlechter ausfielen, lag fast ausschließlich daran, dass der eine Satz „Bok! (Hallo)“ als „Vok“ erkannt wurde. Bei einem Unterschied von einem Zeichen in drei Zeichen ergibt allein dieser Satz eine Fehlerrate von 33 %. Nach Gehör war Schritt 10.000 viel sauberer als Schritt 5.000. Die Zeichenfehlerrate misst nur, ob der Text gelesen wird; die Klangqualität lässt sich nur durch Anhören beurteilen
- Bis zum Ende blieben bei „Đak je pojeo džem (Der Schüler hat Marmelade gegessen)“ die Laute đ und dž fehlerhaft. Sie kommen auch im Kroatischen selten vor und wurden als „Žak“ beziehungsweise „Džak“ erkannt
Geschwindigkeit auf der CPU
Ich maß auf einem i7-13700K mit unverändertem PyTorch, also ohne Optimierung. Der Wert ist der Durchschnitt aus drei Durchläufen mit vier Sätzen und insgesamt 47,6 Sekunden Audio. RTF bedeutet „benötigte Erzeugungszeit ÷ Audiolänge“: Je kleiner, desto schneller.
| Threads | Schritte | Matcha | Vocos | Gesamt-RTF |
|---|---|---|---|---|
| 1 | 2 | 0,042 | 0,025 | 0,067 |
| 1 | 4 | 0,067 | 0,025 | 0,092 |
| 4 | 4 | 0,032 | 0,010 | 0,042 |
| 8 | 4 | 0,028 | 0,007 | 0,036 |
Die „Schrittzahl“ ist die Anzahl der Wiederholungen, mit denen bei der Synthese aus Rauschen Audio erzeugt wird; die obigen Hörbeispiele wurden mit 4 erzeugt. Selbst mit einem Thread lässt sich eine Sekunde Audio in 0,09 Sekunden erstellen. Smartphone-CPUs sind langsamer, aber es sollte dennoch für Echtzeit reichen (noch nicht auf einem realen Gerät gemessen, also eine Schätzung).
Wie viele Stunden Daten braucht TTS?
Da sich mit 7,5 Stunden bereits dieses Ergebnis erzielen ließ, habe ich nach allgemeinen Richtwerten gesucht.
- LJSpeech, ein häufig verwendeter englischer Datensatz für TTS mit einer einzelnen Stimme, umfasst etwa 24 Stunden. Auch das offizielle Modell von Matcha-TTS wurde damit trainiert
- JSUT für Japanisch und CSMSC für Chinesisch umfassen jeweils etwa 10 Stunden und werden regulär als Korpora mit einer einzelnen Stimme verwendet
- Beim Training von Grund auf liegt die Untergrenze bei etwa einer Stunde; je nach Modell können dann Aussprachefehler zunehmen
- Beim Nachtrainieren eines vortrainierten Modells gibt es Berichte, dass 30 Minuten etwa einem Training von Grund auf mit 27 Stunden entsprechen
Es gibt auch eine Studie zum Training von Matcha-TTS ausschließlich mit synthetischer Sprache (Jiao-Tong-Universität Shanghai, Dezember 2025). Darin heißt es, dass mehr Textvielfalt, saubere rauschfreie Audios und ein einheitlicher Sprechstil das Training verbessern. Synthetische Daten sind rauschfrei und im Sprechstil einheitlich; vielleicht lassen sie sich daher bei gleicher Dauer leichter trainieren als echte Aufnahmen. Dass ich mit 7,5 Stunden schon so weit kam, passt dazu.
Stolpersteine
- Der PC fror ein: Das 31B-Modell für die Skripterstellung landete versehentlich zweimal gleichzeitig auf der GPU, sodass der VRAM überlief. Seitdem gilt die Regel: „Immer nur ein Modell auf der GPU“
- Gemma 4 denkt zu viel nach: Rund zwei Drittel der Ausgabe bestanden aus „Gedanken“. Nach dem Abschalten davon wurde es etwa dreimal schneller
- HiggsAudio halluziniert: In einem ersten Test fügte es nach der Stille am Satzende eigenmächtig „Hvala što pratite kanal (Danke, dass Sie den Kanal verfolgen)“ hinzu, wodurch ein Clip 81 Sekunden lang wurde. Offenbar hat es YouTube-Abschiedsfloskeln gelernt. Clips, deren Länge stark von der Erwartung abwich, wurden deshalb aussortiert
- Matcha-TTS läuft nicht unter Windows: Einige C-Erweiterungen ließen sich nicht bauen, daher schrieb ich diesen Teil in Python (numba) neu