RAG-Leistung von SLMs im Test: 25 Modelle mit 1B bis 9B auf Kroatisch und Englisch verglichen
Nachdem ich ein eigenes kroatisches RAG-Modell erstellt und sogar quantisiert hatte, wollte ich als Nächstes herausfinden, wie gut sich die kleinen Modelle (SLMs), die es derzeit gibt, für RAG eignen. Ich ließ insgesamt 25 Modelle – 10 aus der 1B-Klasse, 8 aus der 3B-Klasse und 7 aus der 7B-Klasse – sowie mein eigenes Modell mit 320 Millionen Parametern dieselben Aufgaben auf Kroatisch und Englisch lösen.
Nachtrag (am selben Tag): Ich habe auch drei kleine, speziell für RAG entwickelte Modelle ausprobiert (LFM2-1.2B-RAG, Pleias-RAG-1B / 350M). Die Ergebnisse stehen im zweiten Teil des Artikels unter „Nachtrag: Auch RAG-spezifische Modelle ausprobiert“.
Vorweg das Fazit.
- In der 3–4B-Klasse liegt man bereits fast gleichauf mit der 8–9B-Klasse. Bei der Gesamtgenauigkeit auf Kroatisch erreichten Qwen3.5 4B und Gemma 4 E4B 90 %, der Spitzenreiter Qwen3.5 9B 91 %
- Entscheidend ist, ob ein Modell ablehnen kann, wenn es keine Antwort gibt. Phi-4-mini, eines der genauesten Modelle, erfand bei 64 % der langen Texte ohne Antwort eine Antwort
- Im Englischen lehnen viele Modelle ab, obwohl eine Antwort vorhanden ist. OLMo 3 7B lehnte 47 % der englischen Absätze ab, MiniCPM5 2B sogar 70 %
- Auf der CPU brauchen Modelle der 7B-Klasse mehr als 30 Sekunden pro lange Frage. In der 1B-Klasse sind es 4–13 Sekunden. Mein eigenes 320M-Modell brauchte 2,1 Sekunden und war ungefähr so genau wie Qwen3.5 0.8B
Was ich gemacht habe
Aufgaben: Fragen, die wie im vorherigen Artikel aus der kroatischen Wikipedia erstellt wurden. Pro Frage erhalten die Modelle vier Arten von Texten.
- Absatz: ein etwa 100 Token langer Absatz, der die Antwort enthält
- Langer Text: ein etwa 3.000 Token langer Text, der die Antwort enthält (auch irrelevante Artikel sind beigemischt)
- Keine Antwort (Absatz/langer Text): ein Text ohne Antwort. Konnte das Modell mit „Die Antwort steht nicht im Text“ ablehnen, zählte das als richtig
Englische Version: Dieselben Aufgaben wurden mit EuroLLM-9B ins Englische übersetzt. Aufgaben, bei denen die Antwort durch die Übersetzung verloren ging oder unübersetzt auf Kroatisch stehen blieb, wurden in beiden Sprachen entfernt; verglichen wurde also anhand von denselben 260 Aufgaben.
Anweisung: In jeder Sprache lautete sie: „Verwende nur den folgenden Text und antworte kurz in einem Satz. Falls es keine Antwort gibt, antworte nur mit ‚Die Antwort steht nicht im Text‘.“
Bewertung: Qwen3.5 9B verglich die Antworten mit den Musterlösungen und entschied zwischen „richtig“, „falsch“ und „abgelehnt“. Ich habe 65 Fälle selbst überprüft: Die Bewertung war etwas großzügig, da auch Teilantworten wie nur die Jahreszahl als richtig galten, aber die Beurteilung, ob abgelehnt wurde, stimmte in allen Fällen.
Gesamtgenauigkeit: Die Zahl der richtigen Antworten bei Absätzen und langen Texten plus die Zahl der korrekten Ablehnungen bei fehlender Antwort, geteilt durch alle Aufgaben. Sie misst sowohl richtiges Antworten als auch das Schweigen, wenn das Modell etwas nicht weiß.
Ausführung: Die Genauigkeit wurde mit vLLM auf einer RTX 4090 gemessen, mit einer Generierung, die jedes Mal das wahrscheinlichste Wort auswählt. Bei Modellen mit einem „Denkmodus“, bei dem sie vor der Antwort nachdenken, wurde dieser deaktiviert. Modelle der 7B-Klasse wurden in FP8 ausgeführt, damit sie in den GPU-Speicher passen.
Ergebnisse: Genauigkeit (Kroatisch)
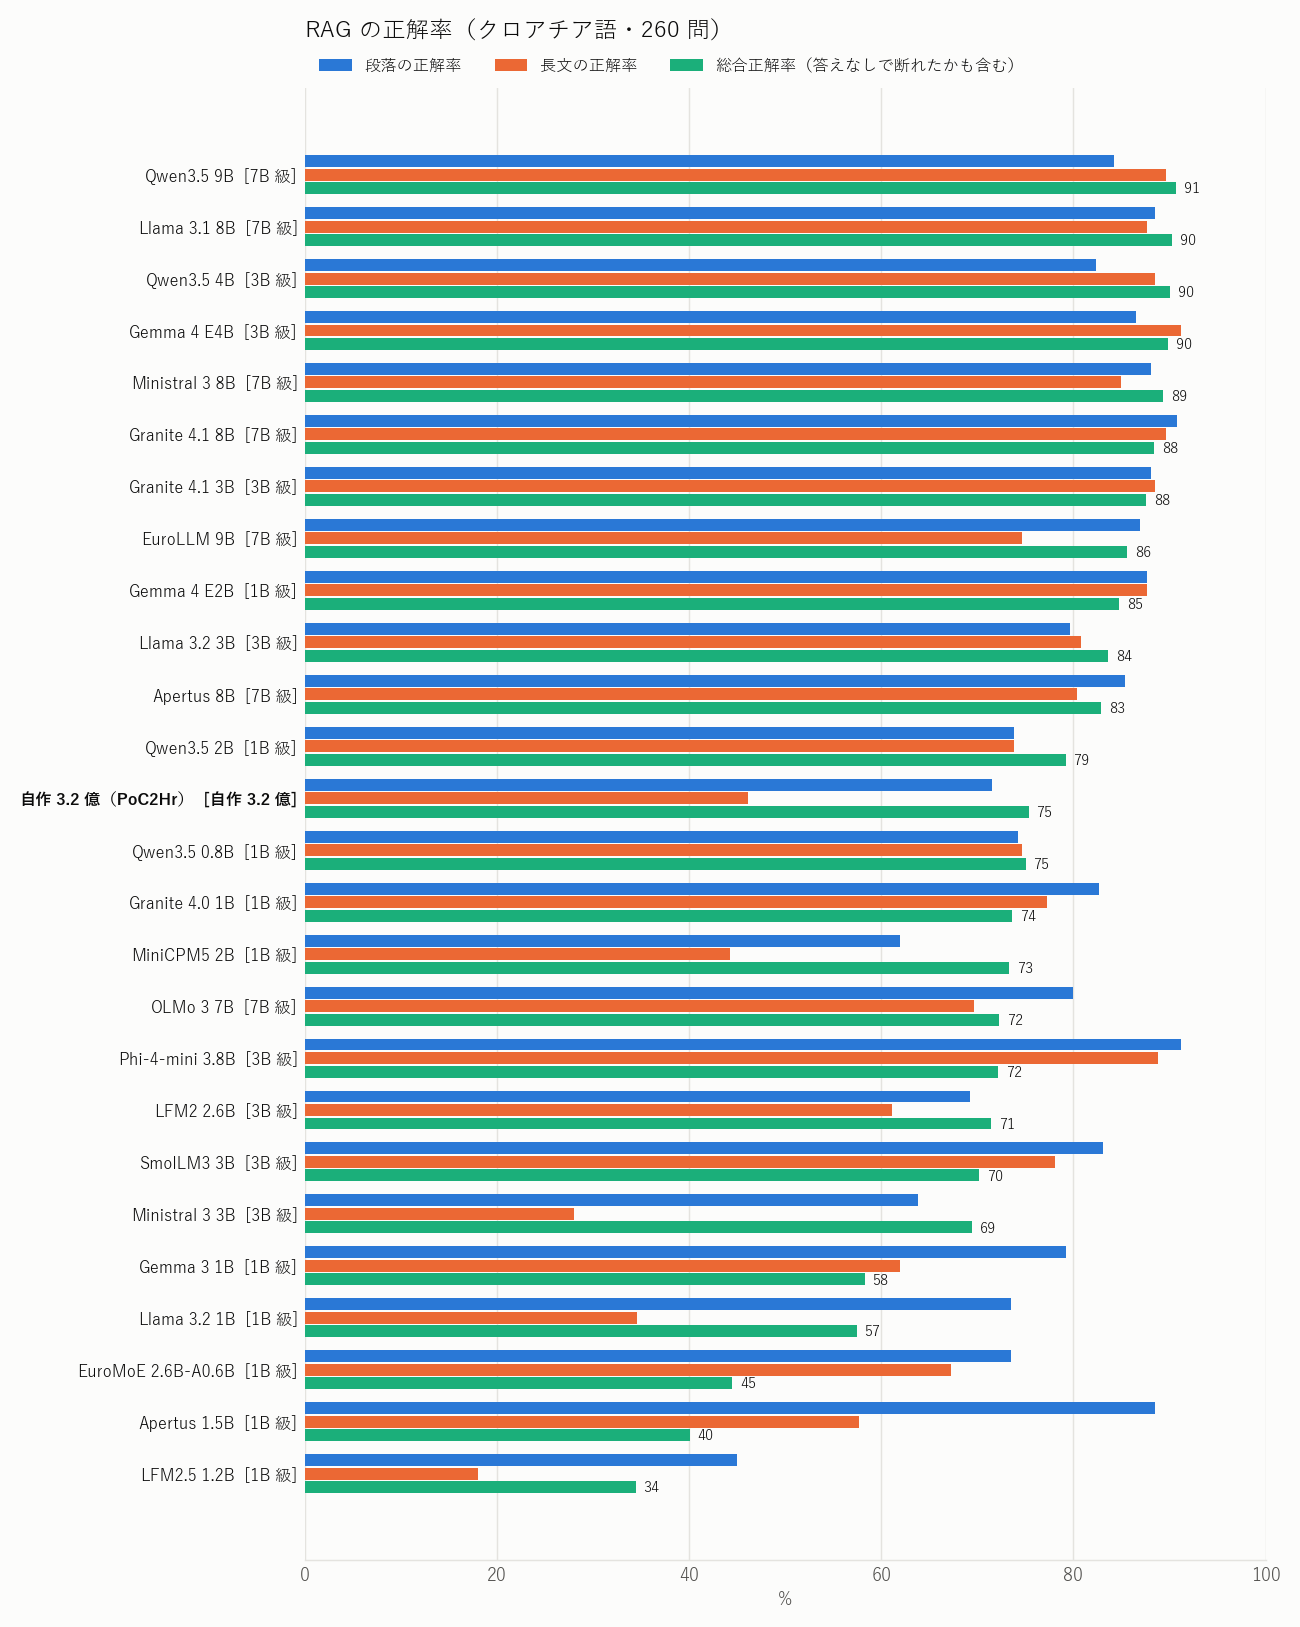
- Die Spitzenplätze liegen mit knapp 90 % fast gleichauf. Qwen3.5 9B (91 %), Llama 3.1 8B, Qwen3.5 4B und Gemma 4 E4B (90 %)
- In der 1B-Klasse sticht Gemma 4 E2B hervor (85 %). Der Name enthält zwar 2B, aber die Datei ist mit 3,2 GB eher groß
- Manche Modelle haben bei Absätzen und langen Texten eine hohe Genauigkeit, fallen aber in der Gesamtwertung zurück. Phi-4-mini gehört mit 91 % bei Absätzen und 89 % bei langen Texten zur Spitzengruppe, erreicht insgesamt aber nur 72 %. Der Grund ist das folgende „Erfinden“
- Am schlechtesten schnitt LFM2.5 1.2B ab (34 %). Bei Aufgaben mit Antwort konnte es nicht richtig antworten, und bei Aufgaben ohne Antwort erfand es Antworten
Ergebnisse: Genauigkeit (Englisch)
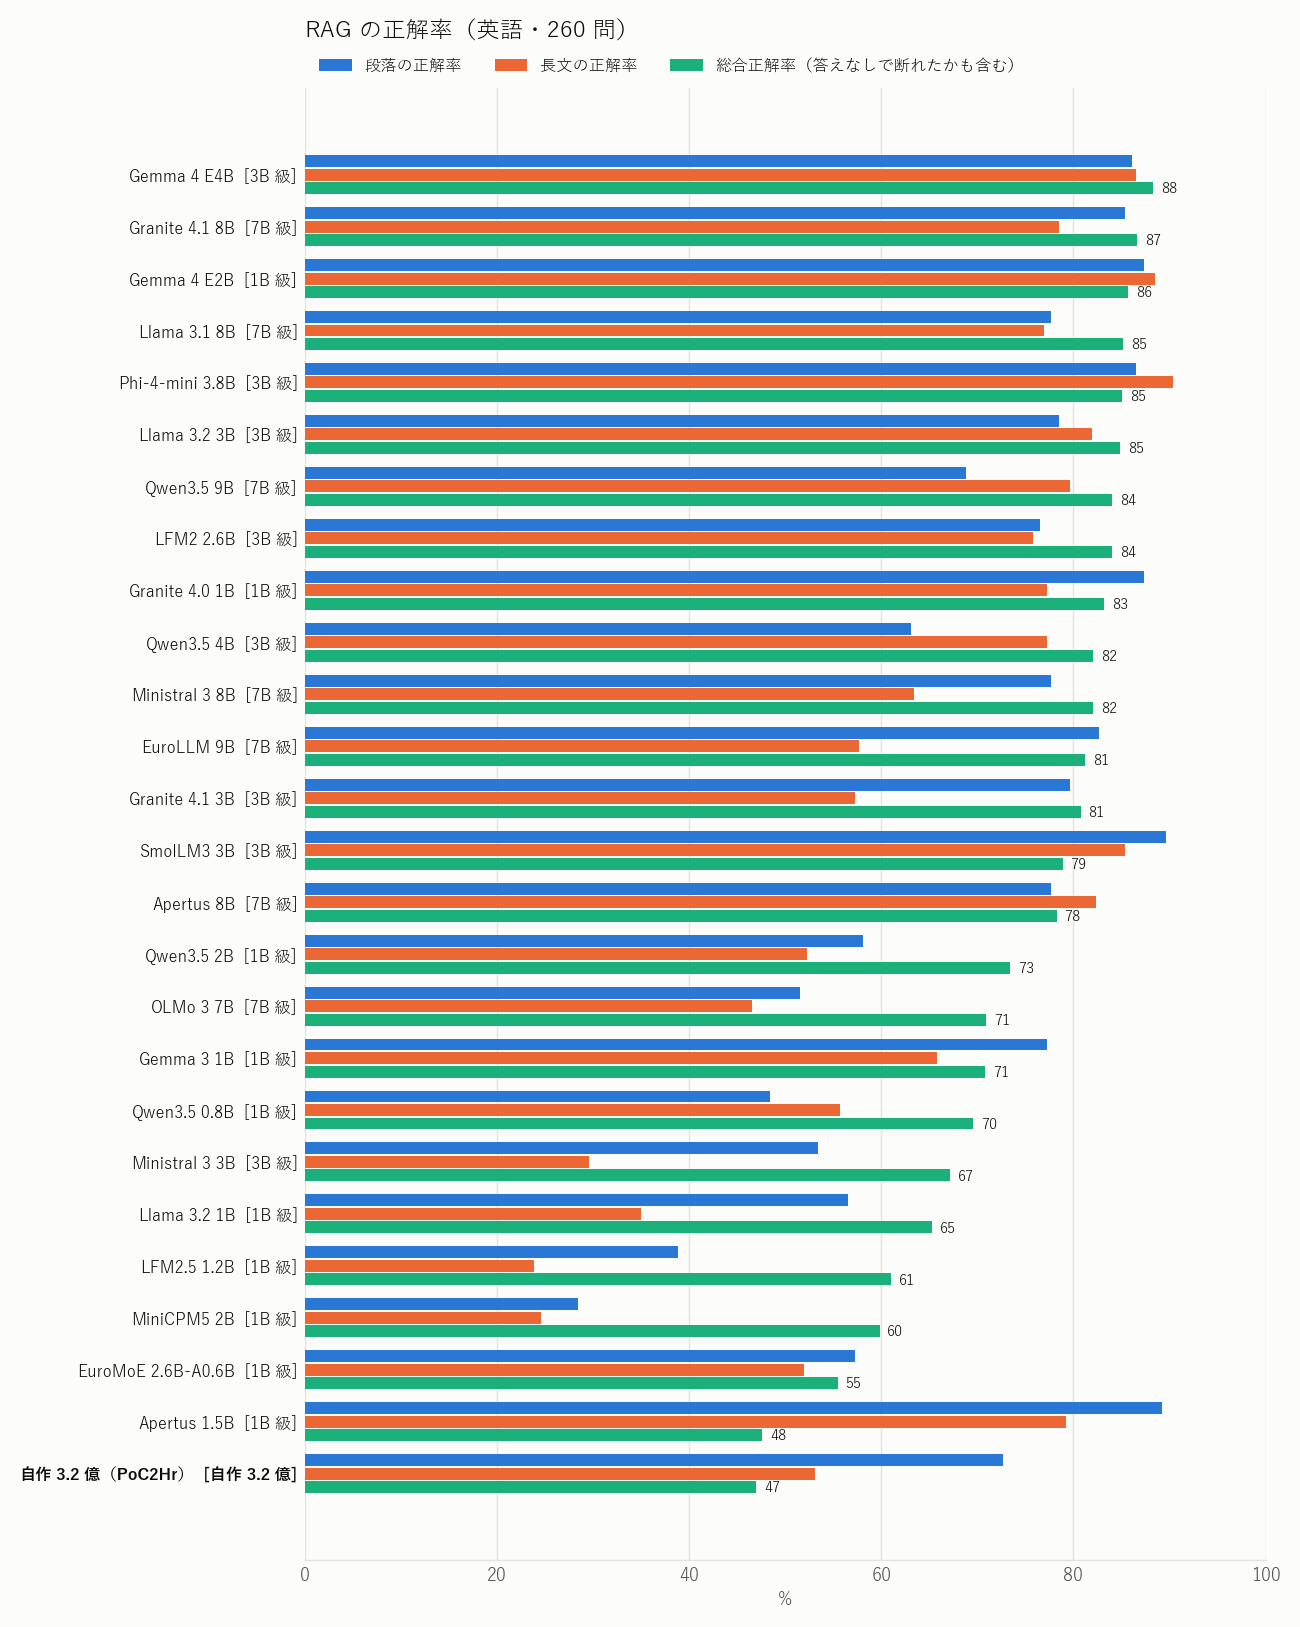
- Den ersten Platz belegt Gemma 4 E4B (88 %). Auch Gemma 4 E2B erreicht 86 %; Gemma 4 ist in beiden Sprachen stabil
- Manche Modelle fallen im Englischen in der Rangfolge zurück. Qwen3.5 4B: Kroatisch 90 % → Englisch 82 %. Der Grund ist, dass es ablehnt, obwohl eine Antwort vorhanden ist (bei 35 % der Absätze)
Erkenntnis 1: Entscheidend ist, ob ein Modell ablehnen kann
Der Anteil erfundener Antworten, wenn ein langer Text ohne Antwort vorgelegt wurde (Kroatisch).
| Modell | Erfundene Antworten bei langem Text ohne Antwort |
|---|---|
| Qwen3.5 4B | 9 % |
| Eigenes 320M-Modell | 9 % |
| Qwen3.5 9B | 10 % |
| Gemma 4 E4B | 19 % |
| Granite 4.1 8B | 30 % |
| Phi-4-mini 3.8B | 64 % |
| SmolLM3 3B | 73 % |
| EuroMoE 2.6B-A0.6B | 94 % |
Zum Beispiel bei der Frage „Wann wurde Need for Speed Heat veröffentlicht?“, wenn ein langer Text ohne die Antwort vorgelegt wird. Qwen3.5 9B antwortete „Die Antwort steht nicht im Text“, Phi-4-mini dagegen „August 1969“. Es scheint irgendwo im Text ein Datum aufgegriffen zu haben.
Das ist bei RAG das größte Problem. Es ist riskant, ein Modell allein nach seiner Genauigkeit auszuwählen. Der Anteil korrekter Antworten unter den gegebenen Antworten war bei Qwen3.5 4B und 9B mit 91–92 % am höchsten, bei Phi-4-mini lag er nur bei 64 %.
Erkenntnis 2: Im Englischen wird zu oft abgelehnt
Umgekehrt gab es im Englischen viele Modelle, die ablehnten, obwohl die Antwort klar im Text stand. Der Anteil der Ablehnungen bei Absätzen mit Antwort.
| Modell | Kroatisch | Englisch |
|---|---|---|
| Qwen3.5 4B | 15 % | 35 % |
| Qwen3.5 0.8B | 17 % | 47 % |
| OLMo 3 7B | 8 % | 47 % |
| MiniCPM5 2B | 34 % | 70 % |
| Gemma 4 E4B | 9 % | 8 % |
Zum Beispiel: „Wann stand Paul Accola zuletzt auf dem Podium?“ Im englischen Absatz steht eindeutig „the last time in 2000“, dennoch antwortete Qwen3.5 4B mit „Die Antwort steht nicht im Text“. Bei derselben Frage auf Kroatisch antwortet es korrekt mit „2000“.
Der Grund ist noch unklar. Da die englische Version maschinell übersetzt wurde, könnte die Unnatürlichkeit des Textes eine Rolle spielen. Vielleicht reagiert das Modell auf Englisch auch besonders stark auf die Anweisung „Wenn es keine Antwort gibt, antworte so“.
Ergebnisse: Geschwindigkeit auf der CPU
Da mein eigener Einsatz von einer CPU-Ausführung ausgeht, habe ich alle Modelle in dasselbe llama.cpp-Format (Q4_K_M) umgewandelt und auf einem i7-13700K gemessen. Die Generierung lief mit 8 Threads, das Einlesen der Texte mit 16 Threads. Nur Ministral 3 ließ sich nicht erfolgreich umwandeln, daher habe ich das offizielle Q4_K_M von Mistral verwendet.
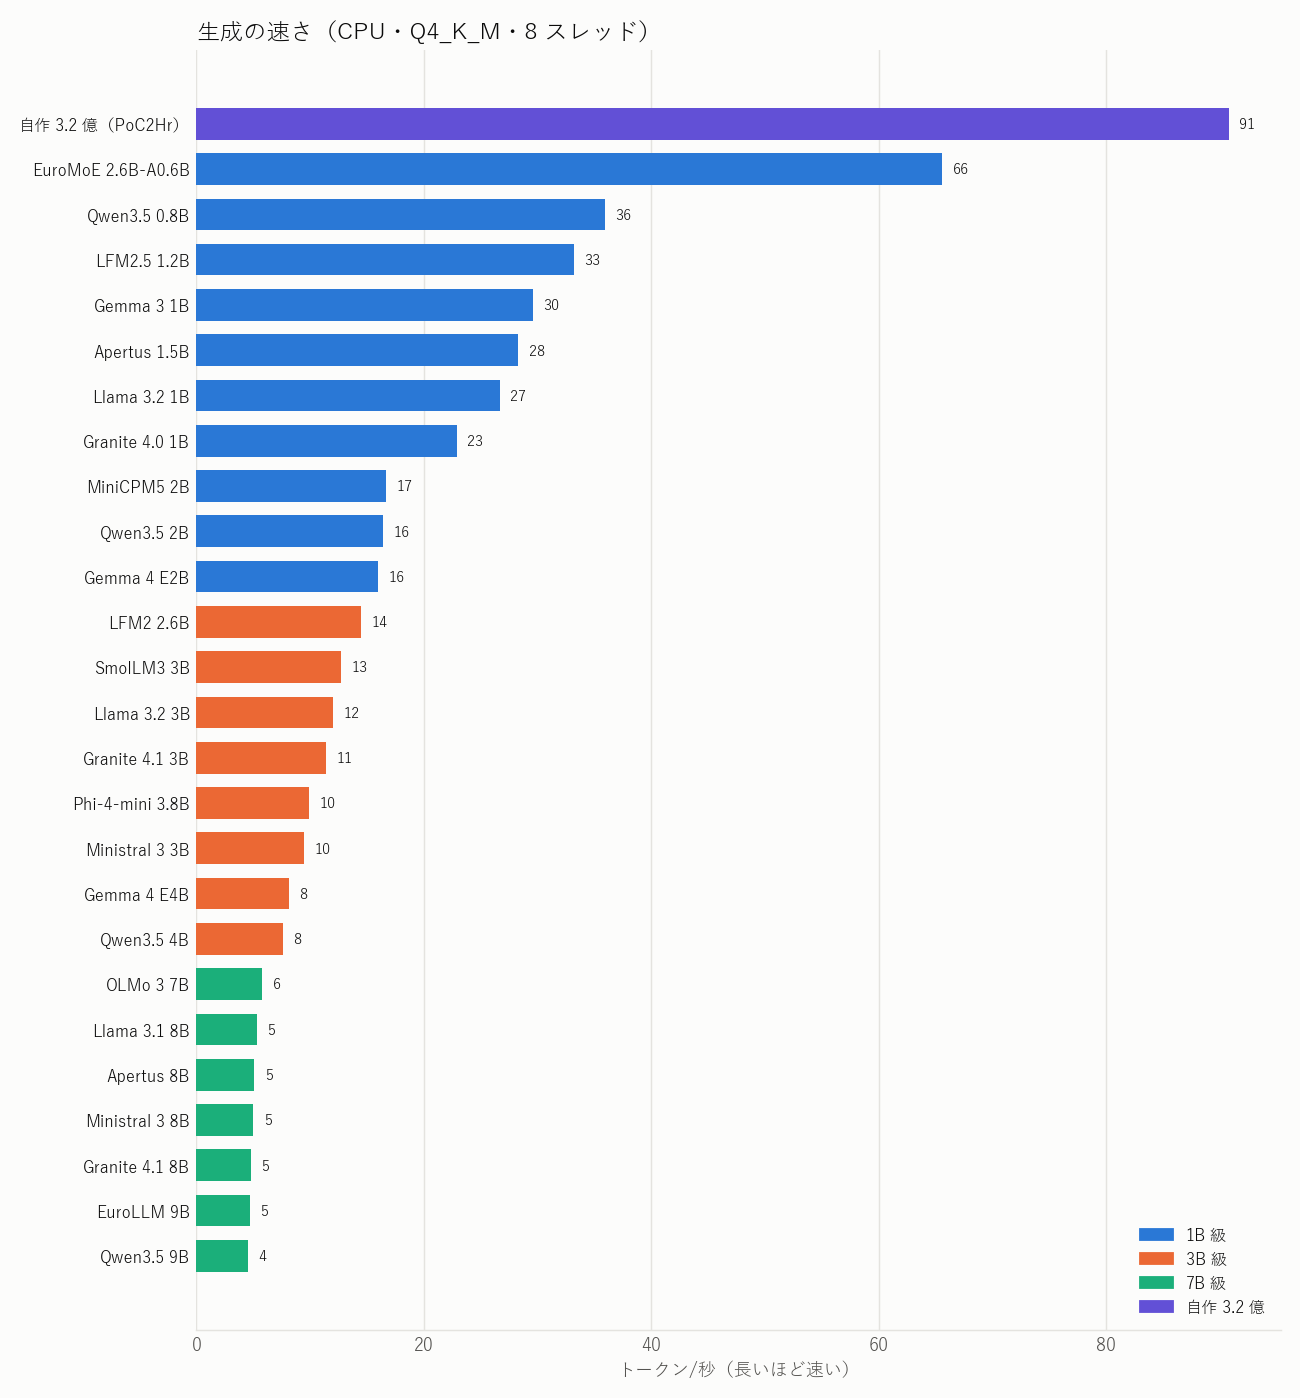
Ich habe auch die Zeit geschätzt, bis eine lange Frage beantwortet ist. Sie ergibt sich je Modell aus der Zeit zum Einlesen der Token eines langen Textes und der Zeit zum Generieren einer Antwort mit durchschnittlicher Länge.
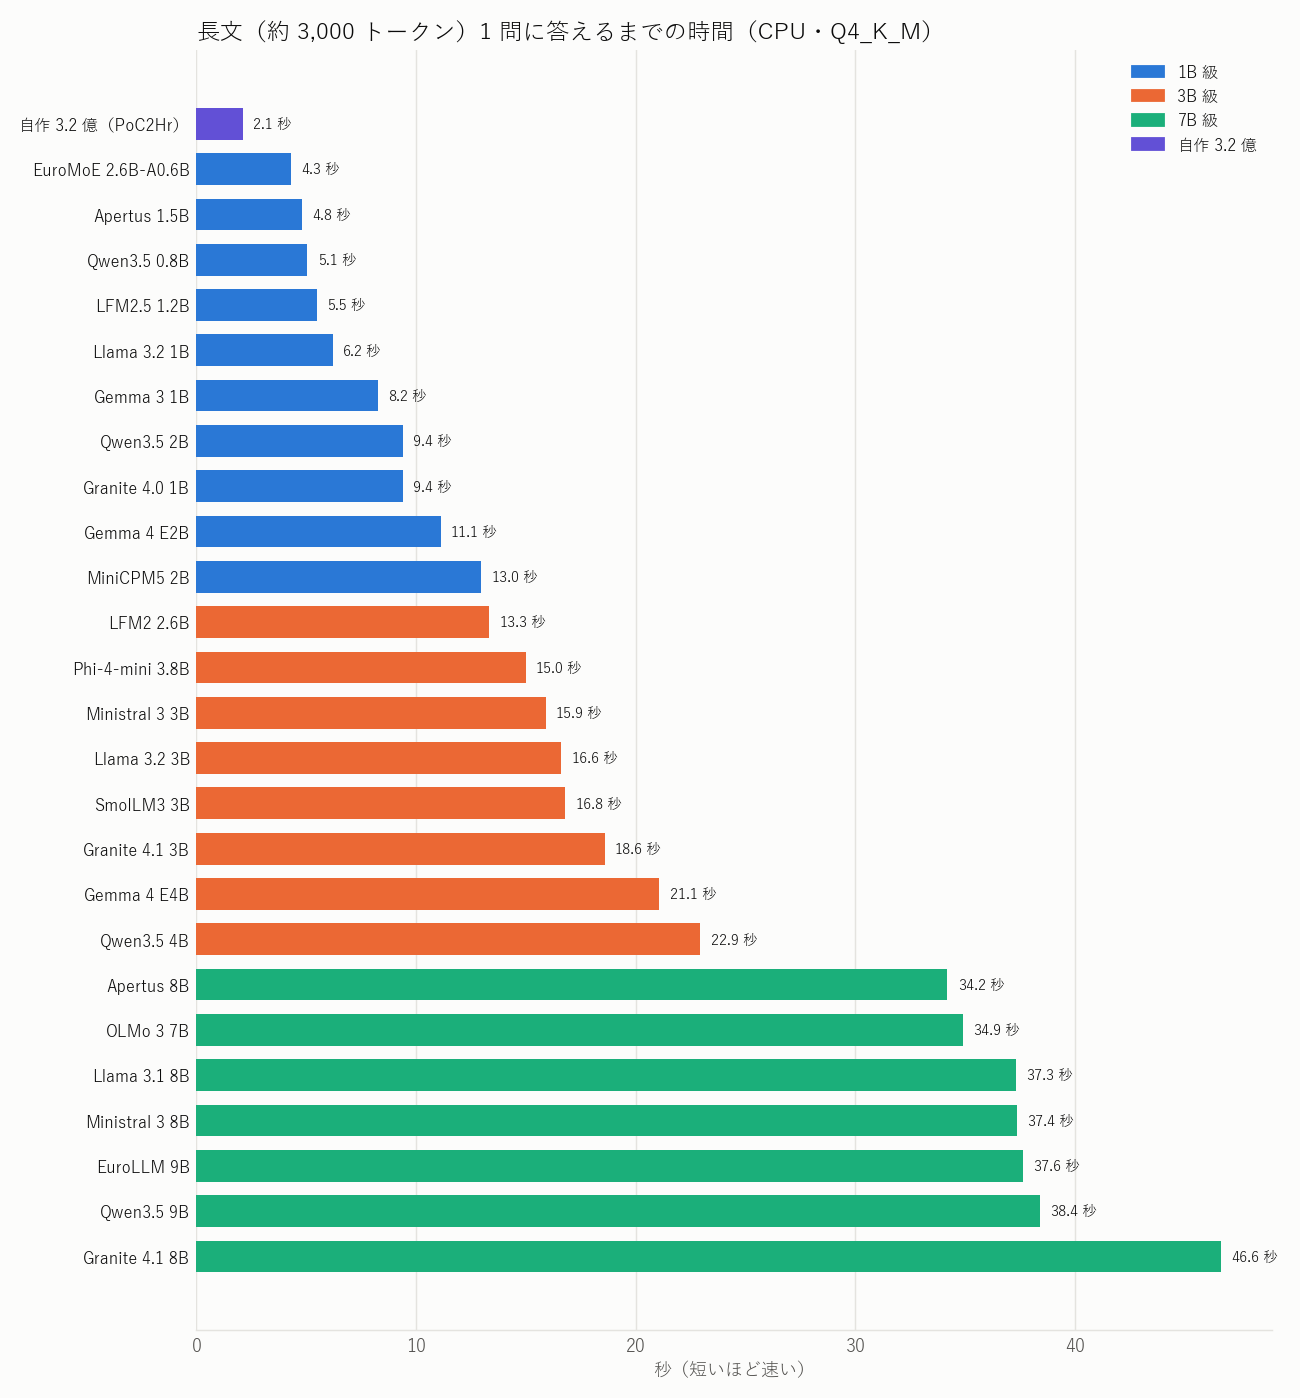
- Die Generierungsgeschwindigkeit ist grob umgekehrt proportional zur Modellgröße. Modelle der 7B-Klasse schaffen etwa 5 Token pro Sekunde und brauchen 34–47 Sekunden pro lange Frage
- Die 3B-Klasse benötigt 13–23 Sekunden, die 1B-Klasse 4–13 Sekunden
- Selbst bei demselben langen Text variiert die Zahl der Eingabe-Token je nach Modell zwischen 2.443 und 3.796. Das hängt davon ab, wie kurz der Tokenizer Kroatisch darstellen kann, und der eigens für Kroatisch entwickelte Tokenizer meines Modells ist am kürzesten
Geschwindigkeit und Genauigkeit nebeneinander
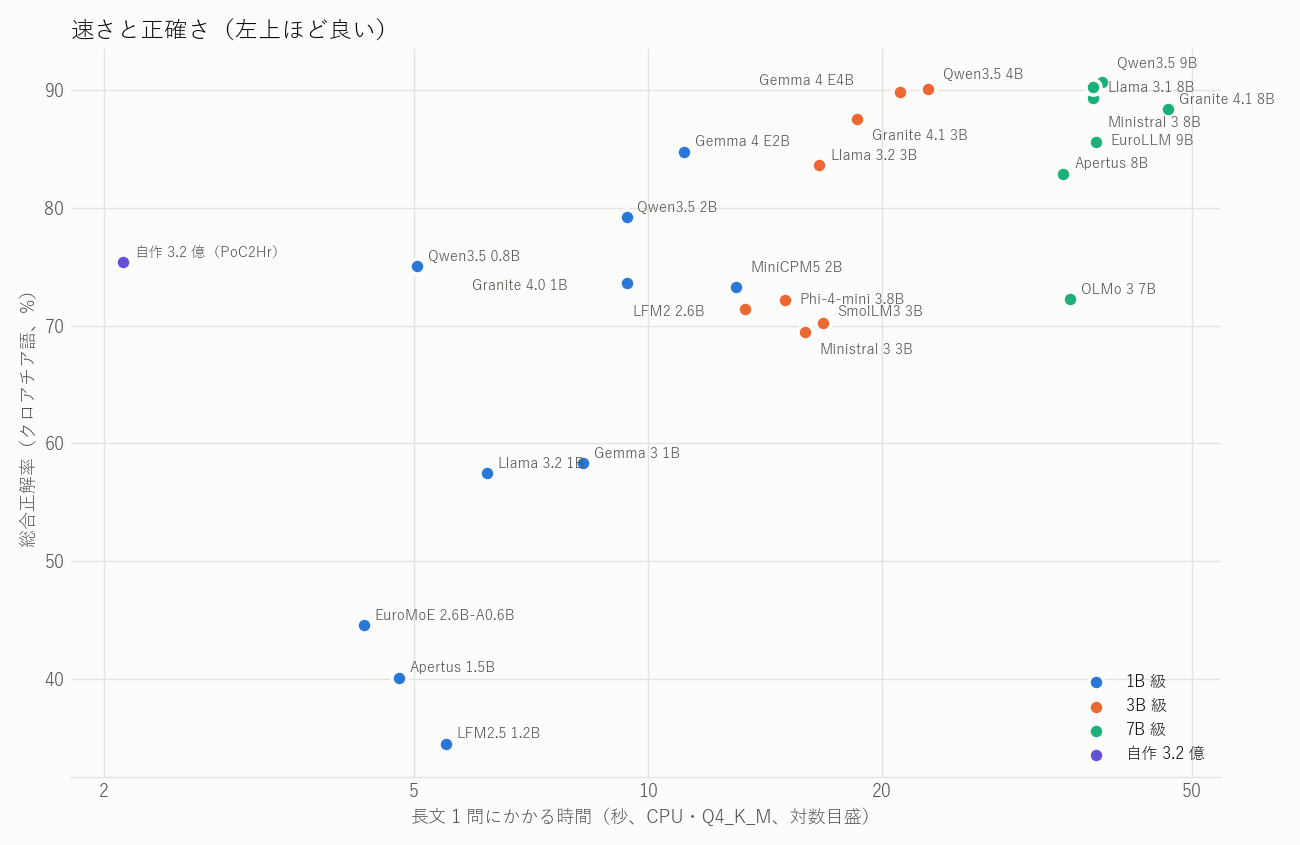
Je weiter oben links, desto „schneller und genauer“.
- Ein gutes Gleichgewicht bieten Gemma 4 E2B (11 Sekunden, 85 %) und Qwen3.5 2B (9 Sekunden, 79 %)
- Wer Genauigkeit priorisiert, sollte Qwen3.5 4B oder Gemma 4 E4B wählen (21–23 Sekunden, 90 %). Sie sind mehr als 1,5-mal schneller als die 7B-Klasse und nahezu genauso genau
- Mein eigenes 320M-Modell ist bei der Geschwindigkeit in einer eigenen Liga (2,1 Sekunden). Seine Gesamtgenauigkeit von 75 % entspricht Qwen3.5 0.8B, und bei der geringen Zahl erfundener Antworten liegt es auf dem Niveau der Spitzenmodelle. Bei langen Texten erreicht es aber nur 46 % Genauigkeit und ist damit deutlich schwächer als Qwen3.5 0.8B (75 %) oder Gemma 4 E2B (88 %)
- Da mein eigenes Modell kein Englisch gelernt hat, erfand es bei 91 % der langen englischen Texte ohne Antwort eine Antwort
Hinweise
- Die Bewertung stammt von einem LLM und ist daher nicht perfekt. Sie fällt etwas großzügig aus
- Die englische Version ist maschinell übersetzt. Sowohl die Erstellung der Fragen als auch die Übersetzung erfolgten mit EuroLLM-9B, was EuroLLM leicht begünstigen könnte (das Ergebnis lag mit 86 % im Mittelfeld)
- Apertus 1.5B kann nur bis zu 4.096 Token Kontext verarbeiten; 23 % der langen kroatischen Texte passten nicht hinein. Diese Fälle wurden als falsch gezählt
- Die Genauigkeit wurde auf der GPU gemessen (vLLM, 7B-Klasse in FP8), die Geschwindigkeit auf der CPU (Q4_K_M); die Messumgebungen unterscheiden sich also. Durch Quantisierung könnte sich die Genauigkeit leicht verändern
- Die Geschwindigkeit wurde auf einem PC gemessen, auf dem meine üblicherweise genutzten Anwendungen geöffnet waren. Alle Modelle wurden unter denselben Bedingungen nacheinander gemessen, daher sollte der Vergleich aussagekräftig sein
Betrachtung
- Für RAG reichen inzwischen 4B aus. Die besten Modelle der 3–4B-Klasse sind ungefähr so genau wie die 7–9B-Klasse und auf der CPU 1,5- bis 2-mal schneller
- Bei der Modellwahl sollte man unbedingt prüfen, ob es ablehnen kann. Selbst bei ähnlicher Genauigkeit schwankt der Anteil erfundener Antworten bei Texten ohne Antwort je nach Modell zwischen 1 % und 99 %. Bei RAG werden bei der Suche häufig irrelevante Texte gefunden; deshalb ist das hier am wichtigsten
- Dasselbe Modell verhält sich je nach Sprache anders. Im Englischen waren viele Modelle zu vorsichtig und verpassten Antworten. Das lässt sich nur durch Tests in der tatsächlich verwendeten Sprache herausfinden
- Die Schwäche meines eigenen Modells sind lange Texte. Seine Fähigkeit abzulehnen und seine Geschwindigkeit sind ausreichend. Wenn die Genauigkeit bei langen Texten steigt, dürfte es als „auf der CPU laufendes RAG-Modell“ sehr gut nutzbar sein. Das möchte ich als Nächstes verbessern
Nachtrag: Auch RAG-spezifische Modelle ausprobiert
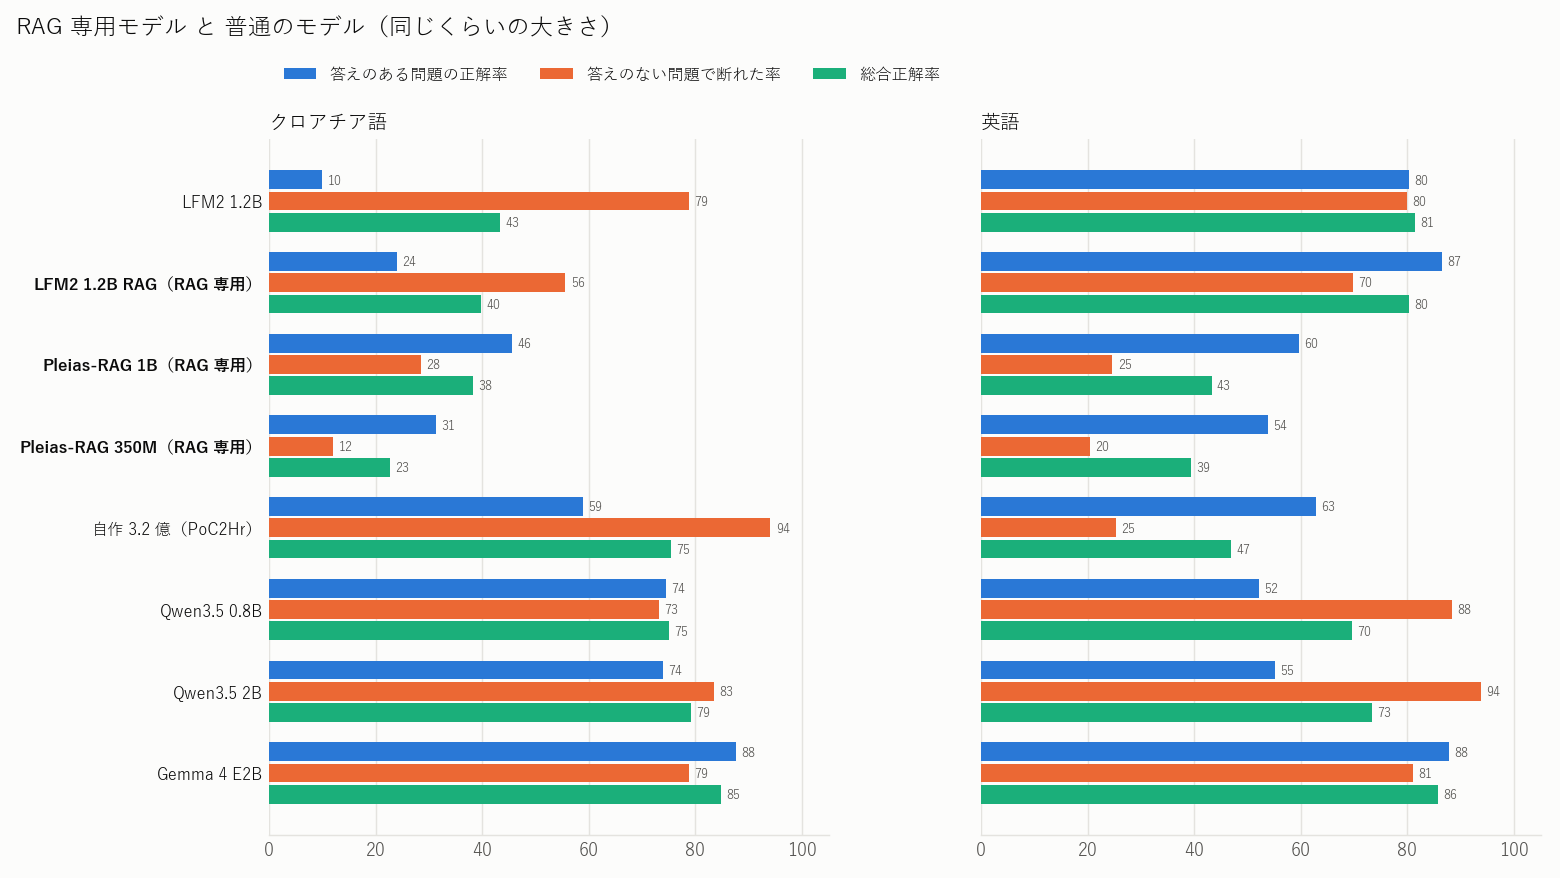
Ich fragte mich: „Wie sind Modelle, die speziell für RAG optimiert wurden?“ Also testete ich zusätzlich drei kleine RAG-spezifische Modelle. Die Bedingungen waren dieselben wie oben (dieselben 260 Aufgaben, dieselbe Bewertung).
- LFM2-1.2B-RAG (Liquid AI): LFM2-1.2B, weitertrainiert mit über einer Million Beispielen, bei denen ein Dokument vorgelegt und eine Antwort gegeben wird. Unterstützte Sprachen sind neun Sprachen, darunter Englisch und Japanisch; Kroatisch ist nicht dabei
- Pleias-RAG-1B / Pleias-RAG-350M (PleIAs): Modelle, die mit rund 3,1 Millionen synthetischen RAG-Datensätzen trainiert wurden. Vor der Antwort schreiben sie „Analyse der Frage → Analyse der Materialien → Entwurf“ und versehen die Antwort mit einem Zitat aus dem Text. Unterstützt werden sieben europäische Sprachen, Kroatisch ist nicht dabei. Der verarbeitbare Kontext beträgt höchstens 4.096 Token
- Zum Vergleich habe ich auch das ursprüngliche, unveränderte LFM2-1.2B gemessen, auf dem LFM2-1.2B-RAG basiert
LFM2-1.2B-RAG erhielt dieselbe Anweisung wie die anderen Modelle. Pleias akzeptiert nur ein spezielles Eingabeformat, bei dem Frage und Materialien durch eigene Zeichen getrennt werden. Deshalb habe ich das Format der offiziellen Bibliothek verwendet und nur den abschließenden Antwortteil bewertet. Pleias konnte daher nicht die Anweisung erhalten, bei fehlender Antwort auf eine bestimmte Weise zu antworten.
| Modell | Gesamt (Kroatisch) | Gesamt (Englisch) | Erfundene Antworten bei langem Text ohne Antwort (Kroatisch / Englisch) | Zeit pro lange Frage (CPU) |
|---|---|---|---|---|
| LFM2 1.2B (Ausgangsmodell) | 43 % | 81 % | 42 % / 36 % | 7,8 Sekunden |
| LFM2 1.2B RAG | 40 % | 80 % | 61 % / 51 % | 8,1 Sekunden |
| Pleias-RAG 1B | 38 % | 43 % | 57 % / 73 % | 16,9 Sekunden |
| Pleias-RAG 350M | 23 % | 39 % | 68 % / 92 % | 6,0 Sekunden |
| Referenz: Eigenes 320M-Modell | 75 % | 47 % | 9 % / 91 % | 2,1 Sekunden |
| Referenz: Qwen3.5 0.8B | 75 % | 70 % | 43 % / 21 % | 5,1 Sekunden |
| Referenz: Gemma 4 E2B | 85 % | 86 % | 37 % / 32 % | 11,1 Sekunden |
Kurz gesagt: Unter den Bedingungen dieses Tests fand ich keinen Punkt, in dem die RAG-spezifischen Modelle besser als normale Modelle waren.
LFM2-1.2B-RAG: Es antwortet häufiger, erfindet aber auch häufiger etwas
Verglichen mit dem ursprünglichen LFM2-1.2B stieg im Englischen die Genauigkeit bei Aufgaben mit Antwort (Absatz 83 % → 87 %, langer Text 78 % → 86 %). Aber auch das Erfinden von Antworten bei Texten ohne Antwort nahm zu (Absatz 4 % → 10 %, langer Text 36 % → 51 %), sodass die Gesamtwertung mit 81 % → 80 % fast gleich blieb. Das zusätzliche RAG-Training scheint das Modell in Richtung „auf jeden Fall antworten“ verschoben zu haben.
Auf Kroatisch war schon das Ausgangsmodell kaum nutzbar. Das ursprüngliche LFM2-1.2B lehnte 93 % der Absätze mit Antwort mit „Es gibt keine Antwort“ ab, während die RAG-Version auffällig oft die Anweisung selbst zurückgab, etwa „Odgovori kratko, jednom rečenicom.(Antworte kurz in einem Satz.)“. Da Kroatisch nicht zu den unterstützten Sprachen gehört, ist das unvermeidlich.
Pleias-RAG: Es fügt Zitate an, aber diese Zitate stehen nicht im Text
Pleias lehnte selbst bei Texten ohne Antwort fast nie ab. Im Englischen erfand das 1B-Modell bei 78 % der Absätze ohne Antwort und bei 73 % der langen Texte ohne Antwort eine Antwort.
Auch das beworbene „Antworten mit Zitaten“ ist fragwürdig. Ich habe gezählt, wie oft sich der zitierte Satz exakt im Text fand (vollständige Übereinstimmung, bei der nur Unterschiede in Leerzeichen ignoriert wurden; auch leicht umformulierte Zitate zählen also als „nicht gefunden“).
| Aufgaben mit Antwort | Aufgaben ohne Antwort | |
|---|---|---|
| Pleias-RAG 1B (Englisch) | 64 % | 42 % |
| Pleias-RAG 1B (Kroatisch) | 57 % | 53 % |
| Pleias-RAG 350M (Englisch) | 66 % | 39 % |
| Pleias-RAG 350M (Kroatisch) | 52 % | 40 % |
Zum Beispiel: „Welche Band schrieb den Song Tourniquet ursprünglich?“ (Die Antwort ist Soul Embraced.)
- Bei einem Absatz ohne die Antwort sagte das 1B-Modell „Amy Lee schrieb ihn“ und fügte „Amy Lee (born Amy Leigh Lee, November 1, 1970) ...“ als Zitat eines Satzes an, der nicht im Text steht
- Selbst bei einem Absatz mit der Antwort sagte es „Amy Lee schrieb ihn“. Das angehängte Zitat lautete jedoch „originally written ... for the Christian death metal band Soul Embraced“; das Zitat ist korrekt, aber die Antwort widerspricht ihm
Ein Zitat lässt eine Antwort so aussehen, als sei sie wirklich im Text begründet – gerade deshalb ist das besonders gefährlich.
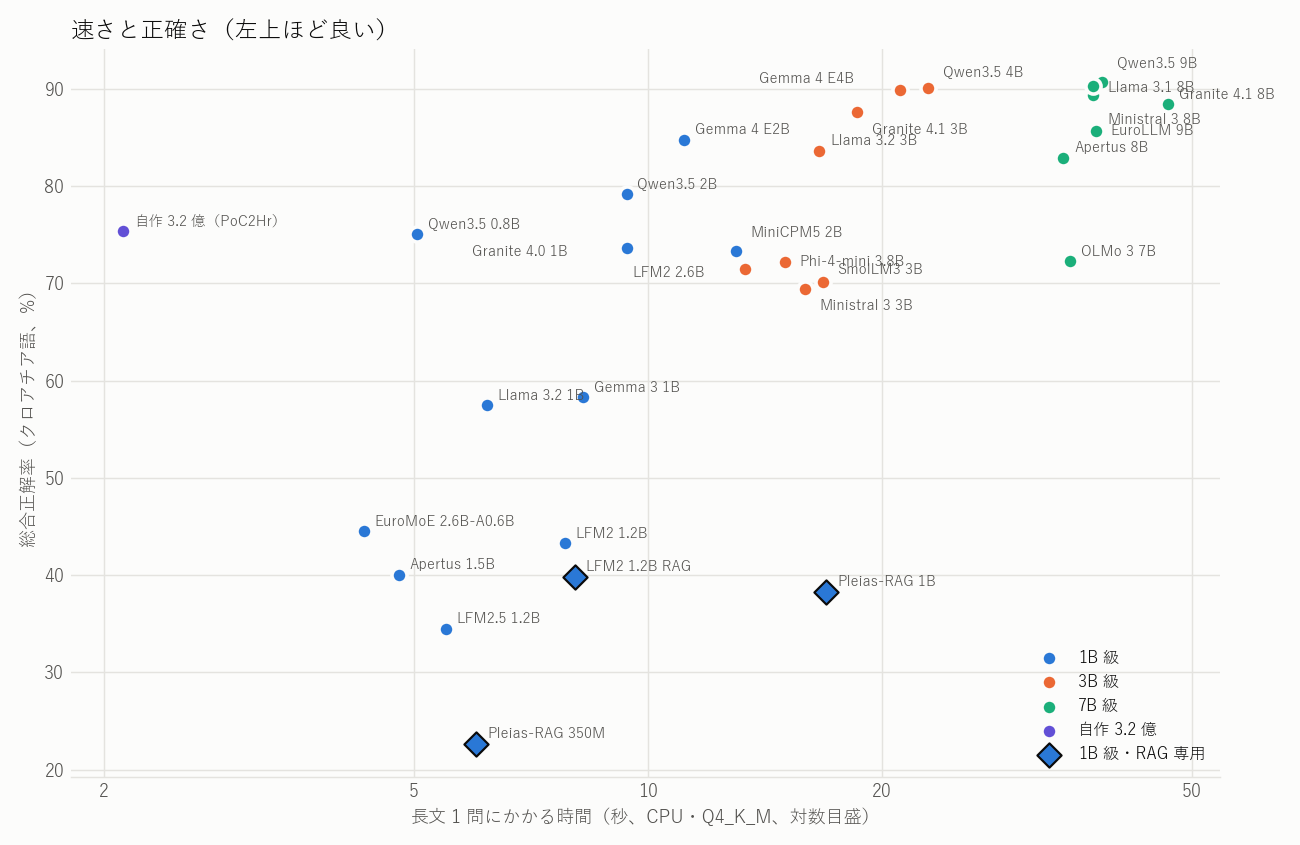
Auch bei der Geschwindigkeit ist Pleias im Nachteil, weil es vor der Antwort eine Analyse schreibt und die Antworten dadurch lang werden (bei langen Texten durchschnittlich 381–420 Token). Das 1B-Modell brauchte 16,9 Sekunden pro lange Frage und war damit langsamer als Gemma 4 E2B (11,1 Sekunden). Außerdem passten 25 % der langen kroatischen Texte nicht in den Kontext (sie wurden als falsch gezählt; die Zeit ist der Durchschnitt nur der Fälle, die hineinpassten, daher dauert es in der Praxis etwas länger).
Warum ist das so? (Vermutung)
- Sprache: Keines der drei Modelle unterstützt Kroatisch. Allerdings verlieren sie selbst auf Englisch gegen normale Modelle
- Form der Aufgaben: Diesmal ging es darum, „aus einem Text kurz zu antworten bzw. bei fehlender Antwort abzulehnen“. Pleias wurde bei Aufgaben bewertet, bei denen Antworten aus mehreren Quellen kombiniert werden (etwa HotpotQA); möglicherweise liegt seine Stärke in einer anderen Aufgabenform
- Art der Ablehnung: Normalen Modellen kann man sagen: „Wenn keine Antwort vorhanden ist, antworte so.“ Bei Pleias gibt es keine Stelle, an der eine solche Anweisung übergeben werden kann. Das Modell verfügt zwar über einen Mechanismus, um zu entscheiden, dass die Materialien keine Antwort erlauben, doch in diesem Test griff er kaum
Zusammenfassung des Nachtrags
- Man sollte nicht allein wegen der Bezeichnung „RAG-spezifisch“ wählen. Unter diesen Bedingungen waren normale Instruktionsmodelle wie Gemma 4 E2B oder Qwen3.5 genauer und lehnten ab, wenn sie es sollten
- Antworten mit Zitaten sind bedeutungslos, wenn man nicht die Zitate selbst überprüft. Nur 40–70 % der Pleias-Zitate ließen sich wörtlich im Text finden
- Mein eigenes Modell ist besser als RAG-spezifische Modelle ähnlicher Größe. Gegenüber Pleias-RAG 350M stehen bei der kroatischen Gesamtwertung 75 % zu 23 % und bei der Zeit pro lange Frage 2,1 Sekunden zu 6,0 Sekunden. Es hatte also einen Sinn, es speziell für Kroatisch zu entwickeln
Die Geschwindigkeit der vier zusätzlich getesteten Modelle wurde am Abend desselben Tages auf demselben PC und unter denselben Bedingungen gemessen. Sie wurden auch in die Grafik zu Geschwindigkeit und Genauigkeit aufgenommen.
Alle Ergebnisse
Kroatisch
| Modell | Klasse | Absätze korrekt | Lange Texte korrekt | Gesamt | Halluzination ohne Antwort (Absatz/Langtext) | Anteil korrekter Antworten |
|---|---|---|---|---|---|---|
| Qwen3.5 9B | 7B-Klasse | 84% | 90% | 91% | 1% / 10% | 91% |
| Llama 3.1 8B | 7B-Klasse | 88% | 88% | 90% | 2% / 15% | 90% |
| Qwen3.5 4B | 3B-Klasse | 82% | 88% | 90% | 1% / 9% | 92% |
| Gemma 4 E4B | 3B-Klasse | 87% | 91% | 90% | 2% / 19% | 87% |
| Ministral 3 8B | 7B-Klasse | 88% | 85% | 89% | 3% / 14% | 89% |
| Granite 4.1 8B | 7B-Klasse | 91% | 90% | 88% | 2% / 30% | 84% |
| Granite 4.1 3B | 3B-Klasse | 88% | 88% | 88% | 2% / 29% | 83% |
| EuroLLM 9B | 7B-Klasse | 87% | 75% | 86% | 5% / 14% | 88% |
| Gemma 4 E2B | 1B-Klasse | 88% | 88% | 85% | 5% / 37% | 78% |
| Llama 3.2 3B | 3B-Klasse | 80% | 81% | 84% | 2% / 27% | 81% |
| Apertus 8B | 7B-Klasse | 85% | 80% | 83% | 8% / 29% | 81% |
| Qwen3.5 2B | 1B-Klasse | 74% | 74% | 79% | 4% / 29% | 79% |
| Eigenbau 320M | Eigenbau | 72% | 46% | 75% | 3% / 9% | 72% |
| Qwen3.5 0.8B | 1B-Klasse | 74% | 75% | 75% | 11% / 43% | 68% |
| Granite 4.0 1B | 1B-Klasse | 83% | 77% | 74% | 22% / 51% | 64% |
| MiniCPM5 2B | 1B-Klasse | 62% | 44% | 73% | 1% / 6% | 89% |
| OLMo 3 7B | 7B-Klasse | 80% | 70% | 72% | 7% / 64% | 62% |
| Phi-4-mini 3.8B | 3B-Klasse | 91% | 89% | 72% | 38% / 64% | 64% |
| LFM2 2.6B | 3B-Klasse | 69% | 61% | 71% | 5% / 43% | 62% |
| SmolLM3 3B | 3B-Klasse | 83% | 78% | 70% | 20% / 73% | 62% |
| Ministral 3 3B | 3B-Klasse | 64% | 28% | 69% | 2% / 5% | 90% |
| Gemma 3 1B | 1B-Klasse | 79% | 62% | 58% | 32% / 89% | 48% |
| Llama 3.2 1B | 1B-Klasse | 73% | 35% | 57% | 43% / 33% | 48% |
| EuroMoE 2.6B-A0.6B | 1B-Klasse | 73% | 67% | 45% | 80% / 94% | 42% |
| LFM2 1.2B | 1B-Klasse | 5% | 15% | 43% | 1% / 42% | 21% |
| Apertus 1.5B | 1B-Klasse | 88% | 58% | 40% | 99% / 75% | 44% |
| LFM2 1.2B RAG | 1B-Klasse · nur RAG | 23% | 25% | 40% | 28% / 61% | 24% |
| Pleias-RAG 1B | 1B-Klasse · nur RAG | 73% | 18% | 38% | 63% / 57% | 35% |
| LFM2.5 1.2B | 1B-Klasse | 45% | 18% | 34% | 53% / 75% | 23% |
| Pleias-RAG 350M | 1B-Klasse · nur RAG | 54% | 9% | 23% | 85% / 68% | 21% |
Englisch
| Modell | Klasse | Absätze korrekt | Lange Texte korrekt | Gesamt | Halluzination ohne Antwort (Absatz/Langtext) | Anteil korrekter Antworten |
|---|---|---|---|---|---|---|
| Gemma 4 E4B | 3B-Klasse | 86% | 87% | 88% | 3% / 18% | 85% |
| Granite 4.1 8B | 7B-Klasse | 85% | 78% | 87% | 3% / 15% | 89% |
| Gemma 4 E2B | 1B-Klasse | 87% | 88% | 86% | 6% / 32% | 79% |
| Llama 3.1 8B | 7B-Klasse | 78% | 77% | 85% | 2% / 11% | 89% |
| Phi-4-mini 3.8B | 3B-Klasse | 87% | 90% | 85% | 10% / 31% | 80% |
| Llama 3.2 3B | 3B-Klasse | 78% | 82% | 85% | 2% / 20% | 85% |
| LFM2 2.6B | 3B-Klasse | 77% | 76% | 84% | 2% / 13% | 88% |
| Qwen3.5 9B | 7B-Klasse | 69% | 80% | 84% | 1% / 9% | 92% |
| Granite 4.0 1B | 1B-Klasse | 87% | 77% | 83% | 6% / 29% | 81% |
| Ministral 3 8B | 7B-Klasse | 78% | 63% | 82% | 2% / 8% | 91% |
| Qwen3.5 4B | 3B-Klasse | 63% | 77% | 82% | 1% / 8% | 92% |
| EuroLLM 9B | 7B-Klasse | 83% | 58% | 81% | 3% / 10% | 90% |
| Granite 4.1 3B | 3B-Klasse | 80% | 57% | 81% | 1% / 10% | 90% |
| LFM2 1.2B | 1B-Klasse | 83% | 78% | 81% | 4% / 36% | 76% |
| LFM2 1.2B RAG | 1B-Klasse · nur RAG | 87% | 86% | 80% | 10% / 51% | 73% |
| SmolLM3 3B | 3B-Klasse | 90% | 85% | 79% | 16% / 52% | 71% |
| Apertus 8B | 7B-Klasse | 78% | 82% | 78% | 7% / 47% | 73% |
| Qwen3.5 2B | 1B-Klasse | 58% | 52% | 73% | 2% / 11% | 87% |
| OLMo 3 7B | 7B-Klasse | 52% | 47% | 71% | 0% / 8% | 90% |
| Gemma 3 1B | 1B-Klasse | 77% | 66% | 71% | 11% / 57% | 62% |
| Qwen3.5 0.8B | 1B-Klasse | 48% | 56% | 70% | 2% / 21% | 77% |
| Ministral 3 3B | 3B-Klasse | 53% | 30% | 67% | 1% / 6% | 90% |
| Llama 3.2 1B | 1B-Klasse | 57% | 35% | 65% | 9% / 16% | 73% |
| LFM2.5 1.2B | 1B-Klasse | 39% | 24% | 61% | 1% / 9% | 76% |
| MiniCPM5 2B | 1B-Klasse | 28% | 25% | 60% | 0% / 3% | 92% |
| EuroMoE 2.6B-A0.6B | 1B-Klasse | 57% | 52% | 55% | 27% / 66% | 53% |
| Apertus 1.5B | 1B-Klasse | 89% | 79% | 48% | 93% / 97% | 47% |
| Eigenbau 320M | Eigenbau | 73% | 53% | 47% | 55% / 91% | 40% |
| Pleias-RAG 1B | 1B-Klasse · nur RAG | 75% | 44% | 43% | 78% / 73% | 40% |
| Pleias-RAG 350M | 1B-Klasse · nur RAG | 63% | 44% | 39% | 67% / 92% | 34% |
Geschwindigkeit auf der CPU (i7-13700K · llama.cpp Q4_K_M)
| Modell | Größe | Generierung (Token/Sekunde) | Einlesen (Token/Sekunde) | Anzahl Eingabetoken für lange Texte | Zeit pro Frage zu langen Texten |
|---|---|---|---|---|---|
| Eigenbau 320M | 193 MB | 90.8 | 1,528 | 2,443 | 2.1 Sekunden |
| EuroMoE 2.6B-A0.6B | 1,541 MB | 65.6 | 778 | 2,920 | 4.3 Sekunden |
| Apertus 1.5B | 935 MB | 28.3 | 634 | 2,810 ※ | 4.8 Sekunden |
| Qwen3.5 0.8B | 517 MB | 35.9 | 742 | 3,258 | 5.1 Sekunden |
| LFM2.5 1.2B | 697 MB | 33.2 | 673 | 3,468 | 5.5 Sekunden |
| Pleias-RAG 350M | 219 MB | 97.2 | 1,685 | 2,853 ※ | 6.0 Sekunden |
| Llama 3.2 1B | 770 MB | 26.7 | 636 | 3,511 | 6.2 Sekunden |
| LFM2 1.2B | 697 MB | 31.4 | 675 | 3,468 | 7.8 Sekunden |
| LFM2 1.2B RAG | 697 MB | 32.8 | 678 | 3,468 | 8.1 Sekunden |
| Gemma 3 1B | 769 MB | 29.6 | 398 | 3,055 | 8.2 Sekunden |
| Qwen3.5 2B | 1,251 MB | 16.4 | 415 | 3,258 | 9.4 Sekunden |
| Granite 4.0 1B | 976 MB | 22.9 | 414 | 3,636 | 9.4 Sekunden |
| Gemma 4 E2B | 3,257 MB | 16.0 | 329 | 3,055 | 11.1 Sekunden |
| MiniCPM5 2B | 1,489 MB | 16.7 | 313 | 3,796 | 13.0 Sekunden |
| LFM2 2.6B | 1,491 MB | 14.5 | 278 | 3,468 | 13.3 Sekunden |
| Phi-4-mini 3.8B | 2,378 MB | 9.9 | 208 | 2,974 | 15.0 Sekunden |
| Ministral 3 3B | 2,048 MB | 9.5 | 215 | 3,100 | 15.9 Sekunden |
| Llama 3.2 3B | 1,926 MB | 12.0 | 237 | 3,511 | 16.6 Sekunden |
| SmolLM3 3B | 1,827 MB | 12.7 | 238 | 3,544 | 16.8 Sekunden |
| Pleias-RAG 1B | 710 MB | 31.6 | 583 | 2,853 ※ | 16.9 Sekunden |
| Granite 4.1 3B | 2,002 MB | 11.4 | 202 | 3,614 | 18.6 Sekunden |
| Gemma 4 E4B | 5,064 MB | 8.1 | 171 | 3,055 | 21.1 Sekunden |
| Qwen3.5 4B | 2,655 MB | 7.6 | 166 | 3,258 | 22.9 Sekunden |
| Apertus 8B | 4,824 MB | 5.1 | 102 | 3,158 | 34.2 Sekunden |
| OLMo 3 7B | 4,264 MB | 5.8 | 108 | 3,642 | 34.9 Sekunden |
| Llama 3.1 8B | 4,693 MB | 5.3 | 101 | 3,511 | 37.3 Sekunden |
| Ministral 3 8B | 4,958 MB | 5.0 | 95 | 3,100 | 37.4 Sekunden |
| EuroLLM 9B | 5,324 MB | 4.7 | 86 | 2,920 | 37.6 Sekunden |
| Qwen3.5 9B | 5,512 MB | 4.5 | 101 | 3,258 | 38.4 Sekunden |
| Granite 4.1 8B | 5,100 MB | 4.8 | 88 | 3,614 | 46.6 Sekunden |
※ Der Durchschnitt für Apertus 1.5B und Pleias-RAG umfasst nur lange Texte, die in den Kontext von 4.096 Token passen。