Ich habe ein kroatisches LLM für RAG mit 300 Millionen Parametern von Grund auf gebaut. Läuft auf der CPU
Nach dem GPT-2 beim letzten Mal habe ich diesmal ein kroatisches LLM von Grund auf mit einer RTX 4090 gebaut. Das Ziel ist RAG: ein Modell, das in übergebenen Texten nach Antworten sucht und dabei einen belegenden Satz zitiert. Und im Produktiveinsatz soll es auf der CPU laufen.
Vorab das Ergebnis.
- Vom Start bis zur Fertigstellung etwa 68 GPU-Stunden (einschließlich Ausprobieren und Optimieren). Davon entfielen 51 Stunden auf das Pretraining.
- 320 Millionen Parameter. Bei Fragen zu Absätzen 71 % korrekt, bei langen Texten mit rund 3.000 Tokens 44 %.
- Nur mit der CPU beantwortet es eine Frage in 3 bis 16 Sekunden. Die Ausgabe erscheint langsam genug, dass man die Zeichen beim Entstehen verfolgen kann.
Benötigte Trainingszeit
| Schritt | Zeit | Inhalt |
|---|---|---|
| Erzeugung der Trainingsdaten | etwa 4,5 Stunden | Mit EuroLLM-9B (vLLM): 45.000 Wikipedia-QA-Paare und 50.000 übersetzte Dialoge |
| Tokenizer und Tokenisierung | etwa 2,5 Stunden (CPU) | Eigenes kroatisches Vokabular mit 32.000 Einträgen erstellt |
| Pretraining | 50 Stunden 46 Minuten | 7 Milliarden Tokens. In den letzten 10 % den Kontext auf 4.096 erweitert |
| SFT | etwa 35 Minuten | Beantworten mit Zitat und Ablehnen bei fehlender Antwort beigebracht |
| Reinforcement Learning (GRPO) | etwa 11 Stunden | 400 Schritte plus Anpassungen für 300 Schritte |
Der selbst entwickelte Tokenizer kann Kroatisch mit ungefähr halb so vielen Tokens wie der GPT-2-Tokenizer darstellen. Mit 4.096 Tokens lassen sich rechnerisch rund 17.000 Zeichen lesen.
Das entstandene Modell
| Punkt | Inhalt |
|---|---|
| Parameter | 320 Millionen (24 Schichten, 1024 Dimensionen) |
| Architektur | Llama-/Qwen3-Familie (GQA, SwiGLU, RoPE, RMSNorm + QK-Norm) |
| Kontextlänge | 4.096 Tokens |
| Ausgabeformat | Antwort + Izvor: „ein direkt aus dem Kontext übernommener Satz“. Falls es keine Antwort gibt: „U tekstu nema odgovora na ovo pitanje.(Im Text gibt es keine Antwort auf diese Frage.)“ |
| Ausführung | Für CPUs ausgelegt (etwa 1,3 GB in fp32) |
Zusätzlich habe ich außen herum einen Mechanismus gebaut, der programmgesteuert prüft, ob das erzeugte Zitat wirklich im Kontext vorkommt; falls nicht, wird es durch „keine Antwort“ ersetzt. Entscheidend ist, dem Modell nicht blind zu vertrauen, sondern die Begründung überprüfbar zu machen.
Probleme, die sich beim Bau gezeigt haben
1. Es erfindet jedes Mal etwas, auch wenn es keine Antwort gibt. Anfangs habe ich ihm einfach gewöhnliches Frage-Antwort-Verhalten beigebracht. Die Trefferquote stieg, aber bei Texten ohne enthaltene Antwort erfand es zu 100 % eine plausibel klingende Antwort. Genau das, was bei RAG am problematischsten ist. Nachdem ich ihm Zitate und das „Ablehnen“ beigebracht hatte, sank die Zahl der Erfindungen auf wenige Prozent.
2. Es lehnt zu häufig ab. Bei der Bewertung für das Reinforcement Learning setzte ich „bei Fehler −0,5, bei Ablehnung 0“. Bei schwierigen langen Texten lernte das Modell daher, dass Ablehnen und Ausweichen vorteilhaft ist, und begann in 70 % der Fälle abzulehnen. Es nutzte die Lücke in der Bewertungsregel perfekt aus. Als ich eine Ablehnung mit −0,3 bewertete, schlug das Pendel in die andere Richtung aus: Es lehnte fast nie mehr ab, und in 40 % der Fälle erfand es etwas. Es ging wie auf einer Wippe hin und her.
3. Fehler beim Abschreiben von Zitaten. Bei langen Texten war die Antwort zwar richtig, aber die Wortreihenfolge im Zitat wurde vertauscht oder der erste Satz des Artikels zitiert. Bei langem Kontext war nur in ungefähr der Hälfte der Fälle auch das Zitat korrekt.
4. Fehler, die die Prüfung umgehen. Es zitierte korrekt einen in den Kontext gemischten Satz aus einem anderen Artikel wie „wurde in ○○ geboren“ und nannte dadurch den Geburtsort einer anderen Person. Das Zitat ist echt, daher kann die Prüfung es nicht stoppen.
5. Lücken in den Evaluierungsdaten. In einigen Fällen enthielt ein angeblich antwortloser Kontext noch Teile der Antwort; das Modell lag richtig und wurde dennoch als „Halluzination“ bewertet.
Endgültige Leistung
Jeweils 300 Fragen zur Evaluierung. Verwendet wurde das Modell beim 100. Schritt des angepassten Reinforcement Learnings – dort war das Gleichgewicht zwischen Ablehnen und Antworten am besten.
| Kontext | Richtig | Falsch | Abgelehnt |
|---|---|---|---|
| Absatz (etwa 100–400 Tokens) | 71,3 % | 16,7 % | 12,0 % |
| Langer Kontext (1.500–3.500 Tokens) | 44,0 % | 20,3 % | 35,7 % |
| Kontext ohne Antwort | Korrekt abgelehnt | Erfunden |
|---|---|---|
| Absatz | 97,7 % | 2,3 % |
| Langer Kontext | 92,3 % | 7,7 % |
Nach dem Durchlaufen der Prüfung betrug der „Anteil richtiger Antworten unter den gegebenen Antworten“ 73,8 %. Bis zum Ziel von 90 % ist es noch weit.
Nebenbei: Wenn das Modell jede Frage achtmal lösen durfte und schon ein richtiger Versuch genügte, erreichte es 91 % bei Absätzen und 74 % bei langen Texten (gemessen am letzten Checkpoint). Vor und nach dem Reinforcement Learning änderte sich diese Zahl kaum; verändert hat sich vielmehr, ob es die Aufgabe jedes Mal lösen konnte. Die Zahlen zeigen deutlich: Reinforcement Learning verleiht nicht so sehr neue Fähigkeiten, sondern sorgt dafür, dass Probleme, die manchmal gelöst werden, jedes Mal gelöst werden.
Auf der CPU getestet
Ich habe eine Web-UI zum Testen gebaut und sie nur mit einer CPU (i7-13700K) betrieben. Die Geschwindigkeit, mit der die Zeichen erscheinen, entspricht direkt der Generierungsgeschwindigkeit.
Absatz (263 Tokens): 0,3 Sekunden bis zum ersten Zeichen, etwa 11 Tokens/Sekunde, insgesamt 7 Sekunden
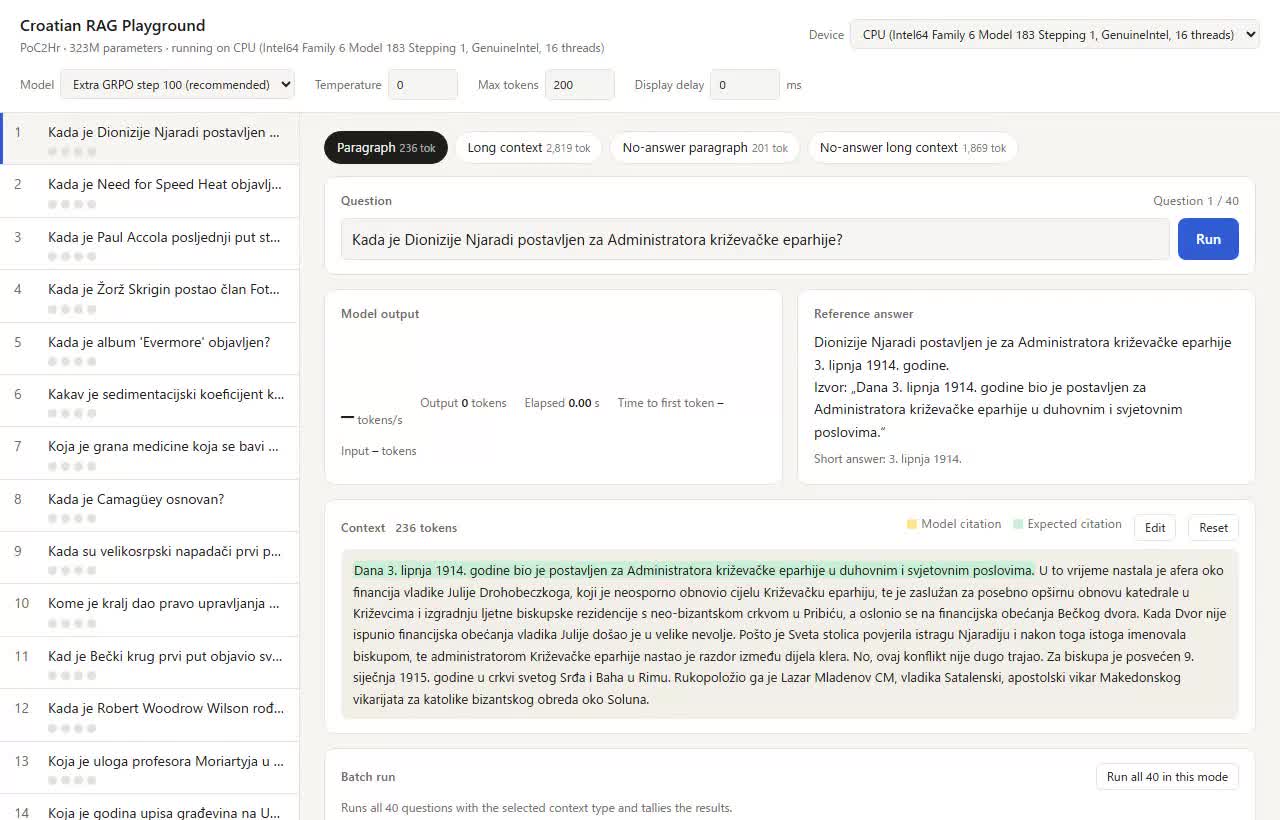
Langer Kontext (3.215 Tokens): Rund 5 Sekunden zum Einlesen des Textes, etwa 5 Tokens/Sekunde, insgesamt 19 Sekunden. Gelb markiert ist der zitierte Satz; das Modell findet tatsächlich den richtigen Satz unter 3.000 Tokens.
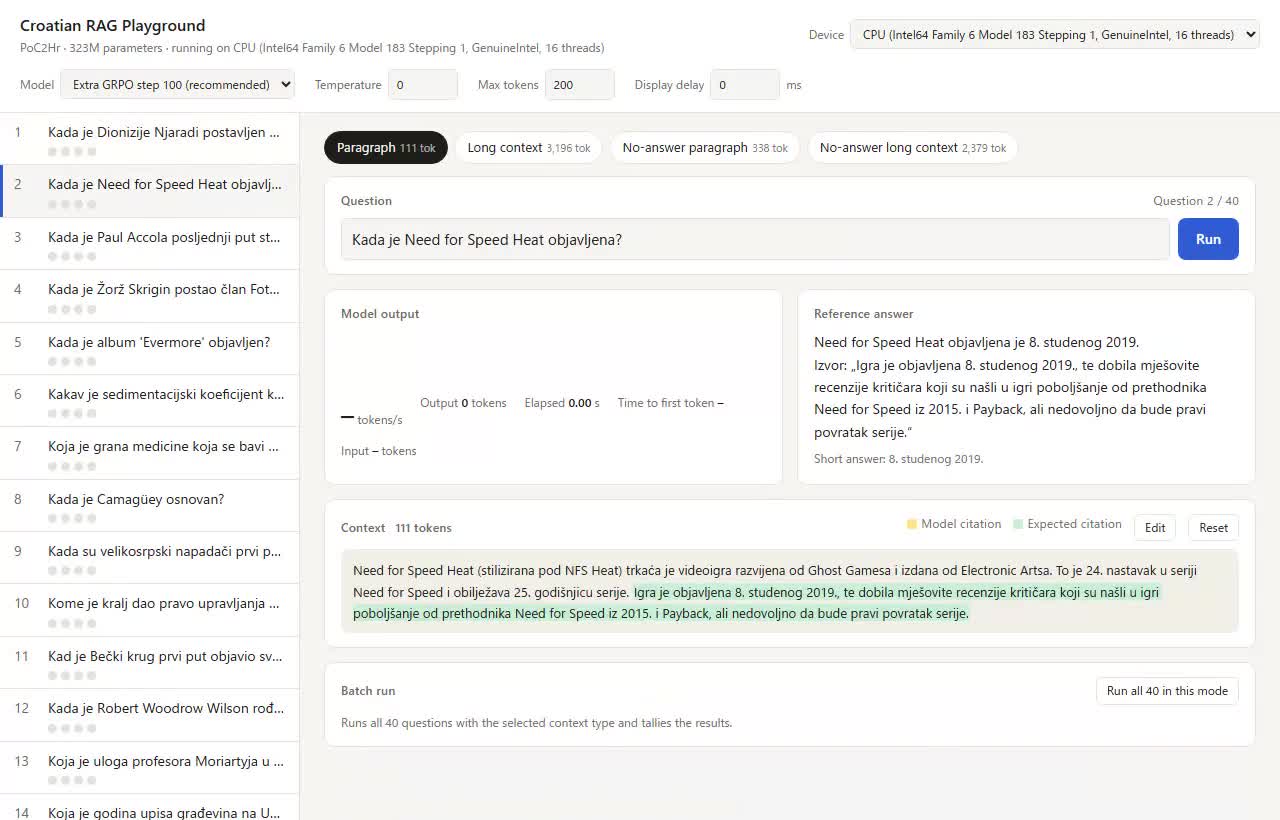
Das Video ist etwas langsamer, weil es während der Aufnahme läuft. Ohne Aufnahme, gemessen mit jeweils 20 Fragen, erreichte es bei Absätzen 15 Tokens/Sekunde und 3,4 Sekunden pro Frage, bei langem Kontext 7 Tokens/Sekunde und 16 Sekunden pro Frage. Die Antworten sind mit etwa 50 Tokens recht kurz, daher dürfte die Geschwindigkeit auch auf der CPU praktisch nutzbar sein.
Überlegungen
- Bei kleinen Modellen ist es am wichtigsten, ihnen beizubringen zu sagen: „Ich weiß nicht, was ich nicht weiß.“ Für RAG ist es wirksamer, Erfindungen zu reduzieren, als nur die Trefferquote zu erhöhen. Die Kombination aus Zitat, Ablehnung und externer Prüfung funktionierte ziemlich gut.
- 320 Millionen Parameter stoßen bei langen Texten an ihre Grenze. Selbst bei acht Versuchen kommen lange Texte nur auf 74 %. Für 90 % bei langen Texten wären vermutlich etwa 1 Milliarde Parameter nötig.
- Eine Prüfung, die nur feststellt, ob das Zitat wirklich existiert, reicht nicht aus. Sie muss auch prüfen, ob das Zitat die Zahl oder den Namen aus der Antwort enthält und ob das Subjekt mit der in der Frage genannten Person übereinstimmt.
- Ein auf der CPU laufendes Modell mit 320 Millionen Parametern eignet sich gut für Q&A über Dokumente, die nicht ins Netz gelangen dürfen. Auf einem Laptop oder Server ohne GPU kann es Antworten ausschließlich auf Grundlage lokaler Dokumente geben. Mit einigen Sekunden bis gut zehn Sekunden pro Frage ist es schnell genug; durch Quantisierung sollte es noch schneller werden (nicht überprüft).
Als Nächstes möchte ich mit einer Version mit 1 Milliarde Parametern 90 % bei langem Kontext anstreben.