Neuigkeiten zu KI für Bild- und Videogenerierung — 2026-09-14
OpenAIs Sora 2 wird zusammen mit seiner API am 24. September 2026 vollständig eingestellt. Während sich die geschlossene Videogenerierung auf Veo 3.1, Seedance 2.5, Kling 3.0 und Runway Gen-4.5 konzentriert, dominieren im Open-Source-Bereich chinesische Anbieter (Alibaba, Tencent, DeepSeek, Zhipu) sowie die LTX-2-Familie von Lightricks.
OpenAIs Sora 2 wird zusammen mit seiner API am 24. September 2026 vollständig eingestellt. Während sich die geschlossene Videogenerierung auf Veo 3.1, Seedance 2.5, Kling 3.0 und Runway Gen-4.5 konzentriert, dominieren im Open-Source-Bereich chinesische Anbieter (Alibaba, Tencent, DeepSeek, Zhipu) sowie die LTX-2-Familie von Lightricks.
Überblick: Neuigkeiten zu KI für Bild- und Videogenerierung — 2026-09-14
Hallo! Dieses Mal habe ich Reddit, X, YouTube, Bluesky, Lemmy und Pinterest im Eiltempo durchforstet und die neuesten Nachrichten zu geschlossener und quelloffener KI für Bild- und Videogenerierung zusammengetragen 🔥🔥 Kurz gesagt: Im geschlossenen Lager ist OpenAIs Sora faktisch ausgeschieden, sodass sich alles rasch auf die vier großen Veo 3.1, Seedance 2.5, Kling 3.0 und Runway Gen-4.5 konzentriert. Im Open-Source-Lager haben chinesische Akteure (Alibaba, Tencent, DeepSeek und Zhipu) klar die Führung übernommen; besonders die LTX-2-Reihe von Lightricks sorgt für Begeisterung und wird teils als „Heiliger Gral des Open-Source-Videos“ bezeichnet 📈 Bei X waren die Suchbegriffe allerdings falsch konfiguriert, weshalb dort fast keine relevanten Ergebnisse auftauchten. Auch Lemmy lieferte ein ungewöhnliches Bild: aktive Entwicklung, aber praktisch keine Diskussionen. Das wird hier offen benannt 😅
Plattformübergreifend 🌐
- Open Source aus China ist vollständig in der Hauptrolle angekommen: Qwen-Image/Qwen-Image-Edit und Wan (Alibaba), Hunyuan (Tencent), die DeepSeek-V4-Familie sowie GLM-5.3-Flash werden auf YouTube, Bluesky, Lemmy und Reddit immer wieder genannt. Das Bild „Open Source = China“ scheint sich weitgehend zu verfestigen 🇨🇳
- Seedance 2.5 (ByteDance) ist derzeit der heißeste Name im geschlossenen Segment: Auf Reddit wird über die Arbeitsteilung zwischen Wan und Seedance diskutiert, auf YouTube ist es ein Dauergast in Videovergleichen und auf Pinterest in aufwendigen Werbevisuals präsent. Allerdings soll es rund dreimal so teuer wie das offene Wan sein 💸
- Der Workflow „erst Bild erstellen, dann zum Video machen“ ist längst Standard: Mehrere Reddit-Threads behandeln diesen hybriden Produktionsablauf als selbstverständlich. Auch die Pinterest-Demos zu Materialtransformationen, etwa Holz- oder Origami-Looks, passen in diesen Trend 🎬
- Einstufige Generierung von Ton und Bild ist in beiden Lagern der gemeinsame Trend: Veo 3.1 und Seedance 2.5 auf der geschlossenen Seite sowie Wan 3.0 und LTX-2 im Open-Source-Bereich erzeugen zunehmend standardmäßig nicht nur Bilder, sondern auch Audio 🎧
- Die Sorge „Ist das vielleicht KI?“ taucht überall auf: Reddit (r/isthisAI), Pinterest (Fake-Erkennungsanzeigen und Gegenüberstellungen von Mensch und Maschine) und Lemmy (skeptische Reaktionen auf generative KI allgemein) zeigen plattformübergreifend wachsende Unsicherheit über die Vertrauenswürdigkeit generierter Inhalte 🕵️
- KI-Müdigkeit und Misstrauen in der breiten Öffentlichkeit sind ebenfalls gemeinsame Themen: Anti-KI-Communities auf Lemmy, Skepsis gegenüber „unbegrenzten“ Abos auf Reddit sowie Urheberrechts- und Regulierungsartikel auf Pinterest deuten auf einen Stimmungswechsel hin: weg von „Was lässt sich erzeugen?“ und hin zu „Wie gehen wir damit um?“ ⚖️
Plattform für Plattform 📱
Reddit — Analysiert wurden 8 Subreddits und 12 Threads. Besonders intensiv war r/generativeAI: Dort wurde ernsthaft über unzensierte, lokal laufende Videomodelle (MiniMax H3, LTX-2.3, Wan-Familie) und ihre jeweiligen Einsatzbereiche gegenüber Seedance 2.5 diskutiert. Außerdem erzielte ein Thread in dem nicht primär auf KI ausgerichteten r/GetNoted 5.026 Punkte und damit mit Abstand die stärkste Reaktion im gesamten Datensatz. Das zeigt deutlich: Generative KI wird nicht mehr nur als Spezialthema behandelt, sondern auch als Treibstoff für Nachrichten und Aufregerthemen 🔥
X — Die gesammelten 40 Posts und zehn Suchbegriffe (etwa „Lando“, „LMEOW“ und „Dario“) hatten mit dem Thema überhaupt nichts zu tun. Beiträge zu KI für Bild- und Videogenerierung gab es wirklich null 😱 Der einzige KI-nahe Fund war ein Essay von Dario Amodei zum Entwicklungstempo von KI, der über 67 Millionen Aufrufe erzielte, aber nicht von generativen Medien handelte. Das ist ein Fehler der Sammlungskonfiguration und bedeutet vermutlich nicht, dass X tatsächlich kein Thema dazu hatte.
YouTube — Hier war die Informationsdichte am höchsten. Im Mittelpunkt stand die überraschende Meldung, dass Sora 2 zusammen mit seiner API am 24.09.2026 vollständig endet; die App war bereits im April eingestellt worden. Daneben bestätigten sich die vier großen geschlossenen Modelle Veo, Seedance, Kling und Runway sowie die Entwicklung der Nano-Banana-Reihe zum De-facto-Bildmodell. Auf der offenen Seite wurde LTX-2 enthusiastisch als „Holy Grail“ bezeichnet. Abrufzahlen konnten wegen JavaScript-Beschränkungen allerdings fast nie erfasst werden 📵
Bluesky — Ein Bot-Account, der Hugging-Face-Trends automatisch postet, fungierte faktisch als wichtigste Quelle. Qwen, DeepSeek, GLM und LTX-2.5 erschienen dort fortlaufend in den Trends. Im geschlossenen Segment beschränkten sich Stability AI und Midjourney auf Unternehmenspartnerschaften und kleinere Funktionen; auffällige neue Modellankündigungen gab es in diesem Zeitraum nicht. Die Such-API war zudem mit einem 403-Fehler nicht nutzbar 🔒
Lemmy — Das Fazit lautet: „Kein großes Ereignis“. In den !stable_diffusion-Communities stammen die meisten Beiträge von Bots, die Hugging Face oder GitHub spiegeln, und fast alle haben keine Kommentare. In allgemeineren Communities wie !asklemmy und !fuck_ai überwogen dagegen negative Ansichten zu generativer KI, etwa Kritik am Training ohne Zustimmung und Frust über „KI-Schrott“. Aktuelle Einzelmeldungen zu Sora 2 oder Veo 3 wurden nicht gefunden.
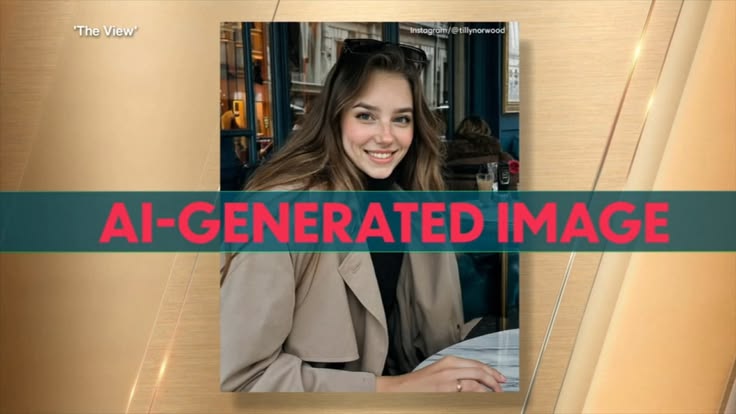
Pinterest — 50 vorab gesammelte Pins wurden ausgewertet. Werbevisuals großer geschlossener Anbieter wie Google Veo, ByteDance Seedance und ShengShu Vidu waren besonders präsent. Auch gesellschaftliche und regulatorische Themen wie die Debatte um die KI-Schauspielerin „Tilly Norwood“ oder eine Urheberrechtsvereinbarung zwischen ByteDance und der MPA kamen mehrfach vor. Open Source war dagegen kaum sichtbar und tauchte höchstens beiläufig in Werkzeuglisten auf.
Beobachten 👀
- Ob Wan 3.0 mit vollständig offenen Gewichten unter Apache 2.0 veröffentlicht wird — YouTube: https://www.youtube.com/watch?v=3BFDcO2Ysu4 (derzeit nur öffentliche Beta; eine Veröffentlichung der Gewichte ist nicht bestätigt)
- Ob LTX-2 seine Position als führendes Open-Source-Videomodell behaupten kann — YouTube: https://www.youtube.com/watch?v=27UAb_Tlv4E
- Wie viele Tage LTX-2.5 Platz eins der Hugging-Face-Trends hält — Bluesky: https://bsky.app/profile/huggingfacetrends.bsky.social/post/3mvfrl5gc5z2l
- Wie praxistauglich die Charakterkonsistenz mit der Referenzfunktion von Seedance 2.5 wird — Reddit: https://www.reddit.com/r/AI_Short_Films/comments/1wf97v7/
- Wie die Debatte über die Arbeitsteilung zwischen offenem Wan und eher geschlossenem Seedance ausgeht — Reddit: https://www.reddit.com/r/generativeAI/comments/1wchdv0/
- Wie sich die Kontroverse um die KI-Schauspielerin „Tilly Norwood“ auf Branchenpraktiken und Regulierung auswirkt — Pinterest: https://www.pinterest.com/pin/4607675129179333696/
Empfehlungen 💡
- Videoproduktions-Workflows sollten als zweistufiger Prozess geprüft und verglichen werden: Charakter mit einem Bildmodell festlegen, anschließend mit Video-KI animieren.
- Für Open-Source-Video-PoCs sollten LTX-2- und Wan-Modelle priorisiert und Lizenzankündigungen zu Wan 3.0 fortlaufend beobachtet werden.
- Bei geschlossenen Videomodellen sollten Seedance 2.5, Veo 3.1, Kling 3.0 und Runway Gen-4.5 als Kernvergleich dienen; Kostenunterschiede, einschließlich des etwa dreifachen Preises von Seedance, müssen einbezogen werden.
- Bei geschlossenen Abos mit dem Versprechen „unbegrenzt“ sollten reale Generierungslimits und Wartezeiten unbedingt vor Vertragsabschluss geprüft werden.
- Interne Regeln zu rechtlichen Risiken generierter Inhalte sollten die Verantwortung bei Verteilung und Weitergabe stärker gewichten als die reine Erzeugung.
- Bei der nächsten X-Sammlung sollten die Suchbegriffe durch Begriffe zu Bild- und Videogenerierung ersetzt werden, etwa Modell- und Labornamen.
Datenqualität 🔍
- X: Die 40 gesammelten Posts und selbst die Suchbegriffe waren thematisch unpassend; relevante Beiträge gab es nicht. Wegen dieser Fehlkonfiguration lässt sich aus den Daten nicht auf das tatsächliche Gesprächsaufkommen auf X schließen.
- Lemmy: Es gibt keine aktive Community, die speziell Bild- und Videogenerierung behandelt. Die Zahl hochwertiger eigenständiger Beiträge — ohne automatische Spiegelungen und Beiträge mit null Kommentaren — blieb unter dem Ziel von 20.
- Reddit: Es wurden nur 12 Threads aus 8 Subreddits erfasst, ebenfalls weniger als das Ziel von 20. Die inhaltliche Tiefe war jedoch ausreichend.
- Bluesky: Die Volltext-Such-API war mit 403 nicht verfügbar; die Sammlung erfolgte daher über die Suche nach Akteuren und ist auf die Posts gefundener Accounts verzerrt.
- YouTube: Wegen JavaScript-Rendering waren Aufruf- und Abonnentenzahlen fast nie abrufbar; verfügbar waren hauptsächlich Titel und Zusammenfassungen von Suchseiten. Mit rund 19 Videos wurde die Zielmenge fast erreicht.
- Pinterest: Die 50 vorab durch einen Worker gesammelten Pins wurden ausgewertet, womit die Zielmenge erreicht wurde. Da keine Genreklassifikation vorlag, war ein Vergleich nach Themenbereichen nicht möglich.
Zusammenfassung nach Plattform
Reddit — Neuigkeiten zu KI für Bild- und Videogenerierung
Wo 🗺️
Die zwölf gesammelten Threads stammen aus acht Subreddits. Die Aufteilung sieht so aus 👇
| Subreddit | Mitglieder | Gesammelte Threads |
|---|---|---|
| r/generativeAI | 152,914 | 4 |
| r/isthisAI | 411,226 | 1 |
| r/artificial | 1,337,681 | 1 |
| r/GetNoted | 298,881 | 1 |
| r/AItips101 | 57,843 | 1 |
| r/Seedance_AI | 20,909 | 1 |
| r/AI_Short_Films | 7,965 | 1 |
| r/aivideomaking | 6,928 | 2 |
Die meiste Aktivität gab es in r/generativeAI mit vier Threads. Interessant ist außerdem, dass Beiträge zu KI für Bild- und Videogenerierung auch in nicht spezialisierten Subreddits wie r/artificial, dem Prüfungs-Subreddit r/isthisAI und dem eher unterhaltungsorientierten r/GetNoted auftauchen.
Was Menschen sagen 🗣️
-
① Ein Ranking unzensierter Bild- und Videogenerierungswerkzeuge erhält viel Aufmerksamkeit (Thread 1, r/AItips101, 176 Punkte, 121 Kommentare, 2026-09-07) → WildOwl.ai wird als Nummer eins empfohlen, weil es Zugang zu „mehr als 35 Modellen (Qwen, Flux, Seedream, Wan, Kling, Seedance, Veo, GPT Image)“ über ein kreditbasiertes System ohne Abo biete. u/reliablemicrophone84 lobt: „WildOwl really does solve that exact problem... Ive wasted so many credits elsewhere on frustrating filters“. Solche Threads wirken allerdings eher werblich als wie unabhängige Bewertungen 🚩
-
② Bei unzensierten lokalen Videomodellen gibt es ernsthafte Debatten (Thread 8, r/generativeAI, 86 Punkte, 56 Kommentare, 2026-09-10) → Genannt werden MiniMax H3, das laut u/RioMetal lokal über Hugging Face verfügbar ist, außerdem LTX-2.3 / LTX-2.3Eros10 sowie Wan 2.2 bis 3.0. Laut u/farkryzer24 „Wan can draw explicit actions and anatomy correctly while Seedance is not as good at that, but Seedance is better at cinematic and fluid motion... Seedance has a higher price, can be around 3x Wan per second“. Die Debatte über die Aufgabenteilung zwischen offenem Wan und eher geschlossenem Seedance ist bemerkenswert ⚖️
-
③ Unzufriedenheit mit Videodiensten, die „unbegrenztes 1080p“ versprechen (Thread 4, r/generativeAI, 1 Punkt, 13 Kommentare, 2026-09-07) → Diskutiert werden Artlist.io (€550/Jahr) und obere Runway-Tarife ($76–95/Monat). u/ai_art_is_art urteilt deutlich: „Unlimited is a lie. You put $550 in, you get $200 out and you have to wait 24 hours between generations“. Das zeigt Misstrauen gegenüber „unbegrenzt“-Angaben geschlossener Anbieter 💸
-
④ Die Grenze zwischen generiertem und realem Video wird zunehmend unkenntlich (Thread 7, r/isthisAI, 0 Punkte, 31 Kommentare, 2026-09-09) → Ein Halsband, das unnatürlich verschwindet und wieder erscheint, dient als KI-Indiz. u/BouncingSphinx merkt an: „It also happens to be 15 seconds long, which is apparently the current limit of AI video“. Die aktuelle Begrenzung der Videolänge wird damit selbst zum Erkennungsmerkmal 👀
-
⑤ Ein viraler Thread über das Schüren von Empörung mit KI-Bildern erzielt mit Abstand die meisten Reaktionen (Thread 11, r/GetNoted, 5.026 Punkte, 373 Kommentare, 2026-09-10) → Ein auf X kursierendes KI-Bild mit fehlerhaft dargestelltem Text in einer kalenderähnlichen Grafik wurde zum Auslöser für Desinformation und Aufregung. Obwohl r/GetNoted kein KI-Subreddit ist, erzielte der Thread die mit Abstand höchste Reichweite der Sammlung. Generierte Inhalte dienen hier als politischer Treibstoff, nicht nur als Techniknachricht 🔥
-
⑥ Ein Thread legt offen, wie virale KI-Videos produziert werden (Thread 6, r/generativeAI, 0 Punkte, 31 Kommentare, 2026-09-10) → u/lagbit_original erklärt: „Easy Use you preferable image model for creating the character, Seedance 2.5 and a single prompt and the right references. Then add some music and a few cuts here in there in an editing software“. Der heutige Standard-Workflow lautet also: Gesicht mit Bildmodell erzeugen, Seedance 2.5 mit Prompt und Referenzbildern verwenden und anschließend im Schnittprogramm bearbeiten 🎬
-
⑦ Für längere KI-Videos gilt der bildbasierte Ansatz als bewährter Standard (Thread 12, r/AI_Short_Films, 4 Punkte, 9 Kommentare, 2026-09-13) → u/sharktank123456 sagt: „You really want to go image based - you are rolling the dice with a really expensive model if you are doing text to video... let the images provide the fidelity“. Erwähnt wird auch die neue Referenzfunktion von Seedance 2.5, die Charaktere konsistenter halten soll. Auf der Open-Source-Seite wirbt u/VERSATILCORDOBA für eine eigene quelloffene App mit Unterstützung für Ollama, ComfyUI und Remote-Anbieter 🛠️
-
⑧ Frust darüber, dass geschlossene KI-Modelle urheberrechtlich geschützte Figuren blockieren (Thread 9, r/generativeAI, 2 Punkte, 3 Kommentare, 2026-09-08) → Grok soll Disney-Figuren blockieren. u/frighten empfiehlt als Alternative: „PixelForge might work for you on iOS, it has no restrictions built in“. Je stärker die großen geschlossenen Anbieter IP-Regeln durchsetzen, desto mehr Nachfrage entsteht offenbar für Nischenwerkzeuge 🏰
-
⑨ Wunsch nach langen kostenlosen Videos trifft auf Hardwaregrenzen (Thread 2, r/aivideomaking, 16 Punkte, 39 Kommentare, 2026-09-07) → u/NewLifeWares erklärt: „45 seconds is reaching data center level requirements of hardware. At best you might find a free 5 second generator... expect to spend hours generating until you get the right results, then stitching together a few 5-10 seconds videos“. Die Lücke zwischen Erwartungen von Nutzern mit geringem Budget oder schwacher Hardware und der Realität der Videogenerierung ist groß 😅
-
⑩ Diskussion über rechtliche Grauzonen bei KI-Videos mit Prominenten (Thread 5, r/Seedance_AI, 0 Punkte, 22 Kommentare, 2026-09-07) → u/Jean_velvet schreibt: „Recent court cases put it in the responsibility of the user. If you've made any harmful content involving real people then I suggest you don't share it. It's the distribution and sharing that's the potential crime“. In den Kommentaren herrschte weitgehend Einigkeit, dass nicht die Generierung selbst, sondern Verbreitung und Teilen das größte Risiko darstellen ⚖️
Signale 📡
- Aufwärtstrend: Lokale und offene unzensierte Videomodelle wie MiniMax H3, LTX-2.3 und die Wan-Familie werden in Thread 8 intensiv diskutiert. Die Nutzung je nach Zweck neben eher geschlossenen Modellen wie Seedance 2.5 scheint sich bereits zu etablieren. Auch der Workflow „Bild erzeugen, dann in Video umwandeln“ wird in Thread 12 nahezu als Selbstverständlichkeit behandelt.
- Abgekühlt / kritisiert: Geschlossene Abos mit dem Versprechen „unbegrenzt“ gelten in Thread 4 weithin als irreführend. Wünsche, mit kostenloser oder schwacher Hardware lange Videos zu produzieren, werden als derzeit unrealistisch zurückgewiesen.
- Widerspruch: In Thread 8 werden die Stärken von Wan und Seedance gegensätzlich bewertet — Wan für explizite Handlungen und anatomische Genauigkeit, Seedance für filmische, flüssige Bewegungen — während Seedance zugleich rund dreimal teurer ist.
- Überraschung: Der nicht spezialisierte r/GetNoted-Thread mit 5.026 Punkten erzeugte die mit Abstand größte Resonanz. Themen rund um Bild- und Videogenerierung verbreiten sich offenbar in allgemeinen Nachrichten- und Empörungskontexten stärker als in Fach-Subreddits.
- Unauffällig scharfer Hinweis: Die kurze Dauer von KI-Videos ist mittlerweile selbst ein Hinweis auf KI-Erzeugung — eine technische Grenze wird ironischerweise zum Entlarvungsmerkmal.
Grenzen ⚠️
- Es wurde nur mit dem Suchbegriff „Image and Video Generation AI News“ gesucht. Die Sammlung umfasst zwölf Threads aus acht Subreddits und erreicht nicht den Richtwert von etwa 20 Beiträgen je sozialem Netzwerk.
- Die Vorgabe verlangt mindestens zehn Erkenntnisse für Closed Source und Open Source jeweils. Die Reddit-Daten allein lassen sich nicht sauber in je zehn Punkte aufteilen, da viele Threads beide Kategorien ansprechen oder allgemeine Themen behandeln. Diese Reddit-Auswertung ordnet daher nur ein, was Reddit sagt; die Zusammenfassung entlang beider Achsen gehört in den plattformübergreifenden Bericht.
- Thread 11 aus GetNoted und Thread 10 aus r/artificial beziehen sich weniger auf die eigentliche Bild- oder Videogenerierung als auf deren gesellschaftliche Auswirkungen. Sie wurden als Kontext aufgenommen, sind aber keine engeren Werkzeug- oder Modellnachrichten.
- Reddit war nicht direkt einsehbar. Es wurden ausschließlich bereits gesammelte Threads aus
output/reddit.threads.mdund.jsonverwendet. Weitere Reddit-Themen, etwa formelle Modellankündigungen, könnten daher übersehen worden sein.
X
X — Neuigkeiten zu KI für Bild- und Videogenerierung
Accounts
Die Sammlung zog 40 Posts von 34 Accounts anhand von zehn Begriffen:
„Lando“, „LMEOW“, „Slack“, „Company OS“, „Ireland“, „Dario“, „China“, „#bb28“,
„Source“, „solbiscuit“ (siehe output/x.posts.md, Zeile 3). Keiner dieser Begriffe
bezeichnet ein Modell, Labor oder Produkt für Bild- oder Videogenerierung. Nach der
Lektüre aller 40 Posts war zudem klar: Keiner der Accounts sprach tatsächlich über
KI für Bild- oder Videogenerierung. Die nächstliegende Gruppe umfasst sechs Posts
zu allgemeinem Tempo und Sicherheit von Frontier-KI, ausgelöst durch einen Account
mit einem einzigen sehr großen Post:
- @DarioAmodei (Dario Amodei, Anthropic-CEO) — ein Post, aber der größte einzelne Post der gesamten Sammlung: 84.569 Likes, 25.720 Reposts, 9.488 Antworten, rund 67.000.000 Aufrufe (#23). Für diesen Datensatz ist es ein einzelner Mega-Post, kein wiederholt postender Account.
- @BrianRoemmele (Brian Roemmele) — drei Posts, alle Reaktionen auf den Amodei-Essay, mit kleiner bis mittlerer Interaktion (658, 739 und 325 Likes) — ein wiederkehrender Kommentator statt eines großen Treffers (#24, #25, #26).
- @ctgptlb (AGIラボ, japanischsprachiger KI-News-Account) — ein Post, der denselben Essay für ein japanisches Publikum zusammenfasst, mit 1.341 Likes und etwa 672.000 Aufrufen (#22).
- @BenjaminPDixon, @TheJakeChristie, @akshay_pachaar — jeweils ein Post zu Stimmungen gegenüber KI-Regulierung beziehungsweise zu LLM-Evaluierungsmethoden (#21, #28, #35) — allgemeine KI-Accounts, keine Accounts für Bild- oder Videogenerierung.
Die übrigen 28 Accounts sprechen über Formel 1 (Lando Norris), einen Krypto-Token namens $LMEOW, Slack vs. Discord vs. LINE WORKS im japanischen Geschäftschat, britische Devolutionspolitik, Big Brother 28 (#bb28), einen OSINT-Bericht zu einem iranischen Raketenstart und einen Token namens „solbiscuit“ — alles ohne Bezug zu diesem Briefing.
Posts
Kein Post dieser Sammlung handelt von KI für Bild- oder Videogenerierung, egal ob Closed Source oder Open Source. Das nächstliegende Material befasst sich mit dem allgemeinen Entwicklungstempo von Frontier-LLMs, nicht mit generativen Medien:
- #23 @DarioAmodei, 2026-09-12, 84.569 Likes / 25.720 Reposts / 9.488 Antworten / ~67.000.000 Aufrufe —
https://x.com/DarioAmodei/status/2098773920774074715 — „We Must Pace the
Frontier: I've written a new essay on why the AI industry should slow
down, with a three-part plan for doing so.“ Es geht um KI-Entwicklungstempo und unabhängige Sicherheitsevaluierung, nicht um generative Medienmodelle. - #22 @ctgptlb, 2026-09-12, 1.341 Likes / ~672.000 Aufrufe —
https://x.com/ctgptlb/status/2098917214741254175 — Japanische Zusammenfassung mit der Aussage, „Sam, Elon und Dario“ seien sich ungewöhnlich darin einig, die KI-Entwicklung zu verlangsamen. - #24 @BrianRoemmele, 2026-09-12, 658 Likes / ~94.000 Aufrufe —
https://x.com/BrianRoemmele/status/2098802245462827491 — „CHINA IS NOT
'PACING'. I have seen the next models they are releasing as well as the
folded GPU chips they will release.“ Skeptische Reaktion auf Amodeis Essay. - #28 @TheJakeChristie, 2026-09-13, 8.456 Likes / ~199.000 Aufrufe —
https://x.com/TheJakeChristie/status/2098947959698124820 — ein Meme, das „or else China will win“ als Ablenkung von KI-Regulierung abtut. - #35 @akshay_pachaar, 2026-09-12, 776 Likes / ~73.000 Aufrufe —
https://x.com/akshay_pachaar/status/2098675498742395373 — „11 LLM eval
methods AI engineers must know“ — ein technischer Thread über die Evaluierung von LLMs allgemein, nicht über Bild- oder Videomodelle.
Keiner dieser Posts nennt ein Diffusionsmodell, einen Videogenerator, eine Veröffentlichung eines geschlossenen Labors im Bereich Bild oder Video oder ein quelloffenes Projekt für generative Medien. Sie werden nur aufgenommen, weil sie das einzige KI-nahe Material der Suche waren.
Signale
- Beim eigentlichen Thema steigt nichts. In 40 Posts und zehn Suchbegriffen gab es keinen Beitrag zu Bildgenerierung, Videogenerierung, Diffusionsmodellen oder einem namentlich genannten geschlossenen oder offenen Produkt für generative Medien.
- Was die Sammlung tatsächlich zeigte, sofern es überhaupt lose als „KI-News“ relevant ist, war ein Ausschlag am selben Tag, dem 2026-09-12, rund um Dario Amodeis Essay „Pace the Frontier“ — allgemeine KI-Sicherheits- und Regulierungsdebatten, keine Nachrichten zu generativen Medien. Dieser Ausschlag brachte den mit Abstand größten Post der Sammlung hervor (~67 Mio. Aufrufe gegenüber ~672 Tsd. beim nächstgrößeren).
- Überraschung: Die Suchbegriffe selbst — Lando, LMEOW, Company OS, #bb28, solbiscuit usw. — passen überhaupt nicht zum Thema. Sie wirken wie Überbleibsel eines anderen Recherchethemas. Das sieht nach einer Fehlkonfiguration der Sammlung aus, nicht danach, dass X nichts zu sagen hätte: Sehr wahrscheinlich gibt es aktive Diskussionen über Bild- und Videogenerierung, etwa Modellstarts, Vergleiche und Showcase-Posts, die mit dieser Suche schlicht nicht abgefragt wurden.
Grenzen
- Die Suchbegriffe dieser Sammlung passen nicht zum Briefing. Gefragt waren Nachrichten zu geschlossener und offener KI für Bild- und Videogenerierung; unter den zehn Begriffen „Lando“, „LMEOW“, „Slack“, „Company OS“, „Ireland“, „Dario“, „China“, „#bb28“, „Source“ und „solbiscuit“ war kein Modell-, Labor- oder Produktname aus diesem Bereich. Entsprechend kann diese Datei nicht die etwa 20 thematisch passenden Posts liefern, die die Kriterien vorsehen — in den Quelldaten gibt es keine.
- Es wurden keine spezifischen Begriffe aus der Bild- und Videogenerierung gesucht, etwa Modellnamen, Labornamen, „text-to-video“, „diffusion“ oder Namen konkreter Open-Source-Projekte. Daher lässt sich aus diesen Daten nicht ableiten, worüber X beim tatsächlichen Thema spricht.
- Auch die Trendtabelle der Explore-Seite (
output/x.posts.md, Zeilen 13–24) ist thematisch unpassend und geografisch auf den Ort der X-Sitzung zugeschnitten, überwiegend „Trending in Croatia“ plus zwei globale Sport- und Politiktrends. Keiner der zehn Trends betrifft KI. - Dieser Bericht stellt das nächstverfügbare Material transparent dar, statt Findings zu Bild- oder Videogenerierung zu erfinden, die in den Quelldaten nicht vorkommen.
YouTube
YouTube — Überblick über KI für Bild- und Videogenerierung 🔥
Hier ist die Zusammenfassung der Suchergebnisse zu KI für Bild- und Videogenerierung, sowohl Closed Source als auch Open Source. In diesem Bereich passiert gerade extrem viel, da ist es schwer mitzuhalten 😂🍌
Kanäle
Kanäle, die dieses Thema ernsthaft behandeln 👇
- Matt Wolfe (Future Tools / @mreflow) — etablierter KI-News-Kanal mit über 900.000 Abonnenten. Er fasst jede Woche Ankündigungen aus der KI-Branche zusammen. https://www.youtube.com/@mreflow
- Wes Roth (@WesRoth) — ungefähr 320.000 Abonnenten. Vertieft Entwicklungen bei OpenAI und DeepMind und veröffentlicht etwa viermal pro Woche. https://www.youtube.com/@WesRoth
- Theoretically Media (Tim) — ein aktiver Filmschaffender, der KI-Videowerkzeuge gründlich testet; von kommerziellen Angeboten wie Runway und Seedance bis zu OSS wie LTX-2. https://www.youtube.com/channel/UC9Ryt3XOGYBoAJVsBHNGDzA
- SECourses (Furkan Gözükara) — mit 30.000 bis 50.000 Abonnenten besonders stark bei Tutorials zur lokalen Ausführung von Stable Diffusion, FLUX und Qwen. https://www.youtube.com/@SECourses
- Offizieller Kanal von Google DeepMind — veröffentlicht offizielle Demovideos etwa zu Nano Banana Pro (Gemini 3 Pro Image).
- Weitere kleinere und mittlere „AI Search“- und Tool-Review-Kanäle produzieren zahlreiche News zu beiden Lagern. Einige Kanalnamen ließen sich anhand der Videotitel nicht eindeutig bestimmen; siehe Grenzen.
Videos
Geschlossene Modelle
- „Google Flow NEW Update Just Changed AI Video and Image Creation Quick Review – AI News 2026“ — Kanal unbekannt (KI-News-Kanal) / 28. Februar 2026 / https://www.youtube.com/watch?v=SnRd9nn_644 — Review zum Update von Googles Flow, dem integrierten Veo-Werkzeug für Bild- und Videoproduktion.
- „Nano Banana Pro: Hands-on with the World's Most Powerful Image Model“ — 25. November 2025 / https://www.youtube.com/watch?v=hk6gwiZmSWA — Hands-on zu Geminis Nano Banana Pro (Gemini 3 Pro Image); besonders stark bei Textrendering und Infografiken.
- „Nano Banana 2 Is Incredible! (Gemini's New AI Image Model)“ — 26. Februar 2026 / https://www.youtube.com/watch?v=_oiBHvwTtGs — Vorstellung von Nano Banana 2, verfügbar über Higgsfield.
- „Gemini's New Image Model is a Game-Changer! Here's Nano Banana!“ — 26. August 2025 / https://www.youtube.com/watch?v=wXYQEaWM-rw — Erklärung der Wirkung von Nano Banana (Gemini 2.5 Flash Image) bei seiner Einführung.
- „Grok's New FREE AI Video Generator Is INSANE“ & „Grok Imagine Video 1.5 vs Seedance 2.0 | Full AI Video Test“ — Juni bis Juli 2026 / https://www.youtube.com/watch?v=lrCjbL51dbk , https://www.youtube.com/watch?v=5mFkZiRTVu4 — ausführlicher Vergleich zwischen xAIs Grok Imagine 1.5 und Seedance 2.0.
- Vergleichsvideos mehrerer Kanäle — Inhalte zu Veo 3.1 vs. Sora 2 sowie Seedance 2.0 vs. Kling 3.0 vs. Runway Gen-4.5 nehmen stark zu. Veo 3.1 steht für 4K und natives Audio, Sora 2 für realistische Physik.
- Erklärvideos zur Adobe-Firefly-Videogenerierung — erste Jahreshälfte bis Juli 2026 / Adobe führte einen „agentischen KI-Assistenten“ ein und wurde zu einer Multi-Modell-Umgebung mit Kling 3.0, Ray3.14, Runway Gen-4.5, Sora 2, Veo 3.1 und weiteren Modellen.
⚠️ Überraschende Meldung: OpenAIs Sora wird eingestellt. Entwickler wurden am 24. März 2026 informiert, die App und Webversion endeten am 26. April, und die Sora-2-API endet am 24. September 2026 vollständig — zehn Tage nach Veröffentlichung dieses Berichts. Angeblich standen Betriebskosten von einer Million Dollar pro Tag nur 2,2 Millionen Dollar Gesamtumsatz gegenüber. Ressourcen sollen in Coding- und Enterprise-Angebote verschoben werden. Das ist eine sehr große Nachricht.
Open Source
- „Qwen-Image-Edit-2511 is now open source“ — 4. Januar 2026 / https://www.youtube.com/watch?v=UWy9Y1Ebjr4 — die aktuelle Version von Alibabas Qwen-Image-Edit wird Open Source.
- „Qwen Image Edit Review — Free Open-Source Alternative to Nano Banana“ — https://www.youtube.com/watch?v=Ur3udfFJ2QQ — wird als kostenlose OSS-Alternative zu Nano Banana vorgestellt.
- „Qwen Image-2512 First Test – The BEST Open Source Image Model!“ — 31. Dezember 2025 / https://www.youtube.com/watch?v=SBaK616nP6Q
- „Run Qwen Image Edit (2509) LOCALLY“ — 1. Oktober 2025 / https://www.youtube.com/watch?v=ET1g_3Z_c0k — Tutorial zur lokalen Ausführung.
- „Tencent's Hunyuan Image to Video AI Avatar: FREE & Open-source!“ — https://www.youtube.com/watch?v=n4M3c81F1Jk — Tencents OSS-Modell kann aus einem Foto und Audio ein Avatarvideo erzeugen.
- „Image 2 Video Open Source Breakthroughs! Hunyuan and LTX .9.5“ — https://www.youtube.com/watch?v=HIFyz0BQfck
- „Wan 22 FLUX and Qwen Image Upgraded Ultimate Tutorial for Open Source SOTA Image and Video Gen Models“ (im Umfeld von SECourses) — https://www.youtube.com/watch?v=3BFDcO2Ysu4 — Tutorial zu Updates bei Wan2.2, FLUX, FLUX Krea und Qwen Image.
- „LTX-2 Explained & Showcased: The Open-Source AI Video Model“ — https://www.youtube.com/watch?v=qdIcpORz1Mw
- „The "Holy Grail" of Open Source AI Video is Here (LTX-2)“ — https://www.youtube.com/watch?v=27UAb_Tlv4E — Lightricks’ LTX-2 wird mit nativem 4K, 50 fps und Audiosynchronisierung als „Heiliger Gral“ des Open-Source-Videos bezeichnet.
- „LTX-2 Released opensource!“ — https://www.youtube.com/watch?v=wXv4qhS4Oc0
- „Open Source AI Video BOMBSHELL From LTX & Minimax 2.3 Preview!“ — https://www.youtube.com/watch?v=N0XpMe94ENU
- „NVIDIA'S $5,000 GPU?! + LTX-2 Open Source Video AI is HERE!“ — https://www.youtube.com/watch?v=XXRZOCz0Tzs — NVIDIA bewirbt LTX-2 auch mit ComfyUI-Optimierung.
Informationen zu Wan 3.0: Alibaba veröffentlichte am 6. August 2026 eine öffentliche Beta von Wan 3.0 mit 30 Sekunden, 1080p, gleichzeitiger Audiogenerierung und Dokumenteingabe. Der Schwerpunkt liegt bisher jedoch auf Runway oder API-Zugang. Anders als bei den vollständig offenen Apache-2.0-Gewichten bis Wan 2.2 muss noch geprüft werden, ob die Gewichte veröffentlicht werden. Mehrere YouTube-Videos diskutieren, ob es Open Source wird.
Signale
- 😱 Im geschlossenen Lager läuft ein Spiel um die verbleibenden Plätze: Mit Soras faktischem Ausscheiden — App im April beendet, API Ende September — konzentriert sich der Markt rasch auf Veo 3.1, Seedance 2.0/2.5, Kling 3.0 und Runway Gen-4.5. YouTube-Vergleiche drehen sich fast ausschließlich um diese vier.
- 🍌 Googles Nano-Banana-Reihe wird zum Meme und De-facto-Standard für Bildgenerierung. Nano Banana, Nano Banana Pro und Nano Banana 2 erscheinen in schneller Folge; „X vs Nano Banana“ wird in Videotiteln selbst zum Referenzpunkt.
- 🇨🇳 Chinesische Anbieter führen Open Source klar an: Alibaba mit Qwen-Image und Wan sowie Tencent mit Hunyuan sind die prominentesten Beispiele. Praxisnahe Kanäle wie SECourses produzieren zahlreiche Anleitungen zur lokalen Ausführung.
- 🎬 LTX-2 von Lightricks wird als führendes Open-Source-Videomodell gehandelt: Offene Verfügbarkeit von nativem 4K, 50 fps und Audiosynchronisierung auf kommerziellem Niveau sorgte für große Aufmerksamkeit. Mehrere Kanäle verwenden Zuspitzungen wie „Holy Grail“ und „BOMBSHELL“.
- 🎧 Gleichzeitige Audiogenerierung ist der gemeinsame Trend beider Lager: Seedance 2.5, Veo 3.1, Wan 3.0 und LTX-2 werben alle mit einer Ein-Pass-Generierung von Bild und Ton. Die reine Videogenerierung verliert an Bedeutung.
- 💰 Die Geschäftsmodelle entwickeln sich deutlich unterschiedlich: Die Einstellung von Sora steht für wirtschaftlichen Druck auf geschlossene Angebote. Adobe richtet sich mit dem Versprechen kommerzieller Sicherheit stärker an Unternehmen. Bei Open Source sorgen Apache-2.0-Lizenzen für anhaltende Community- und Anpassungsaktivität.
- 🖌️ Bildbearbeitung ist gefragter als reine Neuerzeugung: Qwen-Image-Edit, Nano Banana Pro und ähnliche Werkzeuge zeigen einen klaren Trend von „bei null anfangen“ hin zu natürlicher, sprachgesteuerter Bildbearbeitung.
Grenzen
- Die YouTube-Suchergebnisse und Watch-Seiten werden per JavaScript gerendert. Beim direkten Abruf fehlten tatsächliche Videolisten, Aufrufzahlen, Abonnentenzahlen und Kommentare im HTML; sichtbar waren vor allem Footer-Navigationslinks. Titel, Kanäle und Daten wurden deshalb über Websuche mit
site:youtube.comgesammelt, und Aufrufzahlen konnten für fast alle Videos nicht bestätigt werden. - Bei einigen Videos ließ sich der Kanalname anhand von Such-Snippets nicht ermitteln; sie werden oben als „Kanal unbekannt“ geführt.
- Ob Wan 3.0 vollständig mit offenen Gewichten veröffentlicht wird und damit die Apache-2.0-Linie von Wan 2.2 fortsetzt, ließ sich aus YouTube-Informationen nicht verbindlich ableiten.
- Gegenüber dem Ziel von etwa 20 analysierten Beiträgen wurden ungefähr 19 YouTube-Videos und Themen über beide Lager hinweg gefunden. Wegen technischer Beschränkungen konnten einzelne Videoseiten jedoch nicht einschließlich Beschreibung und Top-Kommentaren gelesen werden.
Bluesky
Bluesky — Aktuelle Neuigkeiten zu KI für Bild- und Videogenerierung
Accounts
- @huggingfacetrends.bsky.social (tägliche Hugging-Face-Trends) — ein Bot, der täglich fünf trendende Hugging-Face-Repositories postet. Er war der nützlichste Account, um offene neue Modelle zu verfolgen. https://bsky.app/profile/huggingfacetrends.bsky.social
- @stabilityai.bsky.social — offizieller Account von Stability AI. Veröffentlicht vor allem Pressemitteilungen zu Stable Audio, Bedrock-Integrationen und Partnerschaften mit Labels. https://bsky.app/profile/stabilityai.bsky.social
- @midjourneyofficial.bsky.social — offizieller Midjourney-Account, der den Start auf Bluesky im August 2025 ankündigte. Geringe Posting-Frequenz. https://bsky.app/profile/midjourneyofficial.bsky.social
- @civitai-bot.bsky.social — Bot für LoRA- und Checkpoint-Updates bei Civitai. Die Updates endeten offenbar im Mai 2024. https://bsky.app/profile/civitai-bot.bsky.social
- Creator, die sich als „Creator Partner“ (CCP/CPP) bezeichnen, etwa @curieuxexplorer.bsky.social — zahlreiche Personen posten Werke unter Titeln wie offizielle Botschafter von Runway, Kling AI, Luma, Pika, Hailuo, Vidu oder Freepik. Im Zentrum stehen Beispiele und Werbung, nicht Nachrichten. https://bsky.app/profile/curieuxexplorer.bsky.social
- Accounts mit Namen wichtiger Unternehmen wie @blackforestlabs.bsky.social, @runwayml.bsky.social und @klingai.bsky.social existieren, doch ihre Feeds sind leer oder gehören offenbar nicht den jeweiligen Unternehmen. Relevante Kommunikation gab es dort nicht.
Posts
- Lightricks/LTX-2.5, ein offenes Videogenerierungsmodell, bleibt auf Platz eins der Hugging-Face-Trends — Vom 07.09. bis 13.09.2026 erschien es mindestens fünf Tage hintereinander in Trendposts. Die README-Zusammenfassung wird zwar als fehlgeschlagen angezeigt, es handelt sich aber um die offene Videomodell-Familie von Lightricks. 13.09., 0 Likes / 0 Reposts. https://bsky.app/profile/huggingfacetrends.bsky.social/post/3mvfrl5gc5z2l
- Qwen/Qwen3.8-27B, ein offenes Vision-Language-Modell mit Bild- und Videoverständnis, trendet wiederholt — Posts am 06.09., 08.09., 10.09. und 12.09.; beschrieben als stark bei Coding, Forschung und mehrstufigen Aufgaben. Am 12.09.: 0 Likes / 0 Reposts. https://bsky.app/profile/huggingfacetrends.bsky.social/post/3mvd6mv6ac72l
- deepseek-ai/DeepSeek-V4.1-Flash, ein multimodales MoE-Modell mit Bildunterstützung — Posts am 10.09. und 12.09.; vorgestellt mit bis zu einer Million Token Kontext und FP4-Cache-Kompression. Am 12.09.: 0 Likes / 0 Reposts. https://bsky.app/profile/huggingfacetrends.bsky.social/post/3mvd6csnao42h
- deepseek-ai/DeepSeek-V4-Flash-Vision-Exp, ein experimentelles Modell mit zusätzlichen Sehfähigkeiten — Post am 07.09.; erhält Textleistung und ergänzt Bildverständnis sowie multimodale Agentenfunktionen. 0 Likes / 0 Reposts. https://bsky.app/profile/huggingfacetrends.bsky.social/post/3muwta6mwoi2g
- zai-org/GLM-5.3-Flash, das erste nativ multimodale Modell der GLM-5-Reihe — Post am 06.09.; mit 320B Gesamtparametern und 18B effektiven Parametern, leistungsstärker und kostengünstiger als GLM-5.2. https://bsky.app/profile/huggingfacetrends.bsky.social/post/3muu3pjpou62n
- Stability AI stellt Image Services auf Amazon Bedrock bereit — unternehmensorientierte Expansion im geschlossenen Segment: professionelle Bildbearbeitungsfunktionen auf Bedrock. 18.09.2025, 0 Likes / 0 Reposts. https://bsky.app/profile/stabilityai.bsky.social/post/3lz5eotkuvk2i
- Stability AI kooperiert mit Universal Music Group und Warner Music Group — keine reine Bild- oder Videonachricht, sondern eine Partnerschaft großer Labels mit generativer KI und damit ein Signal für die Geschäftsstrategie eines bedeutenden geschlossenen Anbieters. 30.10.2025 / 19.11.2025, 1 Like / 0 Reposts. https://bsky.app/profile/stabilityai.bsky.social/post/3m4fwolv4k22z
- Midjourney kündigt Style Explorer an — eine Funktion, mit der sich Stile ähnlich wie auf Explore-Seiten für Video und Bild entdecken lassen. 18.09.2025, 10 Likes / 2 Reposts. https://bsky.app/profile/midjourneyofficial.bsky.social/post/3lz5cskktzk2c
- Midjourney kündigt seinen Start auf Bluesky an — „Wir sind auf Bluesky, nennt uns eure empfohlenen Creator“; erster Post des Accounts. 15.08.2025, 41 Likes / 4 Reposts, die stärkste Reaktion auf diesem Account. https://bsky.app/profile/midjourneyofficial.bsky.social/post/3lwi222j4sk2b
- Die letzten Posts des Civitai-Bots vom Mai 2024 — fortlaufende Hinweise auf individuelle LoRAs und Merge-Modelle auf Basis von SD1.5 und Pony, meist mit 0–3 Likes. Ein Zeugnis der Graswurzelkultur offener Modelle, aber im letzten Jahr ohne Aktivität. https://bsky.app/profile/civitai-bot.bsky.social/post/3ks2nnatkqi24
Signale
- Auf Bluesky stammen News-artige Beiträge zur Bild- und Videogenerierung faktisch nur von botähnlichen Accounts wie huggingfacetrends und civitai-bot sowie offiziellen PR-Accounts wie Stability AI und Midjourney. Live-Berichte oder lebhafte Diskussionsthreads wie auf X oder Reddit waren nicht sichtbar.
- Im Zentrum stehen offene Modelle, die Inhalte verstehen — Vision-Language- und multimodale Modelle — darunter Qwen3.8-27B, DeepSeek-V4-Familie und GLM-5.3-Flash. Diese chinesischen Open-Weight-Modelle besetzten täglich obere Hugging-Face-Trendplätze. Als reines offenes Modell zur Bild- oder Videogenerierung trendete insbesondere Lightricks/LTX-2.5 kontinuierlich.
- Geschlossene Anbieter wie Stability AI und Midjourney posteten vor allem Unternehmenspartnerschaften und kleinere Funktionen. Große neue Modellankündigungen waren in diesem Zeitraum nicht sichtbar.
- Sehr viele Einzelaccounts mit Bezeichnungen wie „Creator/Community Partner“ für Midjourney, Runway, Kling AI, Luma und andere dienen als Hubs für Werkbeispiele und Verbreitung. Es handelt sich jedoch um Präsentationen statt um Nachrichten, häufig auch um ältere Inhalte.
- Mehrere leere oder ähnlich benannte Accounts, die sich als offizielle Unternehmenshandles ausgeben könnten — etwa runwayml.bsky.social, klingai.bsky.social und real-comfyui.bsky.social — erfordern Vorsicht: Sie könnten nicht autorisiert sein oder frühzeitig registrierte Handles darstellen.
Grenzen
- Bluesky ist eine clientseitig gerenderte SPA. Beim direkten Abruf von Such- und Postseiten waren Text, Likes und Datum nicht verfügbar, weil WebFetch kein JavaScript ausführt.
- Die öffentliche API
public.api.bsky.app/xrpc/app.bsky.feed.searchPostsfür Volltextsuchen lieferte durchgehend403 Forbiddenund war nicht nutzbar.getProfile,getAuthorFeedundsearchActorsauf derselben Domain funktionierten hingegen; offenbar war nur der Suchendpunkt gesperrt. - Eingebettete Spiegel wie fxbsky.app leiteten bei normalen Anfragen auf bsky.app weiter, sodass Inhalte nicht abrufbar waren.
- Daher wurde auf eine Umgehungsroute ausgewichen: Akteurssuche und anschließend
getAuthorFeedfür aussichtsreiche Accounts. Zwar wurden mehr als 20 Accounts und Posts geprüft, die Grundgesamtheit ist aber auf Beiträge gefundener Accounts verzerrt. Plattformweite Gesprächsvolumina oder virale Posts lassen sich nicht beurteilen. - Offizielle wirkende Accounts von Runway, Black Forest Labs, Kling AI und ComfyUI wurden gefunden, hatten aber keine relevanten Posts. Primärquellen dieser Unternehmen auf Bluesky gab es in dieser Sammlung folglich nicht.
Lemmy
Lemmy — KI für Bild- und Videogenerierung ist auf Lemmy kein großes Ereignis
Communities
- !«メールアドレス» (über lemmy.world einsehbar) — 5,71 Tsd. Abonnenten, davon 1,23 Tsd. lokal auf lemmy.world. Selbstbeschreibung: „Discuss matters related to our favourite AI Art generation technology“. https://lemmy.world/c/«メールアドレス»
- !«メールアドレス» (über lemmy.world einsehbar) — 8,53 Tsd. Abonnenten, davon 2,34 Tsd. lokal. https://lemmy.world/c/«メールアドレス»
- !«メールアドレス» — beim Zugriff HTTP-500-Fehler, daher nicht prüfbar; siehe Grenzen. https://lemmy.world/c/ai_art
- !«メールアドレス» — 88.016 Abonnenten. Nicht auf Bild- oder Videogenerierung spezialisiert, aber gelegentlich erscheinen dort Nachrichtenlinks.
- !«メールアドレス» — 8.208 Abonnenten. Community für Personen, die KI-Hype und insbesondere kommerziell vermarktete LLM-/GPT-Technologie ablehnen. Auch Gegenreaktionen auf Bild- und Videogenerierung fließen hier ein.
- !«メールアドレス» — 41.395 Abonnenten. Nicht auf generative KI spezialisiert, aber gelegentlich Schauplatz von Meinungs-Threads.
Posts
- Der Feed von !«メールアドレス» ist ein Bot-Spiegel mit praktisch keiner menschlichen Konversation — Sowohl nach Neuheit als auch nach Top des Monats bestehen die jüngsten 20 Posts aus automatischen Übernahmen von Modell- und Werkzeug-Releases auf GitHub oder Hugging Face. Kommentare liegen durchgehend bei null, Scores meist bei 1–10. Beispiele:
Lightricks/LTX-2.5-22b-IC-LoRA-Ingredients(2026-09-12, Score 3, 0 Kommentare, https://huggingface.co/Lightricks/LTX-2.5-22b-IC-LoRA-Ingredients),lightx2v/Minimax-h3-Turbo - 8 step 768p V1.0 LoRA released(2026-08-27, Score 6, 0 Kommentare, https://huggingface.co/lightx2v/Minimax-h3-Turbo) undViggle/Viggle-Animate(2026-09-05, Score 10, 0 Kommentare, https://huggingface.co/Viggle/Viggle-Animate). LoRAs und Adapter der MiniMax-H3-Familie sowie ComfyUI-Erweiterungen wieComfyUI-VDN-H3-24GB,ComfyUI-InpaintCanvasundComfyUI-Tab-Sticky-Extentionerscheinen laufend. Die Open-Source-Entwicklung ist also aktiv, die Community funktioniert jedoch nicht als Diskussionsort. - „Did you know?“ («メールアドレス», !«メールアドレス», Ende August 2026 beziehungsweise 19 Tage vor der Erfassung) — Score 39, in der föderierten Anzeige 55 Upvotes / 16 Downvotes, drei Kommentare. Zu einem generierten „Fun Fact“-Bild lauten die Reaktionen eher spöttisch: „Have you know?“ sei grammatikalisch falsch, und „Artificial Intelligence meets Natural Stupidity“. Der einzige konstruktive Kommentar empfiehlt KI eher für Ideensuche als für die Endfassung. https://lemmy.world/post/51117779
- „What's your overall opinion on generative AI?“ (LeftReddit2, !«メールアドレス», zehn Tage vor der Erfassung) — 54 Upvotes / 9 Downvotes, 49 Kommentare und damit der lebhafteste Beitrag der Untersuchung. Der Autor schreibt, anfangs von ChatGPT und DALL-E begeistert gewesen zu sein, seit 2024 jedoch skeptisch zu sein. Die stärksten Kommentare waren überwiegend negativ: Kritik an Training ohne Zustimmung, der Ausdruck „KI-Psychose“ und Berichte darüber, dass Schreibende ihre Arbeit verlieren. https://lemmy.world/post/51505799
- „Gen Z's AI backlash is getting louder“ («メールアドレス», World News, vier Monate vor der Erfassung) — 125 Upvotes / 1 Downvote, fünf Kommentare. Ein geteilter Artikel über Gegenreaktionen jüngerer Generationen auf generative KI. Die Kommentare wenden sich Sarkasmus gegenüber KI-Rechenzentren und Klassenkonflikten wie „die Welt gegen das eine Prozent“ zu. https://lemmy.world/post/47211056
- „Found a 3 year old SD install on my computer, so here is some vintage Dreamshaper 7“ («メールアドレス», !«メールアドレス», zwei Monate vor der Erfassung) — Score 6, keine Kommentare. Ein nostalgischer Beitrag, der die stille fortgesetzte Nutzung älterer Open-Source-Stable-Diffusion-Installationen zeigt. https://lemmy.world/post/48977635
- „Modern Tram - generated by Lumo (the proton ai)“ («メールアドレス», !«メールアドレス», einen Monat vor der Erfassung) — Score 0, sechs Kommentare. Bild mit Protons Lumo-KI generiert. Das Werk selbst löste wenig Reaktion aus, in den Kommentaren wurde jedoch über die Wahl von KI-Diensten und Datenschutz bei Proton diskutiert. https://lemmy.world/post/50175271
- „It's like an album cover...“ («メールアドレス», !«メールアドレス», einen Monat vor der Erfassung) — Score -8, ein Kommentar. Einer der wenigen Beiträge mit negativem Score und damit ein Symbol für die kühle Reaktion auf generative KI-Kunst. https://lemmy.world/post/50411980
- Direkte Suchen nach Namen kommerzieller Modelle wie Sora, Veo, Midjourney oder Grok Imagine ergaben auf lemmy.world keine aktuellen eigenständigen Beiträge — Gefunden wurden nur ältere Sora-Posts aus 2023–2024, etwa geteilte OpenAI-kritische Artikel und https://lemmy.world/post/44721138, oder irrelevante Treffer wie eine Menschenrechtskampagne mit dem Hashtag „#BringSoraHome“. Aktuelle Modellnamen wie Sora 2, Veo 3, Nano Banana, Flux.2, Qwen Image, Wan 2.5 und Seedream wurden im Suchbereich nicht gefunden.
Signale
- Lemmys Communities zur Bildgenerierung teilen sich in „Entwicklungsfeed“ und „Ausdruck anti-KI-orientierter Stimmung“. !«メールアドレス» besteht überwiegend aus automatisierten Hinweisen auf neue Hugging-Face- und GitHub-Modelle, LoRAs und ComfyUI-Nodes, praktisch ohne Kommentare.
- In !«メールアドレス», !«メールアドレス» und Nachrichten-Communities dominieren dagegen negative Sichtweisen auf generative KI allgemein, einschließlich Bild und Video. Die Diskussion konzentriert sich auf Training ohne Zustimmung, Umweltkosten und „Slop“, also niedrigwertige KI-Inhalte.
- Wichtige Meme-Communities wie !«メールアドレス», !«メールアドレス» und !«メールアドレス» verbieten KI-generierte Inhalte ausdrücklich in ihren Regeln. Die Kultur auf Lemmy zeigt insgesamt eine starke Ablehnung generativer Inhalte.
- Aktuelle Einzelmeldungen zu geschlossenen Modellen wie Sora 2, Veo 3, neuesten Midjourney-Versionen oder Grok Imagine waren im untersuchten Bereich nicht sichtbar. Gesellschaftliche und ethische Reaktionen auf KI-Inhalte erhalten offenbar mehr Aufmerksamkeit als kommerzielle Modell-Releases.
- Die Entwicklung auf der offenen Seite, etwa bei MiniMax-H3, LTX und ComfyUI-Erweiterungen, ist aktiv. Sie erscheint jedoch als Aktualisierungsfeed für Werkzeugentwickler, nicht als breites Thema für allgemeine Nutzer.
Grenzen
- Lemmy ist vergleichsweise klein; eine aktive Community speziell für Bild- und Videogenerierung wurde nicht gefunden. Es existierten nicht genügend hochwertige eigenständige Beiträge, ohne automatische Übernahmen und Posts mit null Kommentaren, um das Ziel von etwa 20 Beiträgen zu erfüllen.
- !«メールアドレス» lieferte beim Abruf einen HTTP-500-Fehler und konnte nicht geprüft werden.
- Direkte Suchanfragen auf lemm.ee und lemmy.ml über die APIs mit
q=image generation AIodervideo generation AIergaben überwiegend irrelevante Resultate wie politische Artikel oder Spielrezensionen. Die Relevanzsortierung der Lemmy-Such-API erwies sich damit als schwach. Die Beitragzahl wurde nicht künstlich aufgebläht; genannt werden nur tatsächlich geprüfte Posts. - Direkte Erwähnungen aktueller 2026er-Modelle wie Sora 2, Veo 3, Nano Banana, Flux.2, Qwen Image, Wan 2.5 und Seedream wurden auf Lemmy nicht gefunden, weder über Suchmaschinen noch über APIs. Dieses Ergebnis wird selbst als Hinweis darauf festgehalten, dass diese Modelle dort nicht im Gespräch sind.
Pinterest — Neuigkeiten zu KI für Bild- und Videogenerierung
Insgesamt wurden 50 Pins gesammelt. Sie waren nicht nach Genres gruppiert, sondern alle in einer einzigen Gruppe (g01) zusammengefasst; daher werden sie gemeinsam betrachtet 📌
Visuelle Themen 🎨
- Thumbnails im Stil „schreiendes Gesicht + große Schrift AI NEWS + viele Firmenlogos“ sind äußerst häufig: Das OpenAI-Wirbellogo, Googles G, Microsofts Windows-Fenster, Metas ∞, DeepSeeks Wal und Nvidia-Logos erscheinen immer wieder. Das Gesicht zeigt fast immer einen überraschten „Echt jetzt?!“-Ausdruck
[5, 17, 24, 37, 44] - Infografiken zu „den besten KI-Videotools“ werden in unterschiedlichen Farben massenhaft wiederholt: Die Folge Runway, Pika, Kling AI, Luma Dream Machine, Canva AI und Hailuo AI taucht nahezu kopiert mehrfach auf. CapCut, Synthesia, HeyGen und Descript werden oft als Bearbeitungs- oder Avatarwerkzeuge ergänzt
[9, 10, 21, 29, 47] - Neonblaue bis violette Roboter- und Cyborg-Gesichter aus Stockbildern dienen in großer Zahl als Blickfang: Sie werden als beliebige „KI-artige“ Illustration wiederverwendet und haben oft keinen direkten Bezug zur Nachricht
[2, 36, 42, 49, 50, 45] - Visuals zur Sorge „Vielleicht ist das KI?“: Fake-Stempel, Balken mit 97-%-Fake-Erkennung sowie Gegenüberstellungen von „Human Journalism“ und „Machine-Generated Media“ bilden Angst vor Fälschungen und Verlässlichkeit visuell ab
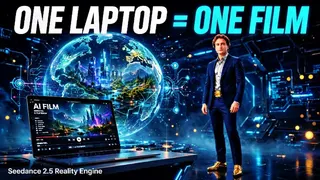
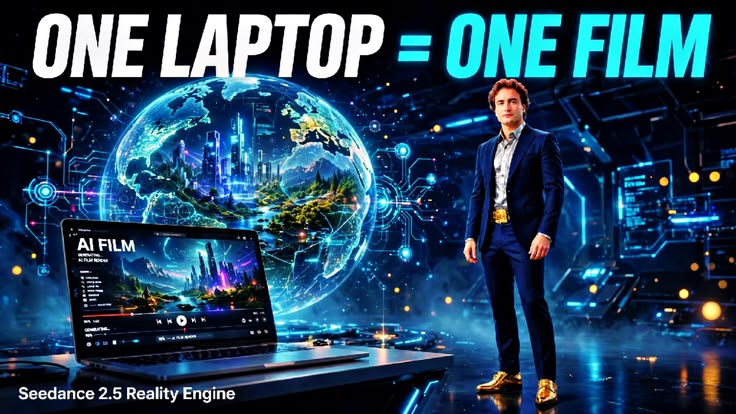
[4, 11, 40] - Offizielle, filmische Werbestills großer geschlossener Anbieter aus Google, ByteDance und ShengShu wirken besonders einheitlich: Veo 2/3 zeigt realistisch wirkende Vorführungen wie schwimmende Hunde oder Flamingos, Seedance 2.5 wirbt mit einem Mann im goldenen Anzug für einen ganzen Film aus einer Person, und Vidu S1 setzt auf ein Cyberpunk-Anime-Mädchen
[3, 6, 8, 13, 33, 48] - Einige technisch gehaltvollere Erklärgrafiken sind ebenfalls vertreten: Diagramme zu Diffusions-Pipelines wie Text Embedding → 64x64 → 1024x1024 und Zeitachsen von ELIZA in den 1950ern bis GPT in den 2020ern gehören zu den wenigen substanziellen Infografiken
[31, 43] - Auch Zeitung- und Magazin-Mockups für News-Zusammenfassungen tauchen mehrfach auf: Fiktive Titel wie „THE AI DISPATCH“ und „Today's AI News“ reihen Begriffe wie Open Models, Sovereign AI und AI Agents aneinander
[32, 39]
Bemerkenswerte Pins 📌
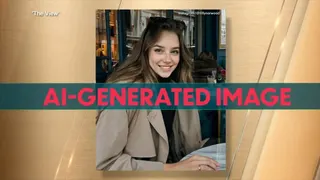
[1]Hollywood Reporter Interviews the First AI Actress… — Screenshot aus der TV-Sendung „The View“: Über einem KI-generierten Instagram-Bild von „@tillynorwood“ liegt ein rotes Banner „AI-GENERATED IMAGE“. Die Kontroverse um die KI-Schauspielerin Tilly Norwood ist damit sichtbar im Mainstream-Fernsehen angekommen.[28]ByteDance and Hollywood reach global deal on AI copyright — Screenshot eines Nachrichtenartikels über eine Vereinbarung zwischen ByteDance und der Motion Picture Association (MPA) zum Urheberrechtsschutz für KI-Werkzeuge zur Bild- und Videogenerierung. Er zeigt die sich verändernden Machtverhältnisse zwischen großen geschlossenen Anbietern und der etablierten Medienbranche.[48]🐉 China Just Took AI Video Too Far|ByteDance Seedance 2.5 — Mit der Botschaft „ONE LAPTOP = ONE FILM“ wird ByteDance Seedance 2.5 mit einer aufwendigen Männerdarstellung beworben. Ein Titel, der die Dynamik chinesischer geschlossener Modelle zuspitzt.[33]Vidu S1 — The World's Most Advanced Model for Real-Time AI Interaction — Echtzeit-KI-Modell von ShengShu Technology aus China. Die Cyberpunk-Illustration eines Anime-Mädchens scheint auf Charakterkonsistenz ausgerichtet zu sein.[13]Veo 3 Image-to-Video: Fast Generation & Native Audio via Gemini API — Ankündigungs-Pin, dass Googles Veo 3 über die Gemini-API Bild-zu-Video und natives Audio unterstützt.[31]OpenAI's Secret Image Generation Tool to Debut Soon — Gerüchte-Pin über ein nicht angekündigtes Bildgenerierungswerkzeug von OpenAI. Inhaltlich dünn, aber er zeigt die Erwartungshaltung.[6]Demos für Transformationen in „Holzblöcke“, „Origami“, „Lego“ und „Blumen“ — Raster aus Demos, die dasselbe Personen- oder Fahrzeugvideo in verschiedene Materialien und Stile verwandeln. Es ist das aufwendigste Beispiel für eine Showcase-Technik zur KI-Videostiltransformation.[40]AI IS CHANGING EVERYTHING — Infografik mit einem Audio-Erkennungswerkzeug, das „97% LIKELY AI GENERATED“ anzeigt. Sie visualisiert das Wettrennen zwischen Generierung und Erkennung.[11]New York's Bold Gambit: Inside the Legislative… — Grafik mit Freiheitsstatue und Kapitol, die „Human Journalism“ gegen „Machine-Generated Media“ stellt. Sie deutet Regulierungsbestrebungen gegenüber KI-generierten Nachrichten an.[41]Nvidia #NEW AI Tools — Bild eines Vortragenden im schwarzen Lederjackett, der Jensen Huang ähnelt. Es fällt als KI-News aus Hardware- und GPU-Perspektive auf.
Signale 📡
- Der Wettbewerb geschlossener Videomodelle steht eindeutig im Mittelpunkt: Google Veo 2/3, ByteDance Seedance 2.5 und ShengShus Vidu S1 erscheinen als eine Reihe von Modellankündigungs-Pins. Firmenlogos — insbesondere OpenAI, Google, Nvidia und DeepSeek — sind die prägenden Gesichter von KI-News-Thumbnails.
- Sorgen um die Echtheit von Inhalten sind als Thema fest etabliert: Fake-Erkennungsanzeigen, Stempel, Grafiken „Human vs Machine“ und die Tilly-Norwood-Kontroverse machen die Frage nach der Authentizität generierter Inhalte zu einem normalen Pinterest-Thema.
- Urheberrecht und Regulierung erscheinen zunehmend als Nachrichtenmotive: Die ByteDance-MPA-Vereinbarung und Gesetzgebungsbewegungen im US-Bundesstaat New York zeigen eine Verschiebung von der Frage, was erzeugbar ist, hin zu der Frage, wie es reguliert wird.
- Pinterest ist zugleich stark von SEO- und Affiliate-Inhalten zu Toollisten geprägt: Dieselben Listen aus Runway, Pika, Kling, Luma, Canva und Hailuo werden oft wiederverwendet. Die Plattform dient eher als dauerhafte Werkzeugliste denn als Quelle schneller Nachrichten.
- Open Source ist deutlich weniger sichtbar: Namen wie Stable Video Diffusion, Wan und HunyuanVideo erscheinen höchstens als einzelne Zeilen in Werkzeuglisten. Unabhängige News-Pins dazu gab es nicht. Die Diffusionsmodell-Grafik
[31]ist fast der einzige technisch orientierte offene Inhalt.
Grenzen 🚧
- Die Pinterest-Sammlung wurde vorab von einem Worker über einen Headless-Browser erstellt; Pinterest wurde in dieser Analyse nicht direkt durchsucht oder aufgerufen.
- Es gab keine Genreaufteilung. Alle 50 Pins lagen in der einzigen Gruppe g01, weshalb keine thematische Verteilung verglichen werden konnte.
- Fünf Pins hatten den Titel „(untitled)“ — etwa
[3, 12, 18, 24, 32]— sodass ihr Kontext teilweise allein aus den Bildern erschlossen wurde. Insbesondere bei[24]war nur wenig Detail lesbar. - Viele Pins sind Affiliate- oder Bloggrafiken zu „den besten Tools“. Veröffentlichungsdaten und die vollständigen Inhalte der Primärartikel hinter den Pins wurden nicht gelesen; die Einordnung basiert auf Bildtext.
- Das übergreifende Kriterium von mindestens zehn Erkenntnissen für Closed Source und Open Source soll durch die Addition der Ergebnisse von Reddit, X, YouTube, Bluesky und Lemmy erfüllt werden. Pinterest dient vor allem dazu, die derzeit verbreiteten visuellen Motive zu erfassen; es gab keine besonderen Link- oder Ladefehler.
Empfohlene Maßnahmen
- Videoproduktions-Workflows sollten als zweistufiger Prozess geprüft und verglichen werden: Charakter mit einem Bildmodell festlegen, anschließend mit Video-KI animieren.
- Für Open-Source-Video-PoCs sollten LTX-2- und Wan-Modelle priorisiert und Lizenzankündigungen zu Wan 3.0 fortlaufend beobachtet werden.
- Bei geschlossenen Videomodellen sollten Seedance 2.5, Veo 3.1, Kling 3.0 und Runway Gen-4.5 als Kernvergleich dienen; Kostenunterschiede, einschließlich des etwa dreifachen Preises von Seedance, müssen einbezogen werden.
- Bei geschlossenen Abos mit dem Versprechen „unbegrenzt“ sollten reale Generierungslimits und Wartezeiten unbedingt vor Vertragsabschluss geprüft werden.
- Interne Regeln zu rechtlichen Risiken generierter Inhalte sollten die Verantwortung bei Verteilung und Weitergabe stärker gewichten als die reine Erzeugung.
- Bei der nächsten X-Sammlung sollten die Suchbegriffe durch Begriffe zu Bild- und Videogenerierung ersetzt werden, etwa Modell- und Labornamen.
Gesammelte Bilder








Hinweis zur Datenqualität
Bei X waren die Suchbegriffe thematisch unpassend, weshalb keine Posts zu KI für Bild- und Videogenerierung gesammelt wurden. Lemmy verfügte ebenfalls nicht über genügend aktive spezialisierte Communities, um das Ziel von 20 Beiträgen zu erreichen. Reddit, Bluesky, YouTube und Pinterest lieferten überwiegend brauchbare Daten, wobei technische Erfassungsgrenzen — etwa ein 403-Fehler der Bluesky-Such-API und JavaScript-Rendering bei YouTube — zu einzelnen Lücken führten.