Ich habe Previs für die KI-Videogenerierung ausprobiert. Auch grob ist besser als nichts
Ich habe der KI-Videogenerierung eine einfache Previs übergeben, die aus Boxen und Schaufensterpuppen besteht. Eine Previs ist ein grobes Video, mit dem die Positionen und Bewegungen der Figuren sowie die Kameraführung vorab festgelegt werden.
Mein Fazit: Das lässt sich ziemlich gut nutzen. Allerdings werden Details nicht unverändert reproduziert. Vielmehr ergänzt die KI fehlende Elemente auf überzeugende Weise, wenn man ihr die grobe Inszenierung vorgibt. Als Blaupause dafür war die Previs sehr praktisch.
Vergleich von Previs und generiertem Ergebnis
In allen Videos gilt: oben ist das von der KI generierte Video, unten die ursprüngliche Previs. Jedes Video ist etwa 15 Sekunden lang. Ich teste, wie gut sich der Ablauf einer Szene vermitteln lässt, ohne Hintergründe oder Figuren aufwendig auszugestalten.
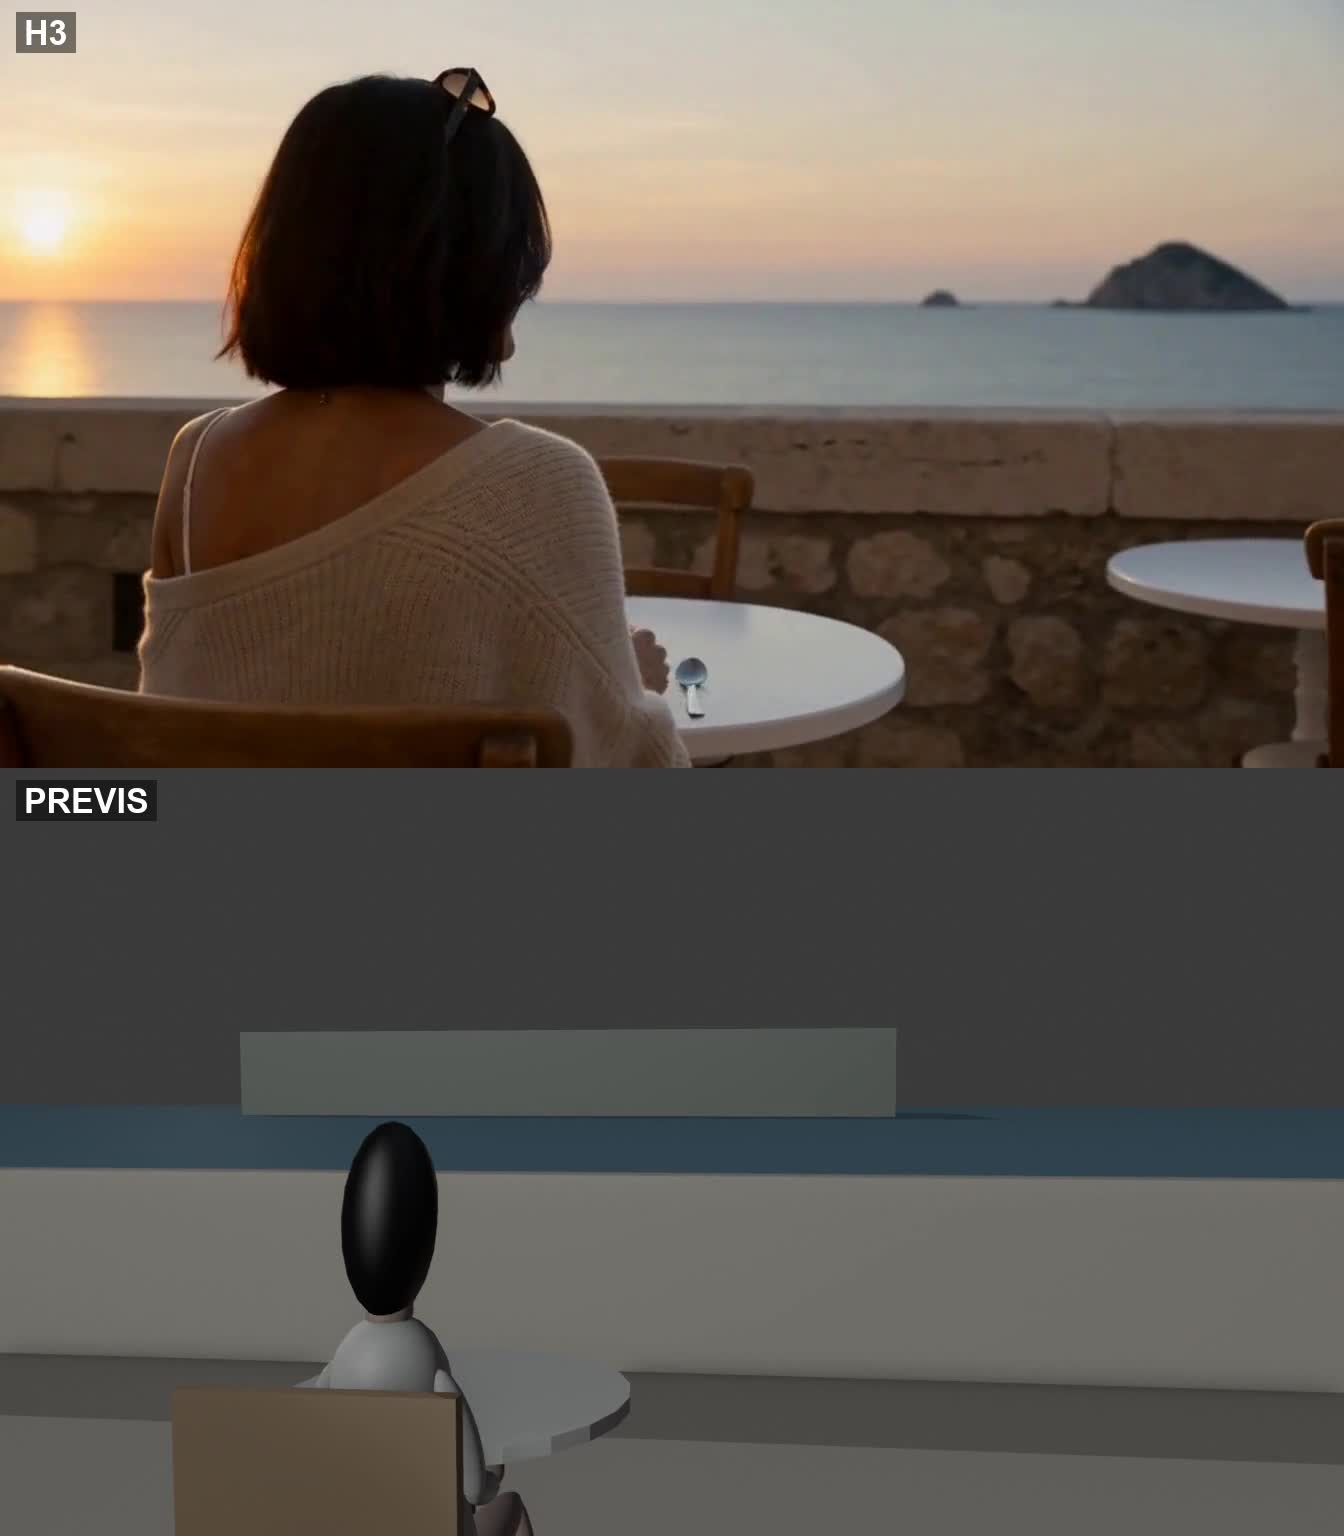
Café am Meer
Aus einer einfachen Anordnung von Tisch und Figuren wird ein Café in der Abenddämmerung. Bewegungen wie das Trinken werden in fotorealistisch wirkende Aufnahmen umgesetzt.
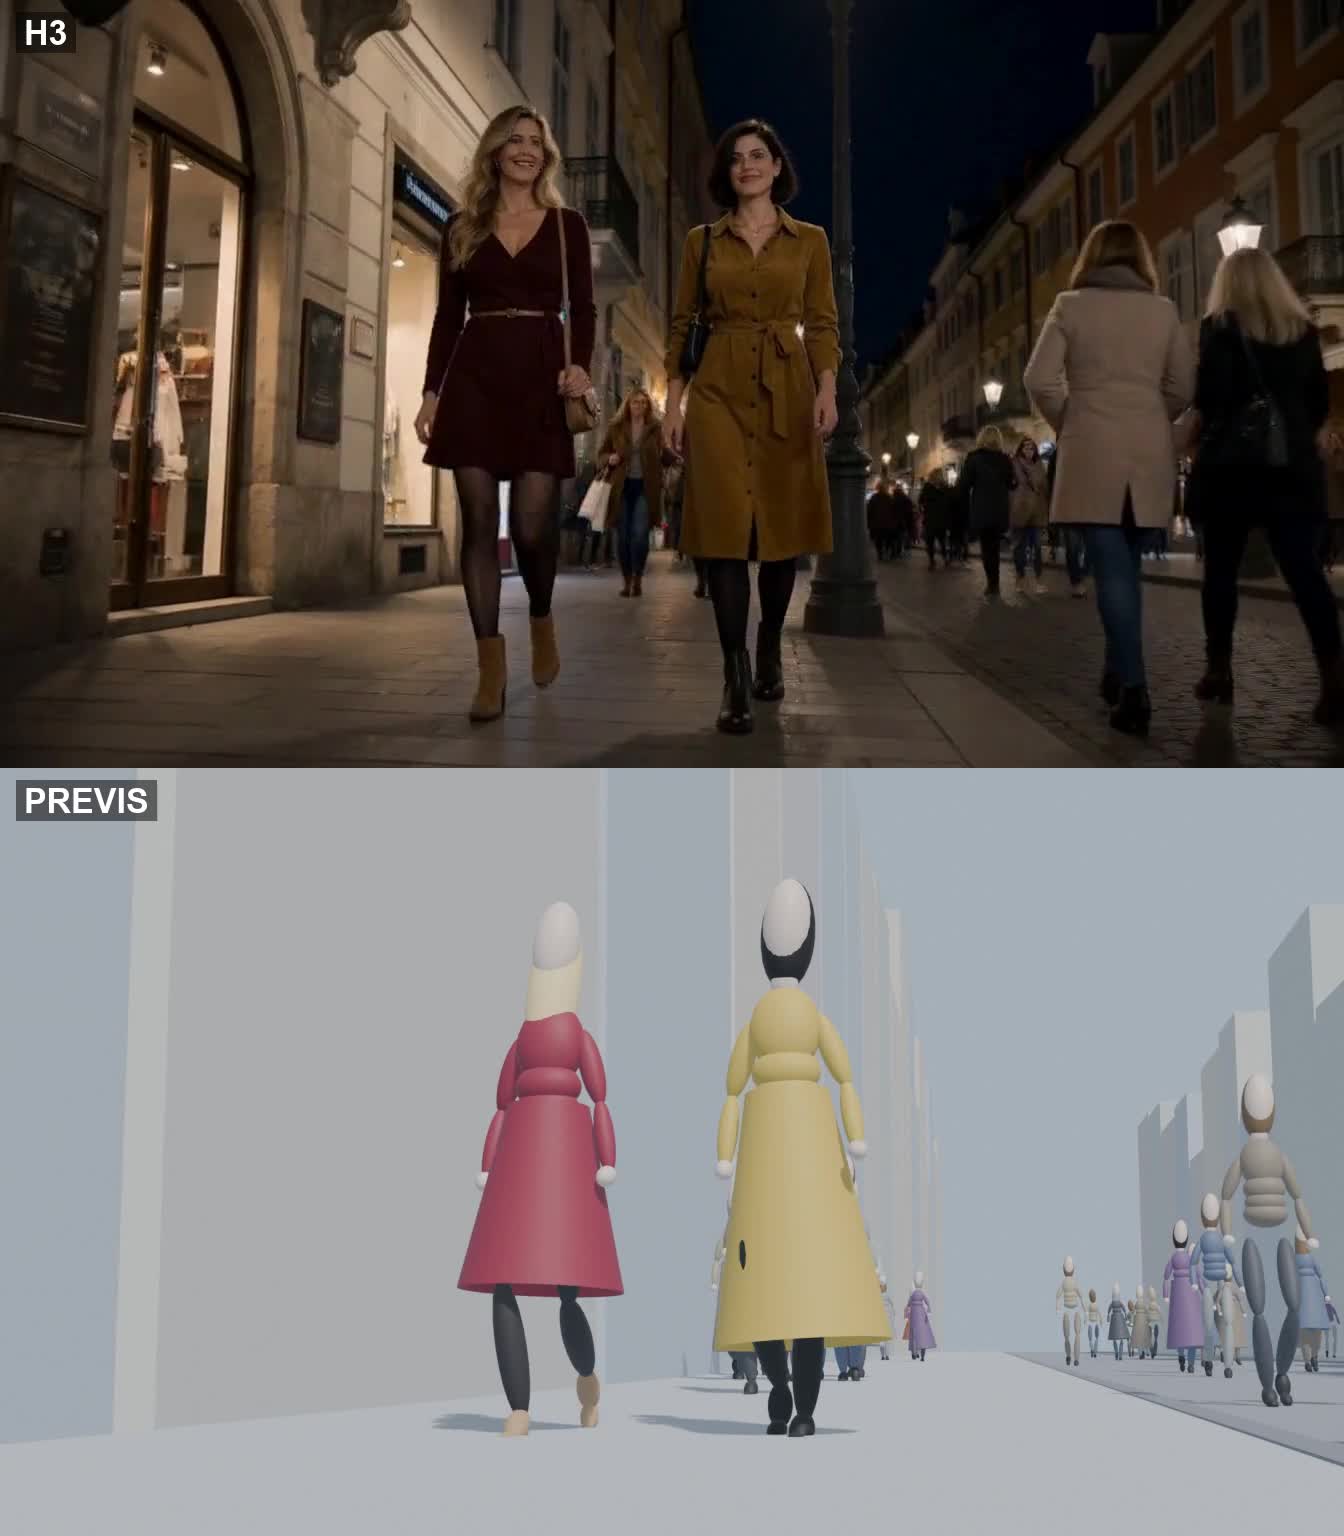
Spaziergang durch die Stadt bei Nacht
Die Positionen der Figuren und ihre Gehrichtung werden in der Previs vorgegeben. Die helle, schlicht gestaltete Stadtlandschaft wird per Prompt in eine nächtliche Stadt verwandelt.
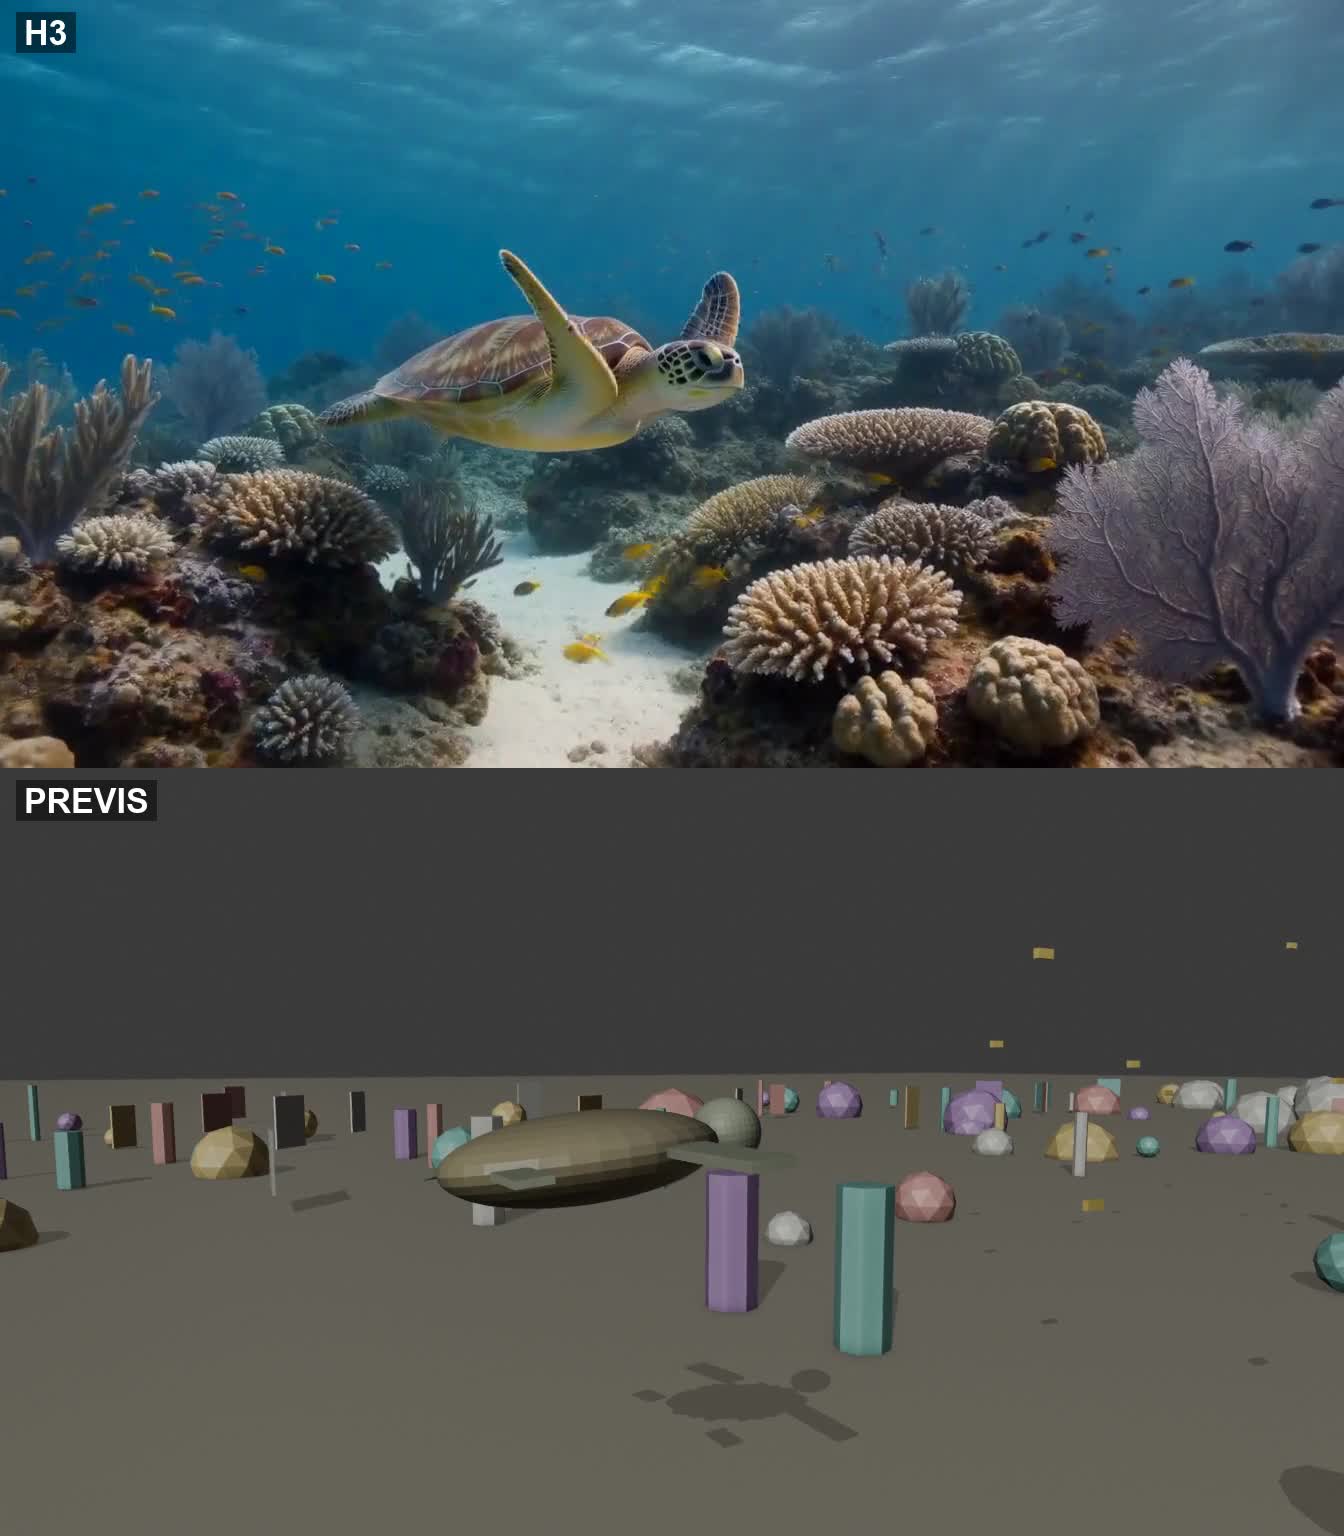
Meeresschildkröte unter Wasser
Aus einem groben Meeresboden und der Bewegung einer Meeresschildkröte entsteht eine Unterwasserlandschaft mit Licht und Korallen. Dieses Beispiel zeigt besonders anschaulich, wie die KI die Optik ergänzt.
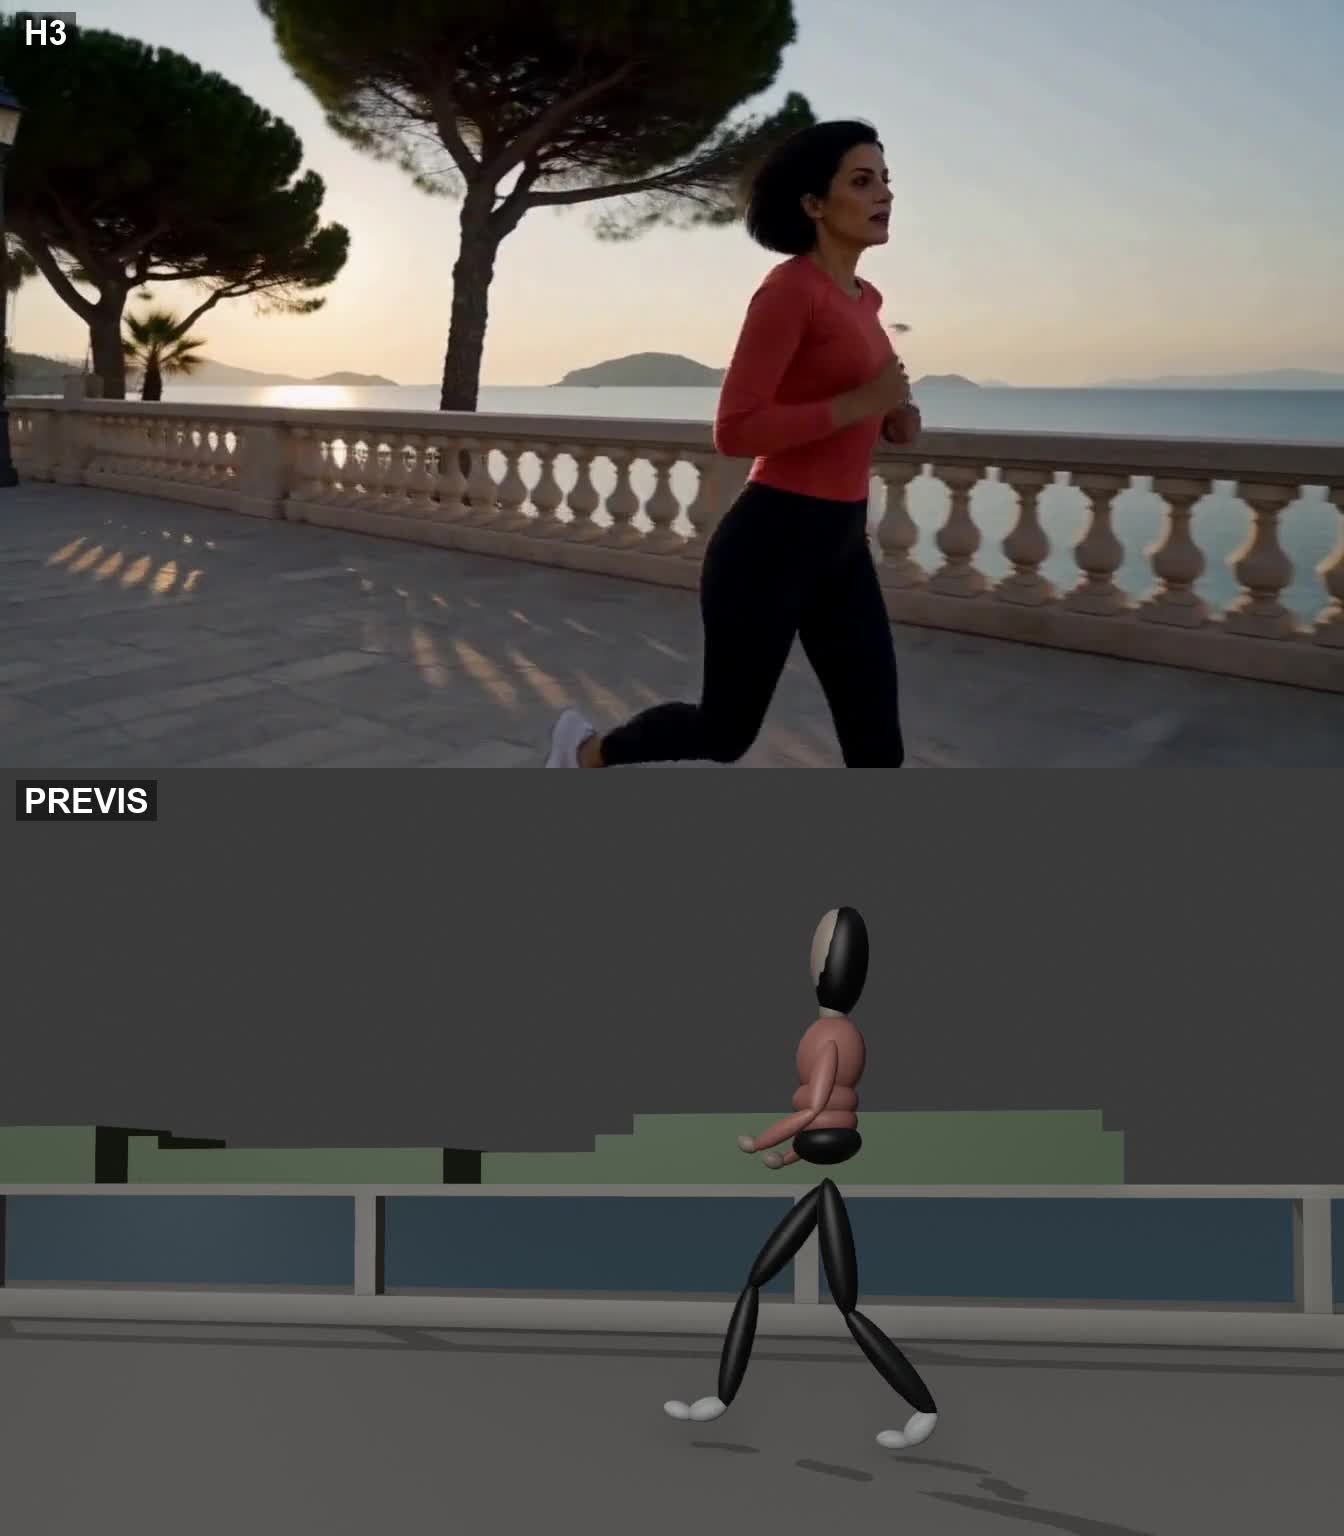
Laufen am Meer
Vorgegeben werden eine laufende Figur und die Kamerabewegung, die ihr folgt. Der grobe Hintergrund wird durch eine Promenade am Meer ersetzt.
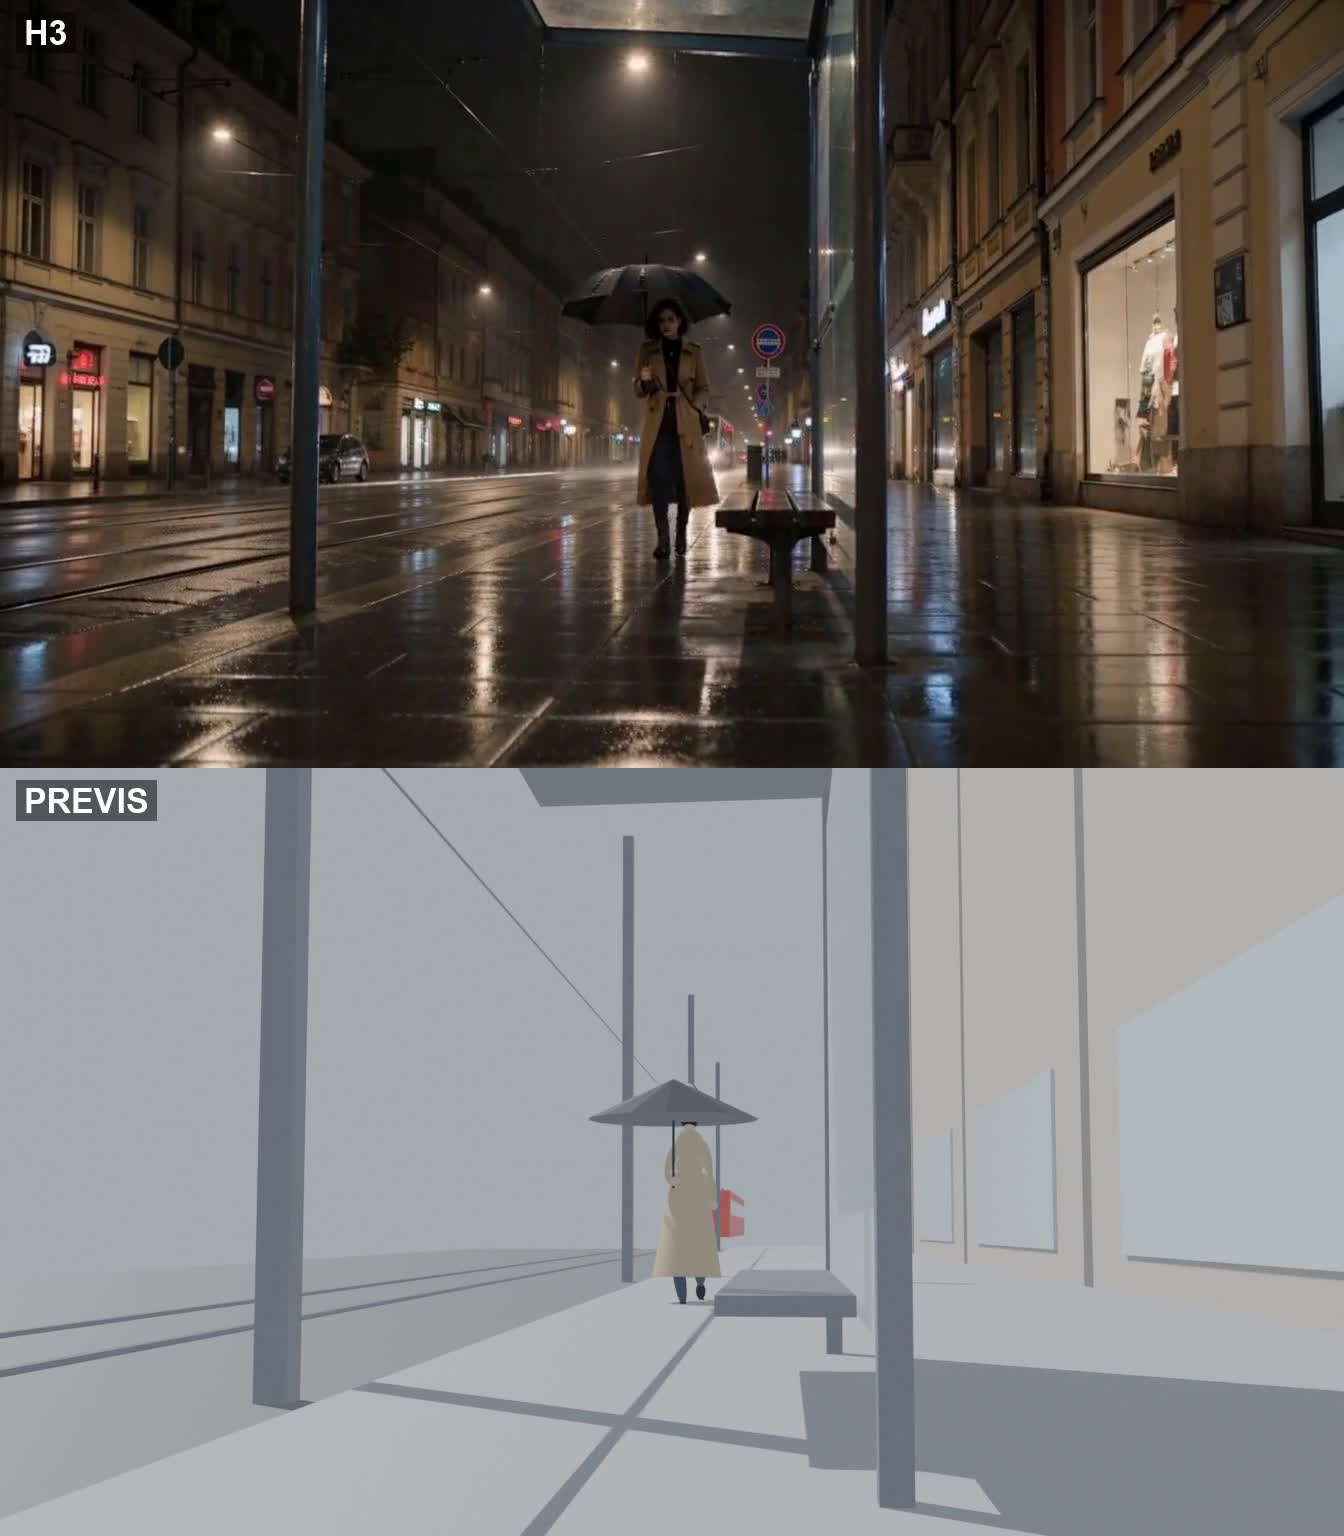
Regnerische Stadt mit Straßenbahn
Auf Grundlage der Anordnung einer Figur mit Regenschirm und einer Straßenbahn entsteht die Atmosphäre einer regnerischen Nacht.
Die Vorgehensweise ist einfach
Für diese Produktion bin ich wie folgt vorgegangen:
- Mit Python + Blender 4.2 eine Previs aus Boxen und einfachen Formen erstellen. Für die Bewegungen der Figuren kam auch Mixamo zum Einsatz.
- Mit Codex-Bildgenerierung Referenzbilder für Figuren und Ähnliches erstellen.
- Previs, Referenzbilder und Referenzaudio an MiniMax-H3 Ref2VA übergeben, um ein etwa 15 Sekunden langes Video zu generieren.
- Dialoge mit HiggsAudio v3, Soundeffekte mit Stable Audio 3 Medium und BGM mit ACE-Step 1.5 erstellen und mit ffmpeg mischen und bearbeiten. Für Produktionsskripte und die Ausführungsverwaltung habe ich Claude Code verwendet.
Der entscheidende Punkt bei den Anweisungen ist, die Rollen der Referenzen aufzuteilen: „Das Bild dient als Vorlage für Gesicht und Kleidung“, „die Previs für Anordnung, Bewegungen und Kameraführung“. Außerdem muss klargestellt werden, dass das Aussehen der Schaufensterpuppen und Boxen nicht übernommen werden soll. Die gewünschte Wirkung von Nacht, Regen und Beleuchtung habe ich textlich beschrieben.
Nutzbar, aber viele Details ändern sich
Die Anordnung der Figuren, Bewegungsrichtungen, Reihenfolge der Aktionen und die grobe Kamerabewegung lassen sich gut vermitteln. Präzise Vorgaben wie „nach wie vielen Sekunden anhalten“ oder „wie stark zoomen“ wichen dagegen ab oder wurden gar nicht umgesetzt. Details lassen sich also nicht exakt festschreiben.
Außerdem blieben mitunter flackerndes Licht aus der Previs oder zu regelmäßig angeordnete Hintergründe im generierten Ergebnis erhalten. Es scheint daher sinnvoll, Beleuchtung und Formen in der Previs einfach zu halten und sich auf die Bewegung zu konzentrieren, die vermittelt werden soll.
Trotzdem ist es praktisch, dass die KI aus groben Vorgaben ansehnliche Aufnahmen ergänzt. Details können sich zwar deutlich ändern, doch um den großen Rahmen der Inszenierung zu vermitteln, ist die Methode mehr als brauchbar. Man muss keine perfekt ausgearbeitete Previs erstellen; auch eine grobe Previs ist besser als keine, das ist mein Fazit aus diesem Versuch.